HPC 入门
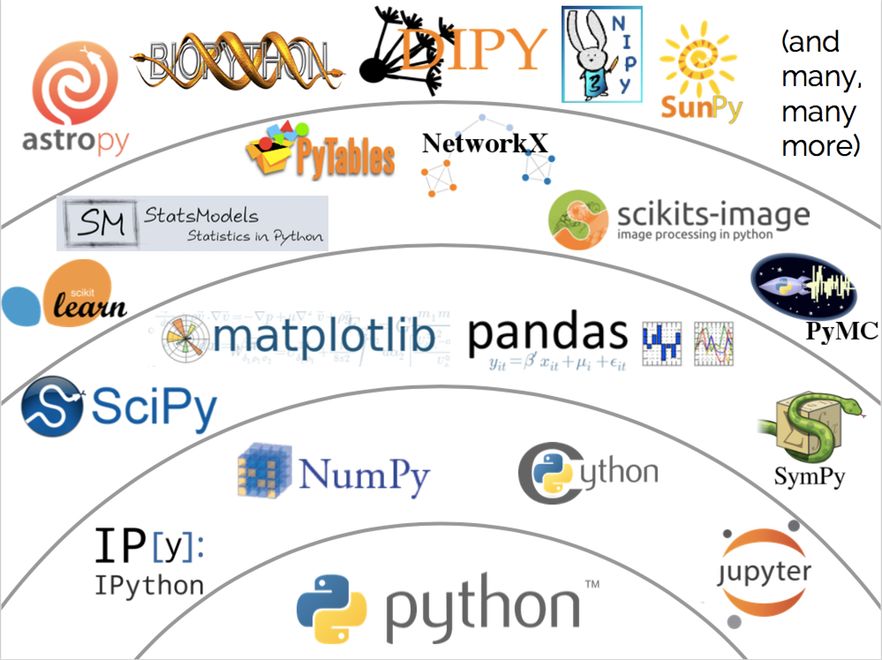
MLSys 软件栈:
- vllm | sglang | Megatron-LM | DeepSpeed | huggingface | ollama
- transformers | flash-attention | x-formers | accelerate
- scipy | sklearn | pytorch | tensorflow | jax | triton
- cpython | cython | numpy | cupy | cuda
- blas | openblas | mkl | cublas | lapack | eigen | libdivide
- openssl | sqlite | openmp | mpi …
CUDA 的线程组织结构: Device -> Grid -> Block (调度到某个 SM 上执行) -> Warp -> Thread
CUDA 的内存层次结构
- Thread 级别: Registers, Local Memory (位于 HBM 中, 用于 spilled register, 很慢)
- Block 级别: Shared Memory
- Device 级别: Global Memory, Constant Memory, Texture Memory
__global__修饰符用于声明在 GPU 上执行的函数, 返回 voidMPI 消息传递模型
OpenMP 共享内存模型
GPU
- GPU Die
- HBM stack, ~80GB
- Silicon Interposer: 封装内连接 GPU Die 和 HBM stack, 提供高带宽的通信
GPU Die
- SM, 100~150 个
- L2 Cache, 40~50MB
SM (Streaming Multiprocessor)
- 一个超宽 SIMD 单元 + 硬件多线程
- 一次发射 4 个 warp = 128 个 thread
- 能驻留的 warp 数量: 32~64 个
- CUDA Cores: 做通用计算, 64~128 个
- Tensor Cores: 做 MMA, 4 个
- 寄存器 SRAM: 256KB
- 内存 SRAM: 192/256 KB,shm 和 L1 共享
- Tensor Memory Accelerator: 类似 DMA 引擎, >=H100
Thread
- Thread 是最小的执行单元
- 每个 thread 有自己的寄存器和 local memory
- 每个 thread 有自己的 PC, 但同一个 warp 的 thread 共享指令流
- Volta 之前,一个 warp 的 thread 共享 PC
Warp
- Warp 是指令调度单元
- 32 个 thread 组成一个 warp
- 编程模型: SIMT (Single Instruction Multiple Threads)
- 同一个 warp 的 thread 执行同一条指令流, 如果控制流不同, 会退化成 Masked 串行执行 (divergence)
- Warp scheduler 负责调度 warp, 选择一个 warp 发射指令 + masked execution
Block
- Block 是资源分配,线程同步的单元
- 在同一 SM 上执行,分配 SM 的寄存器资源,共享 SM 的共享内存和 Barrier
Grid
- 一个 GPU 计算任务
- 一个 Grid 包含 gridDim.x * gridDim.y * gridDim.z 个 Block
- 每个 Block 包含 blockDim.x * blockDim.y * blockDim.z 个 thread
NVLink
- 用于连接多个 GPU, 提供高带宽的通信
- 有 Bridge、Cable、Switch 形态
Kernel 函数的特殊变量 / 特殊寄存器
gridDim: grid 的 block 数量, 整个 grid 相同 ->%nctaidblockDim: 每个 block 的线程数量, 整个 grid 相同 ->%ntidblockIdx: 当前 block 的坐标, 同一个 block 相同 ->%ctaidthreadIdx: 当前线程在 block 内的坐标, 每个线程不同 ->%tidwarpSize: warp 大小,当前通常是 32, 所有线程相同
Kernel 函数的调用语法
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
__device__ __forceinline__ rettype device_fn(arg1, arg2, ...) {
// impl
}
// __launch_bounds__(THREADS, BLOCKS): 告诉编译器该 kernel 启动时每 block 线程数一定不超过 THREADS,并希望一个 SM 能同时驻留至少 BLOCKS 个 block。编译器据此决定每线程寄存器数,必要时 spill 到 local memory。
__global__ void __launch_bounds__(THREADS, BLOCKS) kernel_fn(arg1, arg2, ...) {
// Grid 里的 Block 总数
int num_blocks = gridDim.x * gridDim.y * gridDim.z;
// 每个 Block 里的 Thread 数
int threads_per_block = blockDim.x * blockDim.y * blockDim.z;
// Grid 里的 Thread 总数
int total_threads = num_blocks * threads_per_block;
// Block 在 Grid 内的线性索引
int block_index = blockIdx.z * (gridDim.x * gridDim.y)
+ blockIdx.y * gridDim.x
+ blockIdx.x;
// Thread 在 Block 内的索引
int thread_local_index = threadIdx.z * (blockDim.x * blockDim.y)
+ threadIdx.y * blockDim.x
+ threadIdx.x;
// Thread 在 Grid 内的线性索引
int thread_global_index = block_index * threads_per_block + thread_local_index;
__shared__ float tile[32][32]; // 静态共享内存,大小在编译时确定
extern __shared__ float shared_mem[]; // 动态共享内存, 由 kernel launch 时指定大小
}
void launch_kernel() {
dim3 gridDim(128, 1, 1);
dim3 blockDim(16, 16, 4); // or (8, 8, 8)
// 启动一个任务,包含 128 个 Block, 每个 Block 1024 个 thread
// 为每个 block 分配 shmSize 的 Shared Memory, 在 stream 上执行
kernel_fn<<<gridDim, blockDim, shmSize, stream>>>(arg1, arg2, ...);
}如何避免 Local Memory
- cuobjdump,ncu 检测
- 避免 arr[i] 形式,常量循环尽量 unroll
- launch bound 中提高寄存器上限
- 大数组或结构体放进 shm
- 小函数加
__forceinline__, 避免栈帧开销 - 避免对局部变量或者局部数组取指针
线程同步
- Warp 内线程同步:
__syncwarp() - Block 内线程同步:
__syncthreads() - 主机等待设备工作完成:
cudaDeviceSynchronize()
- Warp 内线程同步:
流水线 (>= sm_80)
- 发起异步拷贝 global -> shm:
__pipeline_memcpy_async(dst, src, 4/8/16) - 把本线程已发起、尚未提交的拷贝标记为一个 batch:
__pipeline_commit() - 等待本线程 n 步以前的所有 batch 完成:
__pipeline_wait_prior(n)- 全 block 可见还需
__syncthreads()
- 全 block 可见还需
- 发起异步拷贝 global -> shm:
Tensor Core (warp 级单元, fragment 分布在 warp 32 个线程的寄存器中, 所有调用需整个 warp 一起执行)
- 定义累加器寄存器组:
wmma::fragment<wmma::accumulator, M, N, K, TAcc> acc[FM][FN]; - 定义操作数A寄存器组:
wmma::fragment<wmma::matrix_a, M, N, K, T, wmma::row_major> a_frag[FM]; - 定义操作数B寄存器组:
wmma::fragment<wmma::matrix_b, M, N, K, T, wmma::row_major> b_frag[FN]; - 初始化累加器寄存器组:
wmma::fill_fragment(acc[i][j], 0); - 加载 A:
wmma::load_matrix_sync(a_frag[m], &A_tile[stage][off_m][k], BK + SKEW); - 加载 B:
wmma::load_matrix_sync(b_frag[n], &B_tile[stage][k][off_n], BN + SKEW); - 执行 D = A @ B + C:
wmma::mma_sync(acc[i][j], a_frag[i], b_frag[j], acc[i][j]); - 存储结果:
wmma::store_matrix_sync(&C_tile[off_m][off_n], acc[i][j], BN + SKEW, wmma::mem_row_major);
- 定义累加器寄存器组:
warp divergence
- 一个 warp 内的多个 thread, 控制流不同, 导致的串行执行
- 解决方法:
- 分支条件对齐到 warp 边界
- 小 if-else 分支改写成 select
bank conflict
- Shared Memory 被划分为 32 个独立的 memory bank,按照 4 字节条带化的方式映射到 bank。
- 同一个 warp 内的多个 thread 访问同一个 bank 的不同地址时会被串行化,导致性能下降
- 访问同一地址会被广播,不冲突
- 解决方法:
- 调整 shm padding size,
__shared__ float tile[32][33]; - 每个 thread 访问不同的 bank (swizzle 访存)
- 调整 shm padding size,
如何确定开 thread 的数量?
- 先 launch 足够多的线程把 GPU 填满
- block 数取 SM 的倍数,并且 > SM num
- 每 block 线程数取 32 倍数,并且 > 128
- 再考虑让已有线程通过 stride 处理更多元素
- 先 launch 足够多的线程把 GPU 填满
树形 reduce 算法
- Warp 级别: shuffle xor sync, shuffle down sync
__shfl_{xor,up,down}_sync(mask, val, offset),warp 内的 thread 之间交换寄存器值
- Block 级别: 先 warp reduce, 结果写入 shm,再由 warp 0 聚合结果
- Warp 级别: shuffle xor sync, shuffle down sync
Cooperative Groups
- 线程组 API
Attention
- Flash Attention
- Paged Attention
- Block Attention
GPU 计算效率
- Model FLOPs Utilization (MFU)
- 每步模型有效 FLOPs / (每步耗时 × GPU 数量 × 单卡理论峰值 FLOP/s)
- Warp Occupancy
- 每个 SM 的驻留 warp 数 / 每个 SM 支持的最大 warp 数
- Model FLOPs Utilization (MFU)