[BSDCan'06] A Scalable Concurrent malloc(3) Implementation for FreeBSD 论文阅读
jemalloc 是 Jason Evans 开发的一款高性能通用内存分配器,起源于 2004 年的 Lyken 编程语言项目,后来因为性能出色,被移植到 FreeBSD 和 Firefox 项目中。
相对于先前的内存分配器,jemalloc 能够很好地支持多核 CPU 上的内存分配需求。
本文发表于 BSDCan 2006,作者 Jason Evans。论文原文:jemalloc.pdf
#摘要
FreeBSD 从第 5 版开始一直在持续改进对多处理器系统的可扩展支持,进展已经足够大,以至于 C 库的 malloc(3) 现在成了多处理器上多线程应用的潜在瓶颈。本文提出一种新的内存分配器,在现有技术的基础上为应用提供可扩展的并发分配。基准测试表明,使用该分配器时,多线程应用的内存分配随处理器数量增加而良好扩展;同时,单线程分配性能与之前的实现相当。
#1. 引言
FreeBSD 之前由 Kamp (1998) 实现的 malloc(3) 函数,通常被称为 phkmalloc,长期以来被认为是最佳实现之一,并在已发表的对比测试中表现出色(Feng 和 Berger, 2005;Berger 等人, 2000;Bohra 和 Gabber, 2001)。然而,phkmalloc 设计于多处理器系统尚不普及、多线程支持也不稳定的时期。FreeBSD 项目一直致力于在 SMP 系统上提供可扩展的性能,并已取得了显著进展,以至于 malloc(3) 已成为某些多线程应用程序的可扩展性瓶颈。本文提出了一种新的 malloc(3) 实现,非正式地称为 jemalloc。
表面上看,内存分配和释放似乎是一个简单的问题,只需要一些简单的记账工作来跟踪已用内存和可用内存即可。然而,数十年的研究和大量的分配器实现都未能产生一个明显更优的分配器。事实上,目前已知的衡量分配器性能的最佳实践非常简单,性能统计结果也同样如此。Wilson 等人 (1995) 对十年前的最新技术进行了精彩的回顾。当时多处理器并非一个重要问题,但除此之外,该回顾全面总结了现代分配器面临的问题。下文简要提及一些对 jemalloc 有特殊影响的问题,但并不试图讨论设计分配器时必须考虑的所有问题。
#性能评估
分配器的性能通常通过应用程序执行时间和平均或峰值内存使用量的组合来衡量。仅仅测量分配器代码本身的执行时间是不够的:由于 CPU 缓存、RAM 和虚拟内存分页的影响,内存布局会对应用程序其余部分的运行速度产生显著影响。现在普遍认为,合成的分配轨迹(synthetic traces)甚至不足以衡量分配策略对内存碎片的影响(Wilson 等人, 1995)。
衡量分配器性能的唯一确切方法是测量实际应用程序的执行时间和内存使用量。这给评估分配器的性能特征带来了挑战。例如,分配器在某些分配模式下的性能可能非常差,但如果基准测试应用程序都没有出现此类模式,那么即使它在某些工作负载下性能异常,看起来也可能表现良好。因此,使用多种应用程序进行测试至关重要。这也促使作者设计一种分配器,尽量减少退化边缘情况(degenerate edge cases)的数量和严重程度。
#内存碎片
碎片可以从内部碎片和外部碎片两个角度来理解:
- 内部碎片(internal fragmentation):单次分配中,由于无法使用的前导或尾随空间而浪费的内存。
- 外部碎片(external fragmentation):虚拟内存系统已经用物理内存支撑、但应用程序并未直接使用的空间。
这两种碎片对性能的影响各不相同,具体取决于应用程序的行为。理想情况下,两种碎片都应该尽可能少,但分配器必须做出一些权衡,这会影响每种碎片的出现程度。
#缓存局部性
过去十年,内存价格大幅下降,容量也更加充足。因此,phkmalloc 专门针对最小化工作页数(working set of pages)进行了优化,而 jemalloc 更关注缓存局部性,进而关注 CPU 缓存行的工作集。分页仍然可能导致性能显著下降(jemalloc 也考虑到了这一点),但如今更常见的问题是:相对于 CPU 的速度,从内存中获取数据存在巨大的延迟。
内存使用量更少的分配器并不一定具有更好的缓存局部性;不过当应用程序的工作集无法完全放入缓存时,把工作集紧凑地排列在内存中确实能提升性能。在相近时间点分配的对象往往也会被一起使用,因此,如果分配器能够连续分配对象,就有可能提高局部性。实际上,总内存使用量可以作为缓存局部性的一个合理代理指标:jemalloc 首先尝试最小化内存使用量,只有在不与此目标冲突的情况下才尝试连续分配。
#伪共享
现代多处理器系统以缓存行为单位维护内存的一致性视图。如果两个线程同时在不同的处理器上运行,并且操作位于同一缓存行中的不同对象,则处理器必须争夺该缓存行的所有权(图 1)。这种缓存行的伪共享(false sharing)会导致严重的性能下降。
一种解决方法是对内存分配做填充(padding),但填充与"尽可能紧凑地放置对象"的目标背道而驰,会导致严重的内部碎片。jemalloc 则依靠多个分配区(arena)来缓解这个问题,并把填充的任务留给应用程序编写者,由他们在性能关键的代码中,或在"一个线程分配对象、再传递给多个其他线程"的代码中自行避免伪共享。
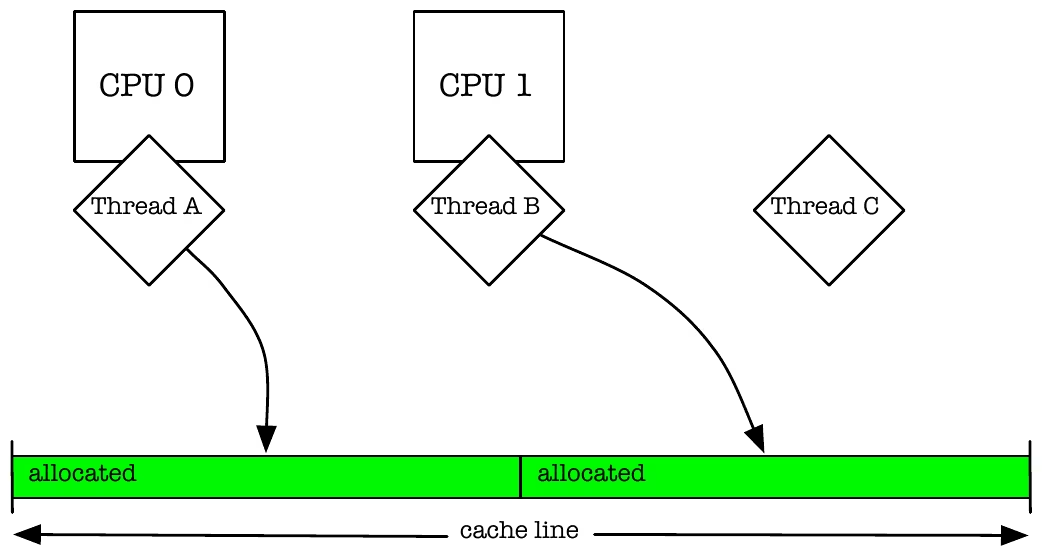
图 1:两个被不同线程使用的内存分配共享物理内存缓存中的同一条缓存行(伪共享)。如果这两个线程同时修改这两个内存分配,则处理器必须争夺该缓存行的所有权。
#锁争用
该分配器的主要目标之一,是减少运行在多处理器系统上的多线程应用程序的锁争用。Larson 和 Krishnan (1998) 在提出和测试相关策略方面做了非常出色的工作。他们尝试将锁下推到分配器内部:不再使用单个全局分配器锁,而是每个 free list 一个锁。这在一定程度上有所帮助,但即使锁争用已经极少,扩展性仍然不足。他们将此归因于"缓存晃动"(cache sloshing)——在操作分配器数据结构期间,缓存数据在处理器之间快速迁移。
他们的解决方案是使用多个分配区(arena),并通过线程标识符的哈希值将线程分配到各个分配区(图 2)。这种方法效果显著,并已被其他实现所采用(Berger 等人, 2000;Bonwick 和 Adams, 2001)。jemalloc 也使用了多个分配区,但采用了一种比哈希更可靠的机制来将线程分配到各个分配区。
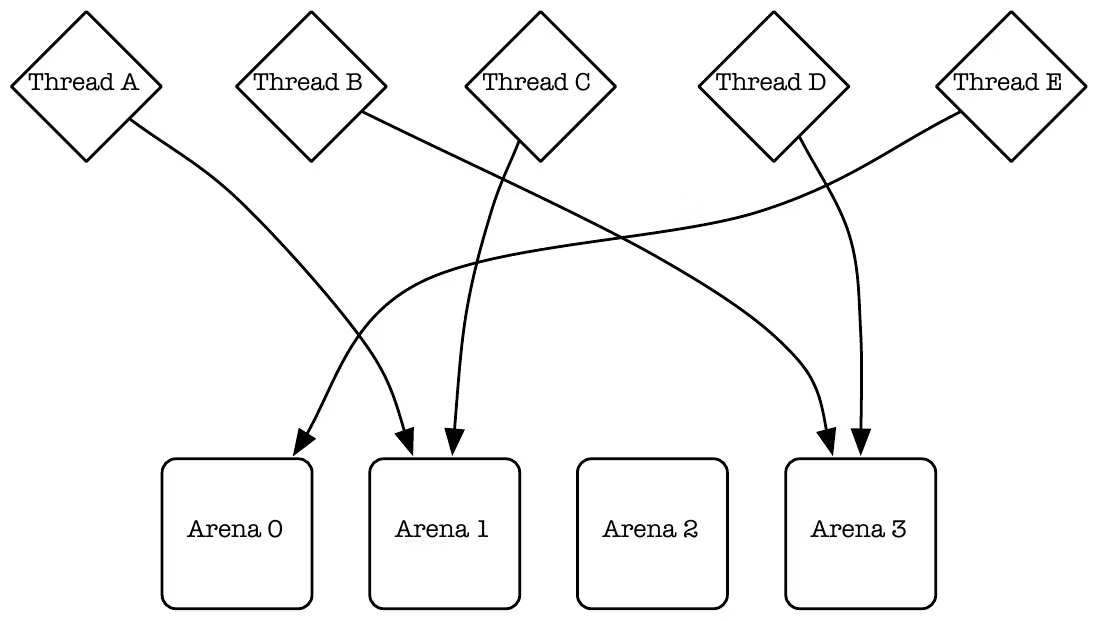
图 2:Larson 和 Krishnan (1998) 对线程标识符做哈希,从而把线程永久地分配到某个 arena。这是一个伪随机过程,因此无法保证各个 arena 被均匀使用(图中 Arena 2 没有分到任何线程,而 Arena 1 和 Arena 3 各分到两个)。
本文接下来介绍 jemalloc 的主要算法和数据结构,给出在多处理器系统上测量多线程应用性能与扩展性、以及单线程应用性能与内存用量的基准测试,并讨论内存碎片的测量方法。
#2. 算法与数据结构
#运行时配置
FreeBSD 支持通过三种方式在运行时配置分配器:/etc/malloc.conf 符号链接、MALLOC_OPTIONS 环境变量,或 _malloc_options 全局变量。这是一种低开销、非侵入式的配置机制,对调试和性能调优都很有用。jemalloc 沿用了这一机制,既支持 phkmalloc 原有的各种调试选项,也用它暴露各种与性能相关的参数。
#Arena 与线程绑定
每个应用程序在运行时被配置为拥有固定数量的 arena。默认情况下,arena 的数量取决于处理器数量:
- 单处理器:所有分配共用一个 arena。这时使用多个 arena 没有意义,因为分配器内部只有在线程于分配过程中被抢占时才可能出现争用。
- 多处理器:arena 数量为处理器数量的 4 倍。把线程分散到一组 arena 上,可以降低单个 arena 被并发使用的概率。
线程第一次分配或释放内存时,会被绑定到一个 arena。与哈希线程唯一标识符不同,jemalloc 以 round-robin 方式选择 arena,从而保证每个 arena 被分配到的线程数大致相同。可靠地对线程标识符做伪随机哈希是出了名的困难(实践中这些标识符是指针),这正是最终促成这一做法的原因。线程之间仍然可能争用同一个 arena,但平均而言,初始分配不可能比 round-robin 做得更好。动态再平衡(dynamic re-balancing)也许能进一步减少争用,但所需的记账开销很高,而且很少能带来足以抵消开销的收益。
线程局部存储(TLS)对 round-robin 的高效实现很重要,因为每个线程的 arena 绑定需要存储在某个地方。非 PIC 代码和某些体系结构不支持 TLS,在这些情况下分配器退回到线程标识符哈希。pthreads 库提供的线程特定数据(TSD)机制(Butenhof, 1997)本可作为 TLS 的替代方案,但 FreeBSD 的 pthreads 实现会在内部分配内存,如果分配器使用 TSD 就会导致无限递归。
#Chunk
通过 sbrk(2) 或 mmap(2) 从内核申请的所有内存,都以 chunk 大小的整数倍进行管理,并保证 chunk 的基地址总是 chunk 大小的整数倍(图 3)。这种对齐使得可以在常数时间内算出任一分配所属的 chunk(把指针的低位清零即可)。chunk 通常由特定的 arena 管理,维护好这种归属关系对分配器的正确性至关重要。默认 chunk 大小为 2 MB。
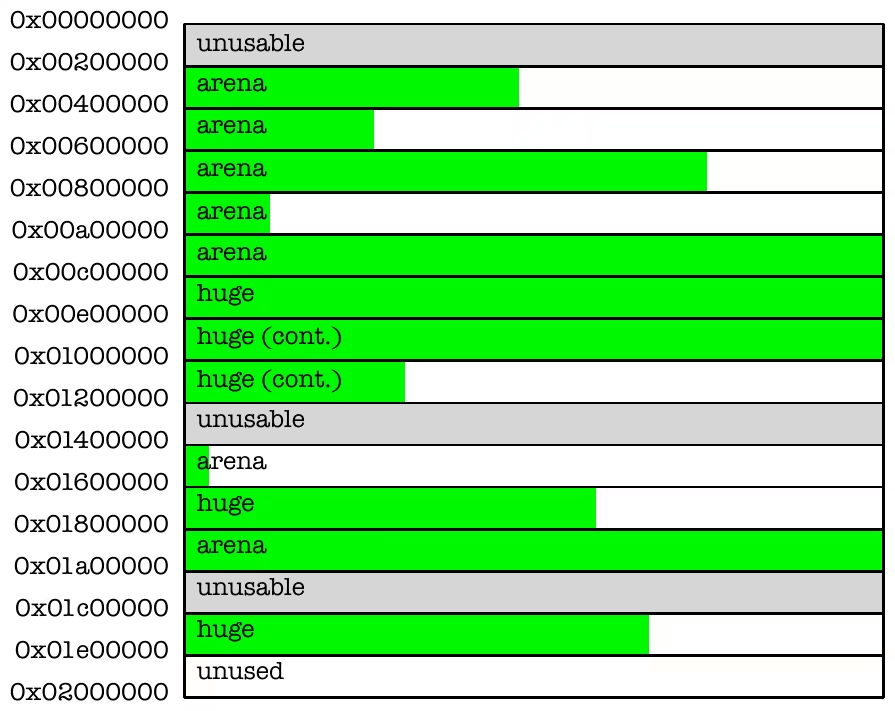
图 3:所有 chunk 大小相同,且起始于 chunk 对齐的地址。arena 把 chunk 切分成更小的分配,而 huge 分配则直接由一个或多个连续的 chunk 承载。
#尺寸分类
分配的尺寸类别(size class)分为三大类:small、large 和 huge。所有分配请求都会向上取整到最近的尺寸类别边界。
- Huge:大于半个 chunk 的分配,直接由专用的 chunk 承载。所有 huge 分配的元数据存放在一棵红黑树中。由于大多数应用很少(甚至从不)进行 huge 分配,使用单棵树并不会成为扩展性问题。
- Large:大于半页、但不超过半个 chunk 的分配,直接独占一个 page run。
- Small:不超过半页的分配,多个对象共享一个 run。
对于 small 和 large 分配,chunk 使用二进制伙伴算法(binary buddy algorithm)切分为若干页组成的 run。run 可以反复对半分裂,最小到一页;合并时只能按照分裂的逆过程进行。run 的状态信息以 page map 的形式存放在每个 chunk 的开头。由于这些信息与 run 本身分开存放,页面只有在真正被使用时才会被访问到。这也使得可以把整个 run 专门用于 large 分配。
small 分配又分为三个子类别:tiny、quantum-spaced 和 sub-page。现代体系结构会根据数据类型对指针施加对齐约束,而 malloc(3) 必须返回满足任意用途对齐要求的内存。这个最坏情况下的对齐要求在文中称为 quantum(通常为 16 字节)。实践中,tiny 分配使用 2 的幂对齐就足够了,因为它们小到不可能容纳需要 quantum 对齐的对象。
| 类别 | 子类别 | 尺寸 |
|---|---|---|
| Small | Tiny | 2 B, 4 B, 8 B |
| Quantum-spaced | 16 B, 32 B, 48 B, …, 480 B, 496 B, 512 B | |
| Sub-page | 1 kB, 2 kB | |
| Large | 4 kB, 8 kB, 16 kB, …, 256 kB, 512 kB, 1 MB | |
| Huge | 2 MB, 4 MB, 6 MB, … |
图 4:默认尺寸类别(假设使用运行时默认值、4 kB 页面和 16 字节 quantum)。
如果去掉 quantum-spaced 尺寸类别,small 分配就无需再细分子类别,实现会更简单。但大多数应用主要分配小于 512 字节的对象,按 quantum 间隔划分尺寸类别能显著降低平均内部碎片。更多的尺寸类别可能会增加外部碎片,但实践中内部碎片的减少通常足以抵消外部碎片的增加。
#Run 与区域位图
small 分配按尺寸类别隔离:每个 run 只管理一种尺寸类别。每个 run 的开头存放一个区域位图(region bitmap),相比其他方法有以下优点:
- 可以快速扫描位图找到第一个空闲区域,从而让已用区域紧凑排列。
- 分配器数据和应用数据彼此分离。这降低了应用破坏分配器数据的可能性,也可能提高应用数据的局部性,因为分配器数据不会与应用数据混在一起。
- 容易支持 tiny 区域。如果把 free list 嵌入空闲区域中(例如 dlmalloc 的做法),就很难支持只有 2 字节的区域。
run header 有一个潜在问题:它占用了本可直接给应用使用的空间。对于大于 run header 的尺寸类别,这可能导致明显的外部碎片。为了限制外部碎片,除了最小的几个尺寸类别外,其余都使用多页 run。这样一来,即便对于 small 中最大的尺寸类别(通常是 2 kB 区域),外部碎片也被限制在约 3%。
#Run 满度分级
由于每个 run 能管理的区域数量有限,每个尺寸类别必须支持多个 run。在任意时刻,每个尺寸类别最多只有一个"当前"(current)run。当前 run 会一直保持当前状态,直到它完全填满或完全清空。
但请注意:如果没有任何迟滞机制(hysteresis),一次 malloc/free 就可能导致一个 run 被创建/销毁(在边界上来回抖动)。为避免这种情况,run 按照满度的四分位数(quartile)进行分级,处于 QINIT 级别的 run 永远不会被销毁。一个 run 要被销毁,必须先晋升到更高的满度级别(图 5)。
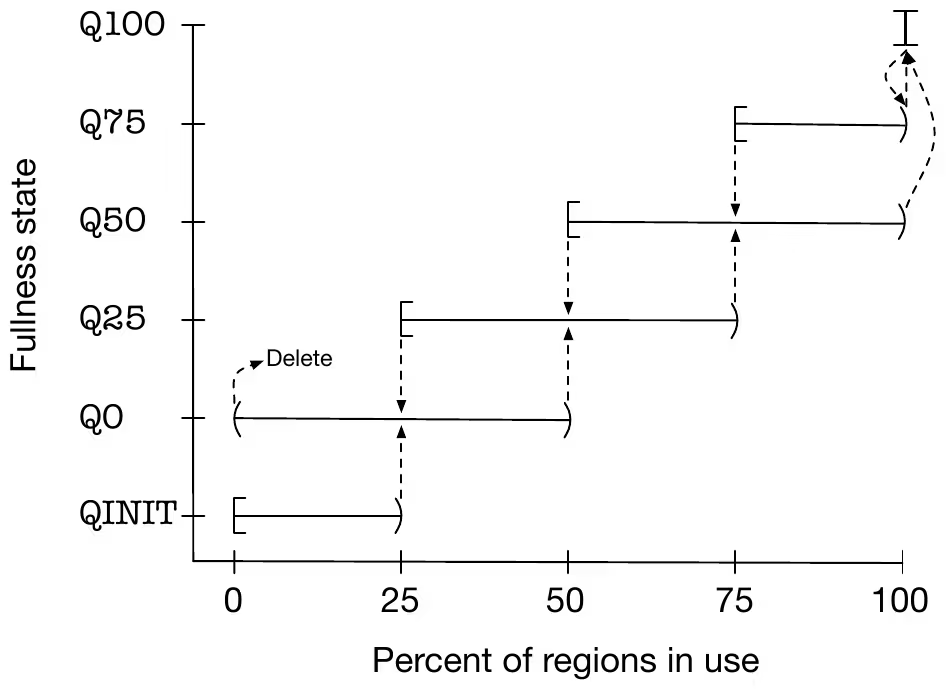
图 5:run 根据满度分级,当满度增加/减少越过不同阈值时在各状态间迁移。run 从
QINIT状态开始,在Q0状态下变空时被删除。
从图中可以看出,各级别覆盖的区间是相互重叠的(如 Q0 覆盖 0%–50%,Q25 覆盖 25%–75%),只有越过区间边界才会迁移,这就是迟滞的来源。
满度分级还提供了从非满 run 中选择新的当前 run 的机制,优先顺序为:Q50、Q25、Q0,最后才是 Q75。Q75 排在最后,是因为这类 run 可能几乎已满,经常选择它们会导致当前 run 频繁更替。
#3. 实验
为了量化 jemalloc 相对于 phkmalloc 的扩展性,作者在一台四处理器系统(双路双核 Opteron 275)上,使用 FreeBSD-CURRENT/amd64(2006 年 4 月)运行了两个多线程基准和五个单线程基准。作者在测试前调研了若干其他线程安全的分配器,但由于各种可移植性问题,最终只纳入了 Doug Lea 的 dlmalloc。作者修改了 dlmalloc 2.8.3,使其能集成进一个自定义 libc,并像 phkmalloc 和 jemalloc 一样使用基于 libc 的自旋锁同步。所有基准都通过 LD_PRELOAD 机制选择所用的分配器实现。由于 libpthread 存在一个在论文撰写时尚未解决的线程切换性能问题,所有基准都使用 libthr 而非 libpthread。
需要注意的是,dlmalloc 并不是为多线程程序设计的可扩展分配器。它出现在所有基准中是为了完整性,但纳入它的主要目的是用于单线程基准对比。
#多线程基准
#malloc-test
malloc-test 是 Lever 和 Boreham (2000) 编写的微基准,用于测量多线程应用下分配器扩展性的上限。它在一个或多个线程中执行紧凑的分配/释放循环。在多处理器系统上,理想情况下分配器吞吐量应随线程数线性增长,直到线程数等于处理器数,之后随线程数继续增加而保持不变。结果见图 6。
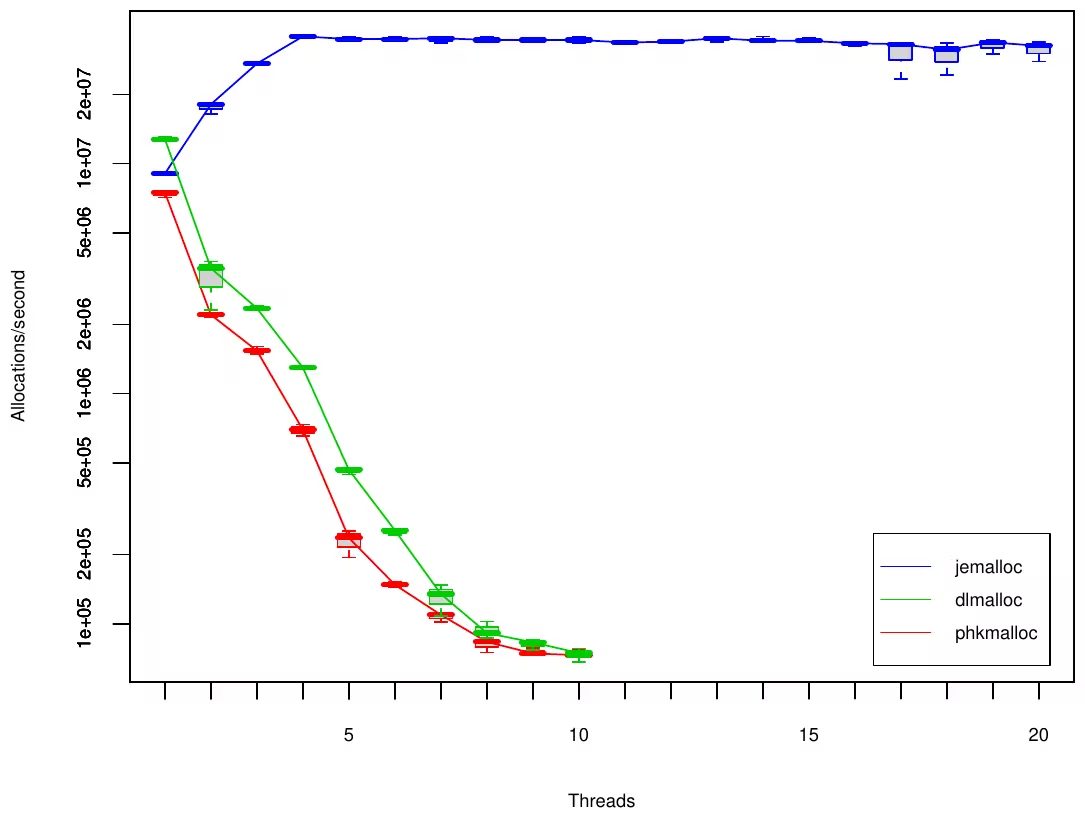
图 6:随线程数增加的分配器吞吐量(allocations/second,对数纵轴)。每次运行共执行 40,000,000 次分配/释放循环,平均分给各线程,每次循环创建一个 512 字节的对象。每种配置重复 3 次,用箱线图汇总,中线为中位数,须线为测得的极值。
- phkmalloc 和 dlmalloc 只要使用超过一个线程,性能就严重下降,并且随线程数增加持续急剧恶化。由于运行时间过长,这两者没有给出超过 10 个线程的结果。
- jemalloc 在 4 个线程以内几乎完美线性扩展,之后保持基本恒定,但在超过 16 个线程时出现了一个有趣的例外:jemalloc 在四处理器系统上默认使用 16 个 arena,所以至少要有 17 个线程运行时才会出现明显争用。超过 16 个线程后,部分线程会争用同一个 arena;当其他线程结束后,这些争用 arena 的线程会一直表现出最差性能,直到它们完成。
#super-smack
第二个多线程基准使用数据库压测工具 Super Smack 1.3,它运行一个或多个客户端线程访问服务器(这里是 MySQL 5.0.18)。Super Smack 自带两个预配置的负载测试,作者使用了其中的 select-key.smack。每次运行约执行 200,000 次查询(图 7 的图注写的是约 100,000 次,原文前后不一致),平均分配给各客户端线程。
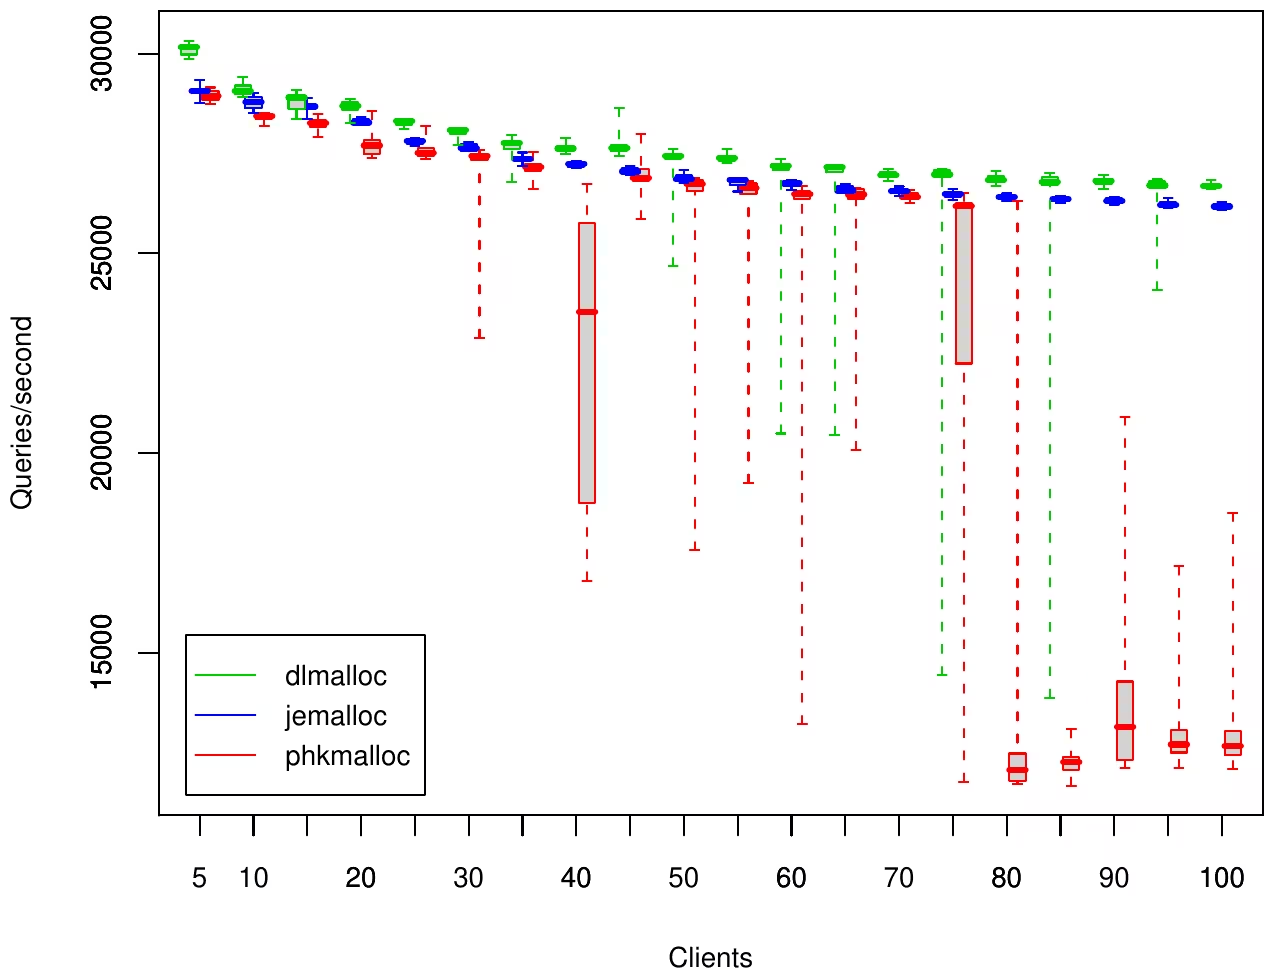
图 7:随客户端线程数增加的 MySQL 查询吞吐量(queries/second)。每种配置重复 10 次,用箱线图汇总。
- jemalloc:随客户端线程数增加,性能平缓下降,波动很小,尤其是最差情况下的性能。
- phkmalloc:中位数性能通常与 jemalloc 相当,但最差情况的波动极大;此外,在 75 到 80 个客户端线程之间性能会突然急剧下降。
- dlmalloc:平均表现不错,但和 phkmalloc 一样,最差情况的波动极大。
#单线程基准
作者测试了五个单线程程序。总的来说,这些结果应当谨慎看待:作者花了很大力气才找到能稳定复现、且运行时间差异显著的测试。大多数真实程序的运行时间根本不显著依赖 malloc 性能;此外,大量使用网络或文件系统的程序运行时间波动很大,需要大量重复才能判断结果是否显著。因此这里存在固有的选择偏差,这些基准不应被解读为代表任何特定类别的程序。
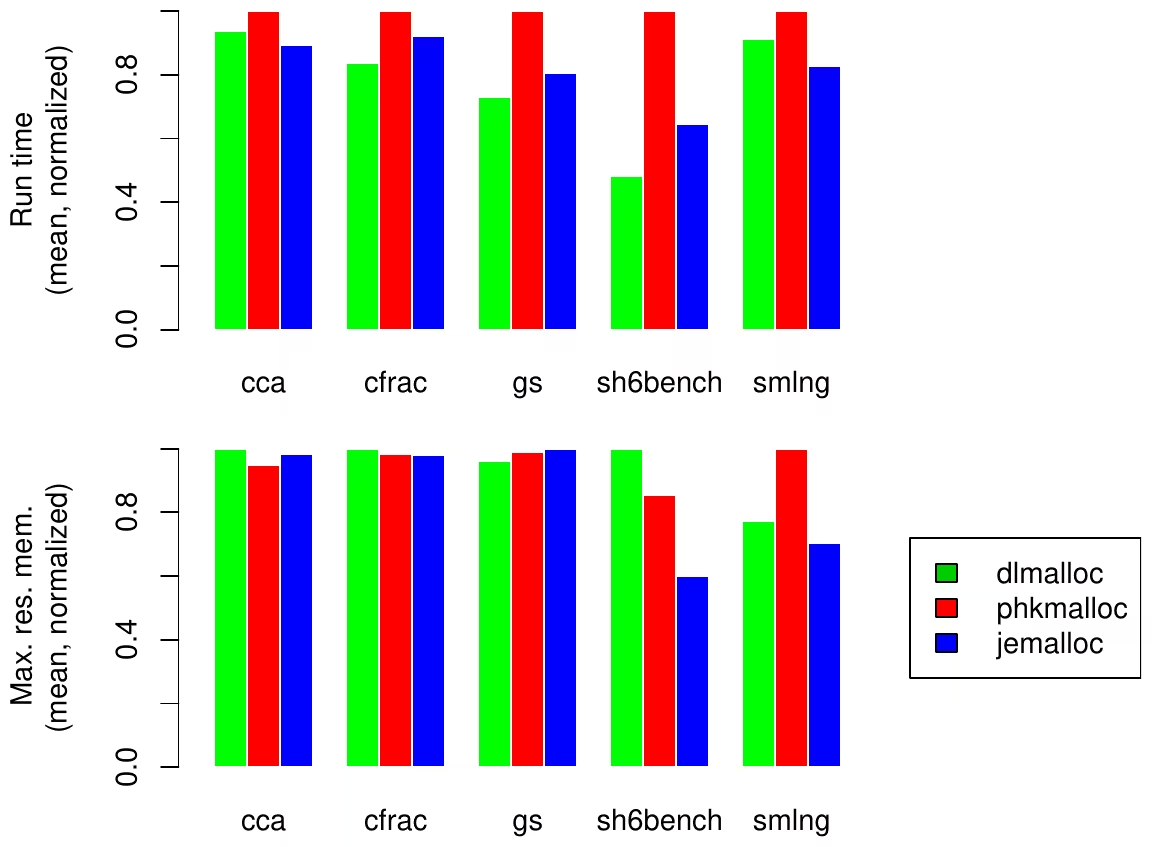
图 8:五个单线程程序的归一化运行时间和最大常驻内存。每张图线性缩放,使最大值为 1.0。
| 基准 | 指标 | dlmalloc | phkmalloc | jemalloc |
|---|---|---|---|---|
| cca(3 次) | 运行时间 | 72.88 s | 77.73 s | 69.37 s |
| 最大常驻内存 | 11244 kB | 10681 kB | 11045 kB | |
| cfrac(10 次) | 运行时间 | 9.57 s | 11.45 s | 10.55 s |
| 最大常驻内存 | 2105 kB | 2072 kB | 2064 kB | |
| gs(3 次) | 运行时间 | 31.06 s | 42.48 s | 34.24 s |
| 最大常驻内存 | 15001 kB | 15464 kB | 15616 kB | |
| sh6bench(10 次) | 运行时间 | 3.35 s | 6.96 s | 4.50 s |
| 最大常驻内存 | 105467 kB | 90047 kB | 63314 kB | |
| smlng(10 次) | 运行时间 | 12.65 s | 13.89 s | 11.49 s |
| 最大常驻内存 | 71987 kB | 93320 kB | 65772 kB |
#cca
cca 是一个 Perl 脚本,大量使用正则表达式从 C 代码中提取 cpp 逻辑,并生成各种统计信息和 cpp 逻辑的 PostScript 图。实验中作者把 FreeBSD libc 的所有 .c 和 .h 文件拼接起来作为 cca 的输入,使用 ports 中的 Perl 5.8.8,并编译为使用系统 malloc。
#cfrac
cfrac 是一个分解大整数的 C 程序,随 Hoard 内存分配器一起发布。输入为 47582602774358115722167492755475367767。
cfrac 绝大多数分配是 16 和 32 字节的对象,但总体内存用量不高。dlmalloc 内存用量略高,很可能是因为它对小对象的内部碎片更大。
#gs
gs(GhostScript)是一个 PostScript 解释器。作者使用 ports 中的 AFPL GhostScript 8.53,输入为一个 37 MB 的文件,运行方式为:
1 | gs -dBATCH -dNODISPLAY PS3.ps |
gs 内部使用了自定义分配器,因此绝大多数分配要么是 240 字节的对象,要么是大对象,这个基准主要考验大对象分配的性能。
- phkmalloc 似乎因内存用量的大幅波动而承受了系统调用开销,而其他两个分配器内置了更多迟滞,减少了系统调用总数。
- jemalloc 不如 dlmalloc,是因为它需要额外管理 run,而 dlmalloc 只是直接调用
mmap()。
#sh6bench
sh6bench 是 MicroQuill 的一个微基准。它反复分配成组的等大对象,每轮保留其中一部分,按不同顺序释放其余对象。小对象每组的数量多于大对象,因此整体偏向小对象分配。
作者修改了 sh6bench,在每次 malloc() 后立即调用 memset(),以确保所有分配的内存都被访问过。每次运行配置为 2500 次迭代,对象大小从 1 到 1000。
- 该微基准中的分配实际上并不被"使用",这让 jemalloc 相比 dlmalloc 吃亏:jemalloc 每次分配/释放都要访问 run 的区域位图,如果应用并不真正使用这些内存,jemalloc 的缓存局部性就会变差。但现实中分配内存后只访问一次是不现实的;而且 jemalloc 实际上能改善应用的缓存局部性,因为它的位图不会像 dlmalloc 的区域头那样把区域隔开。
- 如引言所述,合成轨迹对衡量分配器性能用处不大,sh6bench 也不例外。三个分配器之间巨大的内存用量差异很难解读。
#smlng
smlng 是一个 Onyx 程序,为 ICFP 2001 编程竞赛实现了一个 SML/NG 解析器和优化器。作者使用 Onyx-5.1.2 的单线程构建,输入是反复拼接各种 SML/NG 示例和测试用例得到的 513 kB 文件。
- jemalloc 内存用量低于 phkmalloc,因为主要使用的尺寸并非都是 2 的幂:16、48、96 和 288 字节(phkmalloc 的小对象尺寸类别都是 2 的幂,48 会被向上取整到 64,内部碎片更大)。
- jemalloc 在内存用量波动时也能很好地回收区域,而 dlmalloc 由于该分配模式而产生了一些外部碎片。
#4. 分析
对分配器进行穷尽的基准测试是不可行的,以上结果在任何意义上都不应被视为定论。分配器性能对应用的分配模式高度敏感,完全可以构造出让三个分配器中任何一个显得很好或很差的微基准。作者尽力避免这种结果倾斜,但读者不应假定作者是客观的。尽管如此,这些基准至少足以说明:
- jemalloc 在多处理器系统上运行多线程程序时,运行时性能扩展良好。
- 对于单线程程序,jemalloc 在运行时间和内存用量上都与 phkmalloc、dlmalloc 相当。
事实上,jemalloc 在这些基准中表现非常好,作者也没有发现任何理由怀疑 jemalloc 会在除专门构造的微基准之外的场景中明显差于 phkmalloc 或 dlmalloc。
这些基准都没有测试内存压力下的性能。这类基准值得研究,但作者没有纳入,主要因为 phkmalloc 已被证明在内存压力下表现良好(Kamp, 1998;Feng 和 Berger, 2005),而 jemalloc 使用了足够相似的算法,应当表现相近。
碎片很难分析,因为它主要是一个定性问题,而标准工具只提供定量指标。最大常驻内存对分析碎片的作用有限,因为不同分配器之间的差异只反映了内存用量峰值那一刻的碎片差异。显然,一个分配器完全可能在不明显影响最大常驻内存的情况下,让应用的数据局部性变差很多。
为了更好地理解碎片,作者编写了一个程序,处理通过 malloc(3) 的 U 选项配合 ktrace(1) 生成的 kdump(1) 输出,并绘制内存使用图(图 9)。借助这个程序,作者观察了不同布局策略的效果,并因此让 jemalloc 的内存使用效率比早期开发版本高出许多。
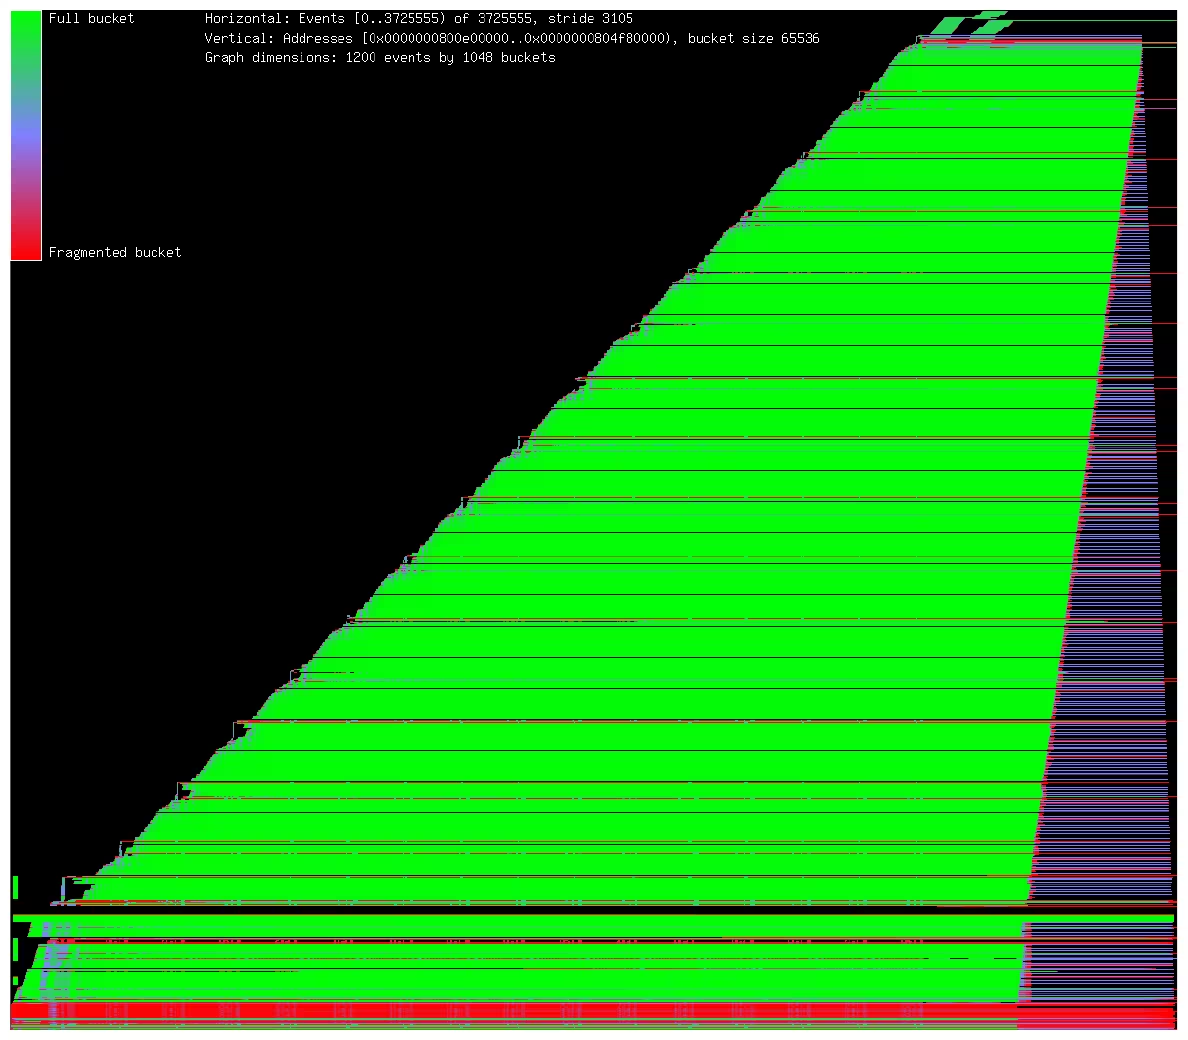
图 9:在 amd64 上运行 smlng 基准时的内存使用图。横轴上的每个位置代表某一时刻的内存快照,时间以分配事件为离散单位;纵轴上的每个位置代表一段内存地址范围,颜色表示该范围被使用的比例(绿色为满,红色为碎片化)。
理解分配器在各种分配模式下的行为始终是一个挑战。无论是在分配器开发还是应用开发过程中,能够洞察分配器实际在做什么的机制都很重要。为此,如果在编译 libc 时启用了可选代码,并指定 malloc(3) 的 P 选项,jemalloc 会在进程退出时输出详细的统计信息。下面是运行 cca 基准时的输出(中间部分 bin 已省略):
1 | ___ Begin malloc statistics ___ |
几个值得注意的点:
- 4 核机器上
Number of arenas: 16,对应"arena 数 = 4 × CPU 数"。 run_sz随尺寸类别增大而增大(4 kB → 64 kB),这就是前面说的"多页 run",用来摊薄 run header 的开销。npromo/ndemo是 run 在满度级别之间晋升/降级的次数。8 字节的 bin 请求了 6400 多万次,但只创建了 9318 个 run,这正是满度分级的迟滞在起作用。
#5. 讨论
开发 jemalloc 时一个持续的困扰是:即使是看似无害的附加功能,比如维护每个 arena 已分配内存总量的计数器,或者任何一次除法运算,都会带来可测量的性能下降。这个分配器最初的功能比最终保留下来的多得多。被移除的功能包括:
malloc_stats_np():仅仅是加一个每 arena 的已分配内存计数器,就会带来可测量的性能影响。因此,所有统计收集在编译时默认关闭。既然统计信息不一定可用,提供 C API 也就没什么用了。- 各种合法性检查:即便是简单的检查代价也很高,因此默认只实现 API 合规所必需的最少检查。
好的一面是,运行时配置机制被证明非常灵活,且不会带来显著的性能影响。
分配器的设计与实现很容易成为让人痴迷一生的课题,也确实有人专门研究这个方向。部分魅力在于:没有任何一个分配器在所有可能的分配模式下都是最优的,因此随着新软件引入新的分配模式,总有可以微调的地方。作者希望 jemalloc 足够灵活,能在未来许多年里服务 FreeBSD。phkmalloc 已经为 FreeBSD 服务了十多年,jemalloc 要接过的担子不轻。
#6. 可用性
jemalloc 源码是 FreeBSD libc 的一部分,以两条款的类 BSD 许可证发布。
#读后总结
这篇论文篇幅不长,但奠定了 jemalloc 后续十几年的基本架构:
| 设计 | 解决的问题 |
|---|---|
| 多 arena(4 × CPU) + round-robin 绑定 | 锁争用、cache sloshing、伪共享;比哈希更均匀 |
| 2 MB 对齐的 chunk | 由指针 O(1) 找到所属 chunk / arena |
| small / large / huge 三级尺寸分类 + quantum 间隔 | 降低小对象内部碎片 |
| 元数据与数据分离(page map、run 位图) | 防止应用越界破坏元数据;只在使用时才触碰页面 |
| 多页 run | 摊薄 run header 带来的外部碎片(≤ 3%) |
| run 满度四分位分级 + 迟滞 | 避免 run 在边界上频繁创建/销毁 |
值得一提的是,这一版 jemalloc 还没有线程缓存(tcache),每次分配仍要获取 arena 锁,只是靠多 arena 把争用摊薄。后续版本陆续引入了 tcache、更细粒度的尺寸类别,并在 jemalloc 5 中用 extent 取代了 chunk + buddy 的设计,但"多 arena + 按尺寸类别隔离 + 元数据分离"的核心思想一直延续至今。
#参考文献
- Berger ED, McKinley KS, Blumofe RD, Wilson PR (2000) Hoard: A Scalable Memory Allocator for Multithreaded Applications. ASPLOS 2000
- Bohra A, Gabber E (2001) Are Mallocs Free of Fragmentation? USENIX 2001 Annual Technical Conference: FREENIX Track
- Bonwick J, Adams J (2001) Magazines and Vmem: Extending the Slab Allocator to Many CPUs and Arbitrary Resources. USENIX ATC 2001
- Butenhof DR (1997) Programming with POSIX Threads. Addison–Wesley
- Feng Y, Berger ED (2005) A Locality-Improving Dynamic Memory Allocator. MSP
- Kamp PH (1998) Malloc(3) revisited. USENIX 1998 Annual Technical Conference: Invited Talks and FREENIX Track, 193–198
- Larson P, Krishnan M (1998) Memory Allocation for Long-Running Server Applications. ISMM 1998, 176–185
- Lever C, Boreham D (2000) malloc() Performance in a Multithreaded Linux Environment. USENIX 2000 Annual Technical Conference: FREENIX Track
- Wilson PR, Johnstone MS, Neely M, Boles D (1995) Dynamic Storage Allocation: A Survey and Critical Review. International Workshop on Memory Management 1995