[MSR-TR'19] Mimalloc: Free List Sharding in Action 论文阅读
mimalloc 是微软研究院 Daan Leijen 等人开发的通用内存分配器,最初是为 Lean 定理证明器和 Koka 语言的运行时设计的。这两种语言都是函数式语言,会进行大量小而短命的分配,并使用引用计数管理内存。
mimalloc 的核心库不到 3500 行 C 代码,远小于 tcmalloc(约 2 万行)和 jemalloc(约 2.5 万行),但在大多数基准中性能都更好。
本文为微软技术报告 MSR-TR-2019-18(2019 年 6 月),作者 Daan Leijen、Benjamin Zorn、Leonardo de Moura。论文原文:mimalloc-tr-v1.pdf,代码:microsoft/mimalloc
#摘要
现代内存分配器需要同时兼顾性能、安全、并发以及具体使用场景的特殊需求。一个越来越常见的场景是作为 Swift、Python 这类使用引用计数自动释放对象的语言的后端。本文提出 mimalloc,它很好地平衡了这些需求,性能显著优于现有分配器,并且专门支持依赖分配器实现引用计数的语言。
mimalloc 的关键创新是:使用三条按 page 分片的空闲链表来提升局部性、避免争用,并支持高度优化的分配/释放快速路径。这些链表还带来了时间节奏(temporal cadence):分配器会以可预测的频率离开快速路径,去做延迟释放、处理其他线程的释放等维护工作。在 redis 上,mimalloc 比 tcmalloc 和 jemalloc 分别快 7% 和 14%,并在大量串行和并发基准中都持续领先。
#1. 引言
在为 Lean 和 Koka 开发共享运行时的过程中,现有分配器暴露出两个问题:
- Lean 和 Koka 都是函数式语言,会进行大量小而短命的分配。在 Lean 中,为小对象写的自定义分配器甚至比 jemalloc 这样高度优化的分配器还快。
- 和 Swift、Python 一样,运行时使用引用计数管理内存。为了限制释放大型数据结构时的停顿,需要支持延迟递减(deferred decrement)引用计数。而恢复延迟递减的最佳时机是内存紧张的时候,这需要分配器配合。
为此作者实现了一个新分配器,主要思想包括:
- 极端的空闲链表分片(free list sharding):不再是每个尺寸类别一条大空闲链表,而是每个 mimalloc page(通常 64KiB)一条。malloc 会在一个 page 内一直分配直到它满为止,与堆中其他地方的对象在哪里被释放无关,从而保持分配局部性。
- 独立的 thread-free 链表:其他线程的释放进入单独的 thread-free 链表,从而让 malloc 快速路径避免原子操作。这些链表同样按 page 分片以减少争用,并且会被周期性地原子地整体移入本地链表,相当于对远程释放做了批处理。
- 第三条 local-free 链表:本线程的释放放进 local-free 链表。当分配用的 free 链表变空时,local-free 链表成为新的 free 链表。这保证了每经过固定次数的分配就一定会走一次通用分配路径,形成时间节奏。这个通用例程可以用来摊销更昂贵的操作:处理延迟的引用计数递减、维持确定性的心跳、回收并发的 thread-free 链表。于是快速路径只需一个条件判断就能覆盖所有这些情况。
- 高度优化常见的分配/释放路径,其他情况交给通用例程。这要求数据结构非常规整以减少快速路径上的分支,也让代码更少特例、更简单。
- 没有锁,所有线程交互都通过原子操作完成。最坏情况分配时间有界,元数据开销约 0.2%,尺寸类别带来的浪费最多 16.7%。
历史上,分配器设计关注的多是缩短分配器自身耗时、减少内存用量或扩展到多线程,较少以改善应用的访存局部性为首要目标。VAM(Feng 和 Berger, 2005)和早期的 phkmalloc 也使用了空闲链表分片,保证连续的分配往往来自同一页。mimalloc 在 VAM 的基础上加入了多线程支持,以及额外的分片链表来减少争用、摊销维护任务。
#2. 空闲链表分片
#2.1 分配空闲链表
函数式风格的程序会分配和释放大量小对象。很多分配器每个尺寸类别只用一条空闲链表,这会导致糟糕的空间局部性:属于同一个数据结构的对象可能散布在整个堆上。考虑下面这个堆状态 (A),空闲链表横跨了堆的很大一部分:
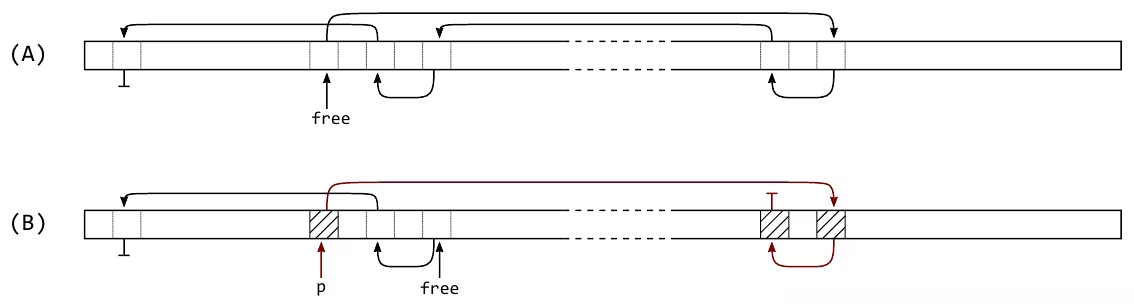
分配一个三元素的链表 p 后,得到状态 (B):新分配的链表同样散布在堆的很大范围内,局部性很差。这并不罕见,相反,大多数函数式程序最终都会收敛到这种堆状态,尤其是在遍历旧数据结构、同时构建不同尺寸类别的新数据结构时,交错的分配会导致空闲链表四处分散。
为了改善分配的空间局部性,mimalloc 使用空闲链表分片:堆按尺寸类别被划分为若干 page,每个 page 有自己的空闲链表(小对象的 page 通常为 64KiB)。之前的堆状态现在变成下面的 (A),每个 page 只有一条很短的空闲链表:
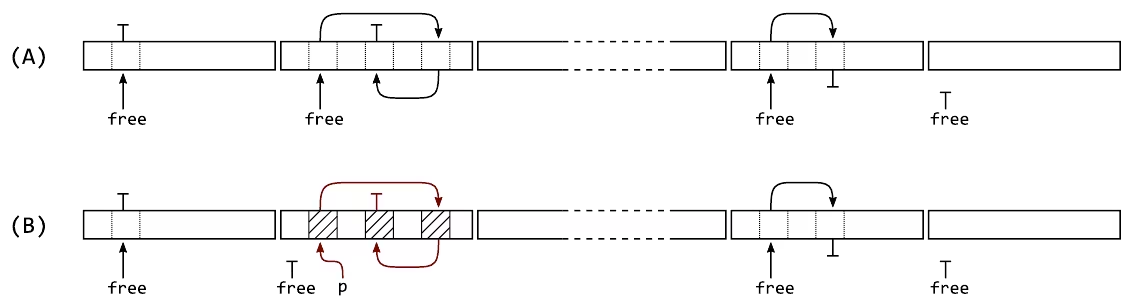
分配三元素链表 p 后得到状态 (B),这时整个链表都在同一个 page 内分配,空间局部性好得多。作者认为 mimalloc 的良好性能很大程度上来自分配局部性的改善。
为了验证这一点,作者在 Lean 编译器上做了实验。Lean 3 有一个用单条空闲链表分配小对象的自定义分配器。作者仅仅把它换成每个 slab(page)一条分片空闲链表,在一些 1GiB 堆、大数据结构的基准上就获得了超过 25% 的性能提升。
这里的 page 不是操作系统页。mimalloc 的 page 更大,更接近其他分配器中的 superblock(Hoard)或 subslab(snmalloc)。
#2.2 不使用 bump pointer
在 page 内分配现在只需要从 page 本地链表弹出一个块:
1 | void* malloc_in_page(page_t* page, size_t size) { |
快速路径上只有一个条件判断和一次弹出。used 自增用来高效判断 page 内的所有对象是否都已释放。
很多分配器采用 reap 设计:page 为空时先用 bump pointer 顺序分配(Berger 等人, 2002;Feng 和 Berger, 2005;Liétar 等人, 2019)。作者测试了带 bump pointer 的 mimalloc 变体,在所有基准中都稳定地慢约 2%。原因可能是:
- bump pointer 让快速路径上有了 2 个条件判断(用 bump pointer,还是用空闲链表);
- 这些条件依赖于当前恰好在哪个 page 里分配,分支预测效果很差;
- 从安全角度看,可预测的顺序分配也不好。mimalloc 会以随机顺序初始化新 page 的空闲链表(见 3.5 节)。
#2.3 local-free 链表
对于 Koka 和 Lean 运行时,作者希望限制最坏情况的分配和释放时间。特别是释放大型数据结构时,需要限制递归 free 的次数。使用引用计数时,可以用一个简单的计数器做上限,把剩余指针压入一个延迟递减列表。
问题是:什么时候再从延迟递减列表中继续释放?这需要分配器配合,因为最好的时机是分配器有压力、需要找更多空闲空间的时候。mimalloc 在这种时候调用用户定义的 deferred_free 回调,它在慢路径 malloc_generic 中被调用,恰好是在 page 本地空闲链表为空时。这与快速路径的单个条件判断结合得很好。
但这还不够:无法保证通用例程会被定期调用。用户可能在一个 page 内反复分配和释放,空闲链表永远不会变空。我们希望通用例程在固定次数的分配后一定会被调用。
因此,再分片一次:给每个 page 增加一条 local-free 链表。分配从常规的 free 链表取,而释放的对象放进 local-free 链表。这样就保证了 free 链表在固定次数的分配后一定会变空。在通用例程中,只需把 local-free 链表移给 free 链表即可继续分配:
1 | page->free = page->local_free; // move the list |
同样,快速路径上不需要额外的条件判断,工作都放在了慢路径。既然 deferred_free 能保证在有限次数的分配后被调用,它也可以作为确定性心跳。Lean 用它作为可移植的计时器,让运行时间过长的线程(例如证明)超时。这里不能用挂钟时间,因为那在不同机器上不确定,而心跳是确定的。
#2.4 thread-free 链表
在 mimalloc 中,page 属于线程本地堆,分配总是在本地堆中进行,因此本线程的分配不需要锁。但任何线程都可能释放对象。为了让跨线程释放也不需要锁,再最后分片一次:给每个 page 增加一条 thread-free 链表,其他线程把释放的对象压入其中。
非本地释放时,用原子操作把对象 p 压入 thread-free 链表:
1 | atomic_push(&page->thread_free, p); |
分片 thread-free 链表的妙处在于它同样减少了线程间的争用:在不同 page 中释放的线程互不干扰。在当前体系结构上,无争用的原子操作非常高效,通常作为缓存一致性协议的一部分实现。
同样由通用例程把 thread-free 链表收集到 free 链表中:
1 | tfree = atomic_swap(&page->thread_free, NULL); |
由于整条 thread-free 链表一次性被移走,这实际上也批处理了非本地的 free 调用。这对非对称的并发负载尤其重要,即一些线程主要释放、另一些线程主要分配的场景。snmalloc(Liétar 等人, 2019)正是为这种情况设计的,也用批处理来减少昂贵的同步。
#3. 实现
有了分片链表,就可以理解整个分配器的设计了。图 1 给出了堆布局的详细概览。除了分片链表之外,整体设计与其他按尺寸隔离、带线程缓存的分配器相当类似。
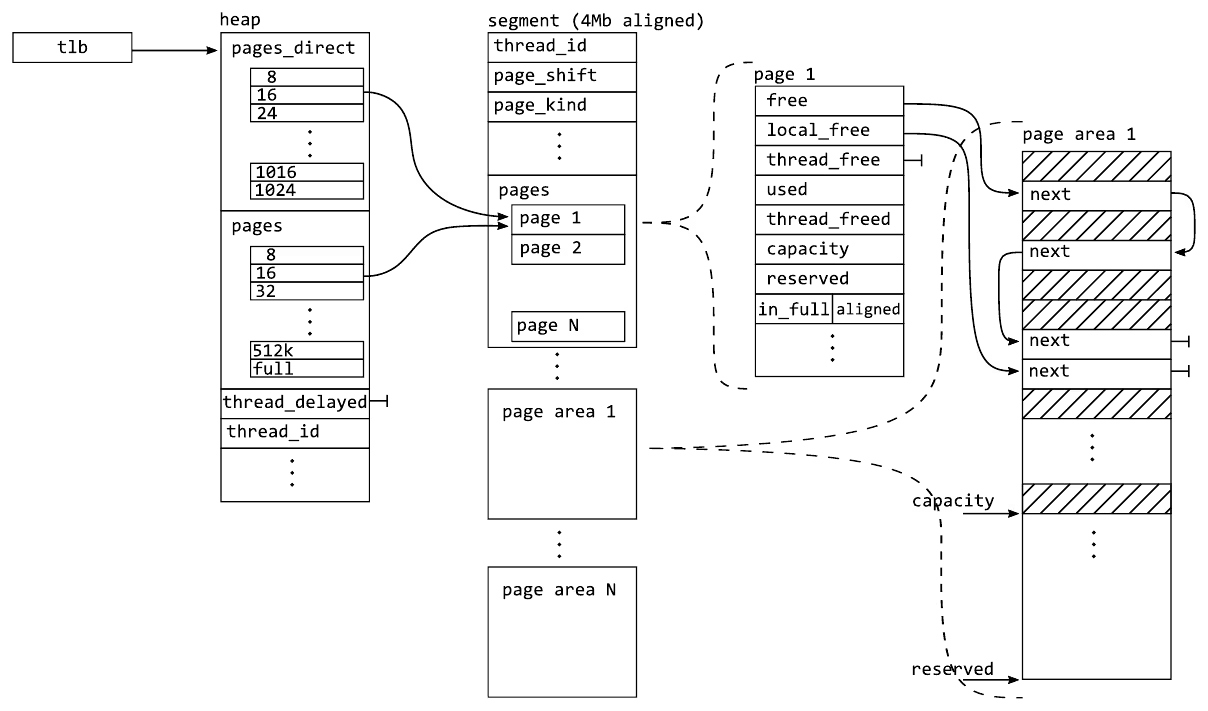
图 1:堆布局。
tlb为线程本地堆指针,heap 中的pages_direct直接索引小尺寸类别的第一个可用 page,pages按尺寸类别组织 page 队列;所有 page 及其元数据都位于 4MiB 对齐的 segment 中。
#3.1 malloc
分配对象时,mimalloc 先拿到线程本地堆(tlb),然后找到对应尺寸类别的 page。对于 1KiB 以下的小对象,堆中有一个直接指针数组 pages_direct,指向每个尺寸类别第一个可用的 page:
1 | void* malloc_small(size_t n) { // 0 < n <= 1024 |
编译后得到的汇编只有一个条件跳转。
所有 page 和 page 元数据都位于大的 segment 中(其他分配器有时称为 slab 或 arena)。segment 为 4MiB(超过 512KiB 的 huge 对象则更大),开头是 segment 和 page 的元数据,之后才是实际的 page;第一个 page 会因元数据和一个保护页而缩短。page 有三种大小:
| 对象大小 | page 大小 | 每个 segment 中的 page 数 |
|---|---|---|
| small(< 8KiB) | 64KiB | 64 |
| large(< 512KiB) | 整个 segment | 1 |
| huge(≥ 512KiB) | 按需 | 1 |
large 和 huge 对象仍然使用 segment + 单个 page,是为了让数据结构保持一致的接口,少写特例,降低代码量和复杂度。这在实践中很有回报:mimalloc 的代码量远小于大多数其他分配器。
#3.2 free
page 和元数据放在 segment 中,一方面是为了减少昂贵的系统调用,另一方面更重要的是:free 时需要从指针找到它所属 page 的元数据。mimalloc 把 segment 对齐到 4MiB 边界,只要把指针的低位清零就能找到 segment(这和 jemalloc 中 chunk 对齐的思路一样):
1 | void free(void* p) { |
论文中的掩码写作
~(4*MB),正确的写法应为~(4*MB - 1)。
几个细节:
- NULL 检查几乎免费:
free(NULL)时 segment 也为 NULL。按位与运算本身会设置零标志位,所以汇编里不需要额外的比较指令。 - 统一的 page 索引计算:小 page 的
page_shift为 16(64KiB),large 和 huge page 为 22(4MiB),这样后者的索引总是 0。统一的表示避免了快速路径上的特殊情况。 - 判断是否本地释放:依赖高效的
thread_id()。在大多数操作系统上,可以从线程本地数据的固定地址读取线程 ID(例如 x86-64 Linux 上就是fs寄存器偏移 0 处)。 - 尽早释放空 page:本地释放时顺便检查 page 是否已全部释放,是则立即释放该 page。也可以只在慢路径里回收全空 page,但某些负载下尽早让这些 page 可用效率更高。
- 无读屏障:读取线程共享的
thread_freed计数时没有用读屏障,因此有极小概率错过"page 刚刚全部释放"的时机。但没关系,通用分配例程迟早会被调用,届时可以回收这些 page。在只分配/只释放的非对称负载中,通用例程里的回收是这类 page 被释放的唯一途径。
#3.3 通用分配
通用分配例程 malloc_generic 是"慢路径",保证每隔一段时间就会被调用。这让我们有机会做一些较昂贵的操作,将成本摊销到大量分配上,几乎可以看作一种垃圾回收器:
1 | void* malloc_generic(heap_t* heap, size_t size) { |
通用例程线性遍历某个尺寸类别的 page,释放其中已经没有对象的 page,并在找到第一个有空闲对象的 page 时停下。实际实现中:
- 不会立即释放所有空 page,而是保留一部分在缓存中供将来使用;
- 单次释放的 page 数有上限,以限制最坏分配时间;
- 找到有空闲空间的 page 后会旋转 page 链表,下次搜索从该处开始。
#3.4 full 链表
上述实现在几乎所有基准上都表现很好,但并非全部。在 SpecMark 的 gcc 基准上,mimalloc 比其他分配器慢了 30%。这说明没有银弹,工业级分配器需要处理很多只在特定负载下才出现的边界情况。
gcc 基准使用自己的定制分配器,在开始时分配大量长期存活的大对象。对于 mimalloc,这导致了超过 18000 个已满的 page,每次进入通用分配例程都要线性遍历它们。
解决方案是增加一个单独的 full 链表存放所有已满的 page,当这些 page 中有对象被释放时再把它们移回常规 page 链表。这解决了 gcc 的问题,但这个看似微小的改动给多线程情况带来了相当大的复杂度:
- 当其他线程释放一个位于 full page 中的对象时,需要以某种方式通知所属的堆"这个 page 不再满了",而且最好不用昂贵的锁。为此引入了一个堆级别的 thread delayed free 链表。在通用例程中,先原子地接管这个链表,然后正常释放其中所有块,这可能会把 page 从 full 链表移回常规链表。
- 非本地释放如何知道应该压入 page 的 thread-free 链表,还是压入所属堆的 delayed free 链表?mimalloc 利用 thread-free 链表指针的最低 2 位原子地编码 3 种状态:
NORMAL、DELAYED和DELAYING。- 通常状态为
NORMAL,压入 page 的 thread-free 链表。 - page 被移入 full 链表时设为
DELAYED,表示非本地释放应压入所属堆的 delayed free 链表。 - 执行这一操作期间,临时设置
DELAYING状态,以保证所属堆结构在其线程恰好退出时仍然有效。
- 通常状态为
- 一次 delayed free 之后,状态总是重置为
NORMAL,因为每个 page 只需一次 delayed free 就能知道它不再满了。这是一项重要的优化:在非对称并发负载中,释放线程可能释放大量对象,应确保较昂贵的首次 delayed free 只做一次。没有这项优化,xmalloc-test 基准会慢 30%。
#3.5 安全
mimalloc 的设计很适合实现浏览器等环境所需的各种安全缓解措施。作者实现了一个安全变体 smimalloc:
- 保护页:在每个 mimalloc page 之间放置操作系统保护页,使堆溢出攻击始终被限制在一个 page 内,永远不会溢出到堆元数据。
- 随机化:page 中的初始空闲链表被随机初始化,不存在可预测的分配模式(防御 heap feng shui)。此外在 full 链表的情况下,安全版本有时会扩展 page 而不是使用 local-free 链表,进一步增加随机性。
- 链表编码:为了防御覆盖空闲链表的堆块溢出攻击,对每个 page 中的空闲链表做 xor 编码。这既能防止被写入已知值,也能高效地检测此类攻击。
- 多堆隔离:mimalloc 本身就高效支持多个堆,可以把虚函数表等内部对象分配在与其他应用对象不同的堆中,进一步提高安全性。
安全版本平均只比普通 mimalloc 慢约 3%,这让作者自己也很惊讶,他们原本以为这些缓解措施会带来大得多的开销。
#补充:释放与分配的完整示例
论文附录用图示给出了完整的释放与分配过程,有助于理解三条链表之间的关系:
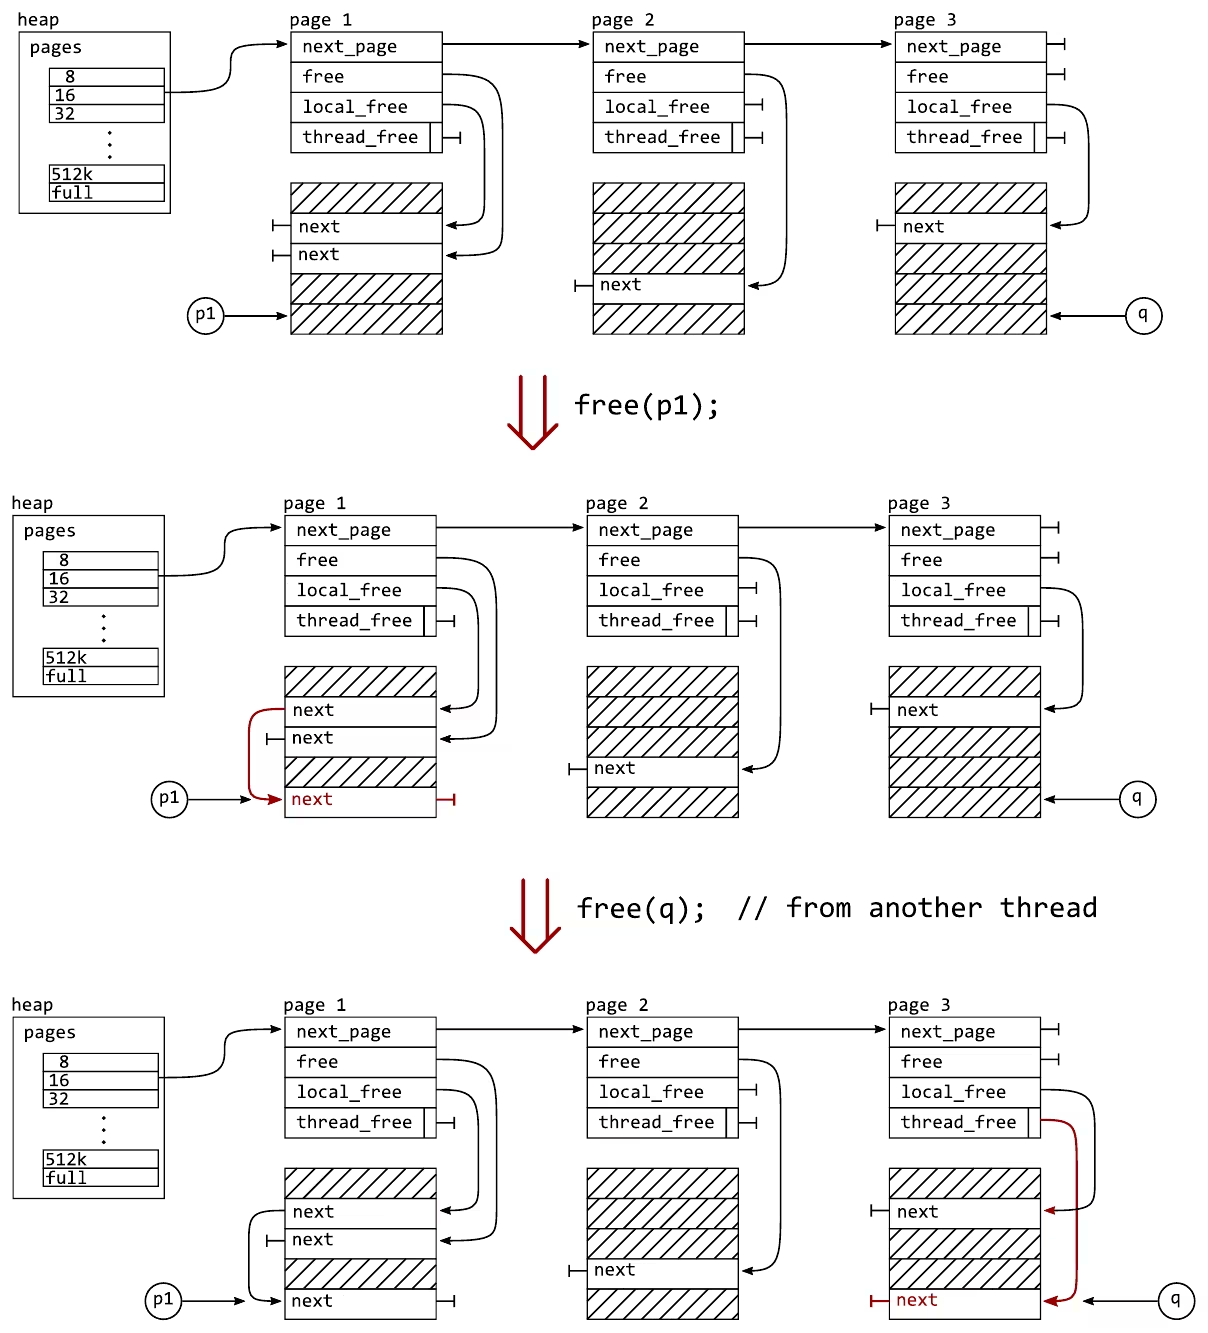
图 8:释放对象。
free(p1)是本线程释放,块被压入 page 1 的local_free;free(q)来自另一个线程,块被原子地压入 page 3 的thread_free。
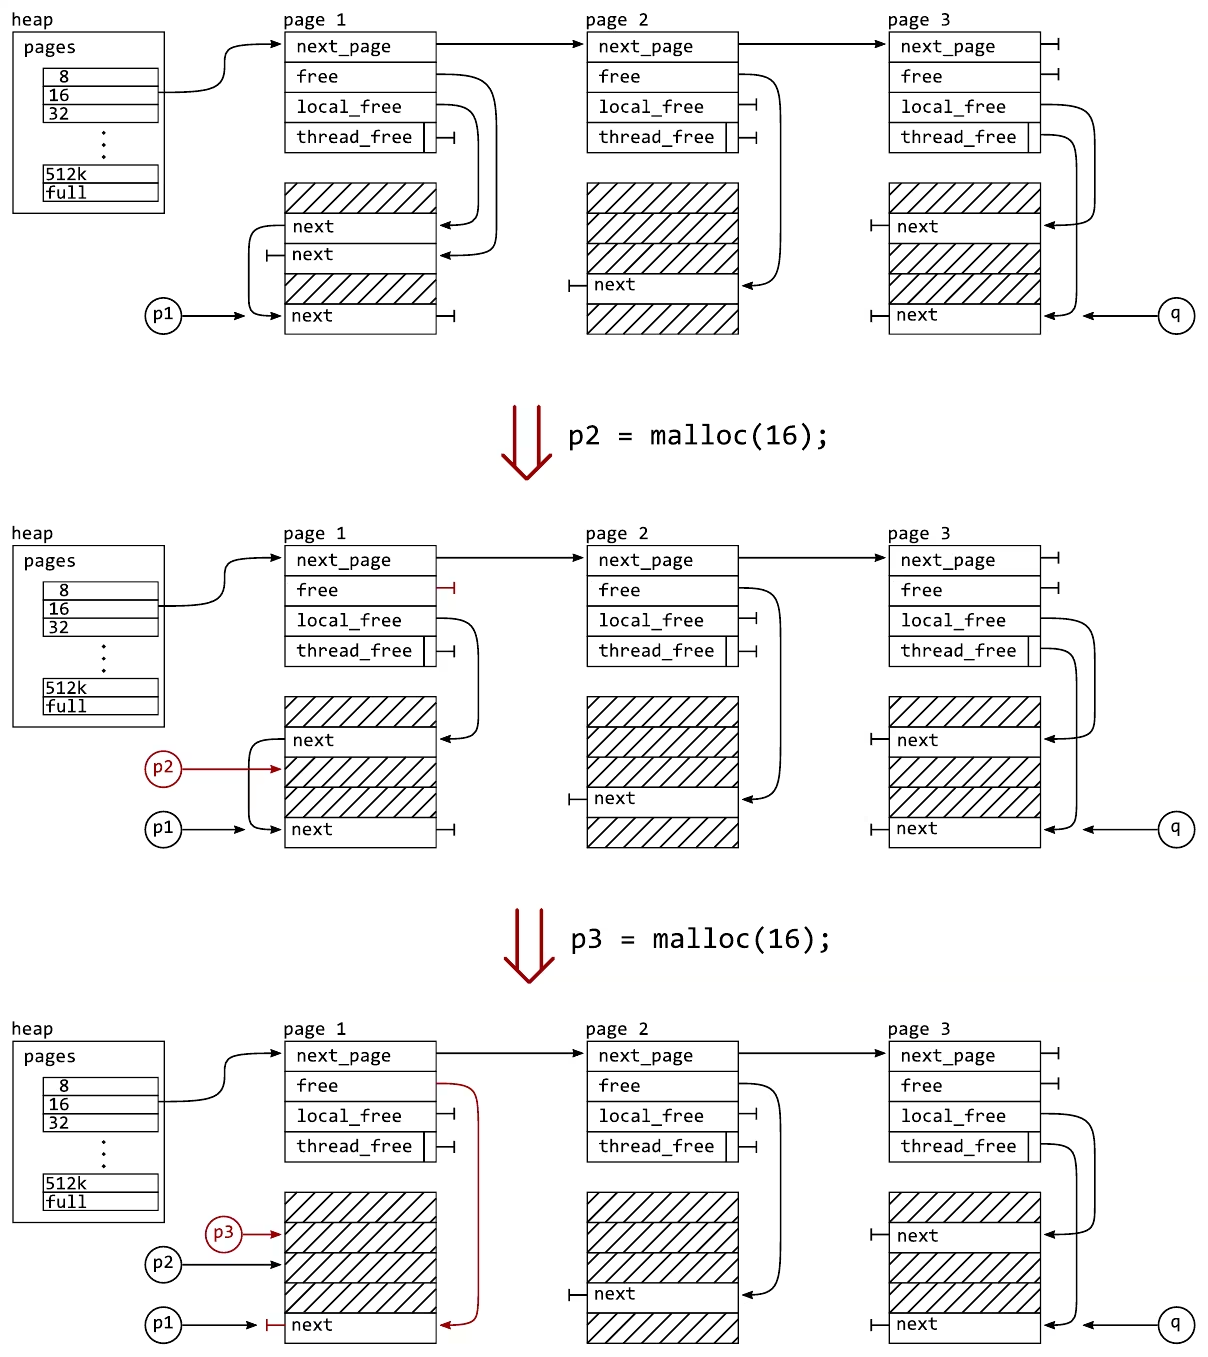
图 9:分配对象。
p2 = malloc(16)直接从 page 1 的free链表弹出;p3 = malloc(16)时free链表已空,进入慢路径,把local_free移给free后继续分配。
#4. 评估
作者在大量基准上把 mimalloc 与多个顶尖分配器做了对比,既有真实程序,也有测试极端情况的合成基准。所有分配器运行完全相同的程序,通过 LD_PRELOAD 替换默认分配器,用 time 测量挂钟时间和峰值常驻内存,取 5 次运行的平均值,结果以相对 mimalloc 的倍数给出。
分配器的特点是不存在普遍最优的算法:对于任何一个分配器,通常都能构造出让它表现不佳的负载。因此目标是找到在大范围基准上都表现良好、且在不常见情况下不会严重退化的分配策略(这正是第二组基准测试的内容)。
#4.1 对比的分配器
| 缩写 | 分配器 | 说明 |
|---|---|---|
| mi / smi | mimalloc v1.0.0 | smi 为安全版本 |
| tc | tcmalloc | Google perftools 2.5,Chrome 使用 |
| je | jemalloc 5.2.0 | Facebook 维护,FreeBSD、Firefox 使用 |
| sn | snmalloc | 基于消息传递的并发分配器 |
| rp | rpmalloc 1.3.1 | 32 字节对齐 |
| hd | Hoard 3.13 | 最早的多线程可扩展分配器之一 |
| glibc | glibc 2.27 | 基于 ptmalloc2,2.26 起显著改善了扩展性 |
| sm | SuperMalloc | 使用硬件事务内存 |
| tbb | Intel TBB | Thread Building Blocks 自带的分配器 |
#4.2 基准程序
第一组是真实程序:
- cfrac:连分数分解,大量小而短命的分配,正是 Koka 和 Lean 的目标负载。
- espresso:可编程逻辑阵列分析器。
- barnes:层次化 n 体粒子求解器,分配相对较少。
- leanN:Lean 编译器用 N 个线程并发编译自己的标准库,是一个分配密集的大型真实负载。
- redis:redis 5.0.3 处理 100 万个请求(压入 10 个列表元素再读取头部 10 个)。
- larsonN:模拟服务器负载,100 个线程各自分配释放大量对象,但会把一些对象留给其他线程释放(Larson 称之为 bleeding)。
第二组是压力测试:
- alloc-test:模拟 Pareto 尺寸分布的高强度分配,每线程 1 亿次分配,对象最大 1KiB。
- sh6bench:部分对象按 LIFO 顺序释放,另一部分按相反顺序释放。
- sh8benchN:sh6bench 的多线程版本,部分对象由其他线程释放。
- xmalloc-testN:larson 的更极端版本,100 个纯分配线程和 100 个纯释放线程,对象在它们之间迁移。这种非对称生产者/消费者模式通常很难被带线程本地缓存的分配器处理好。
- cache-scratch:Hoard 引入的基准,测试被动伪共享(passive false sharing)。先分配一些小对象分给各线程,线程释放后立即分配另一个并反复访问。如果分配器把不同线程的对象分配得很近,就会造成缓存行争用。
#4.3 16 核 AMD EPYC
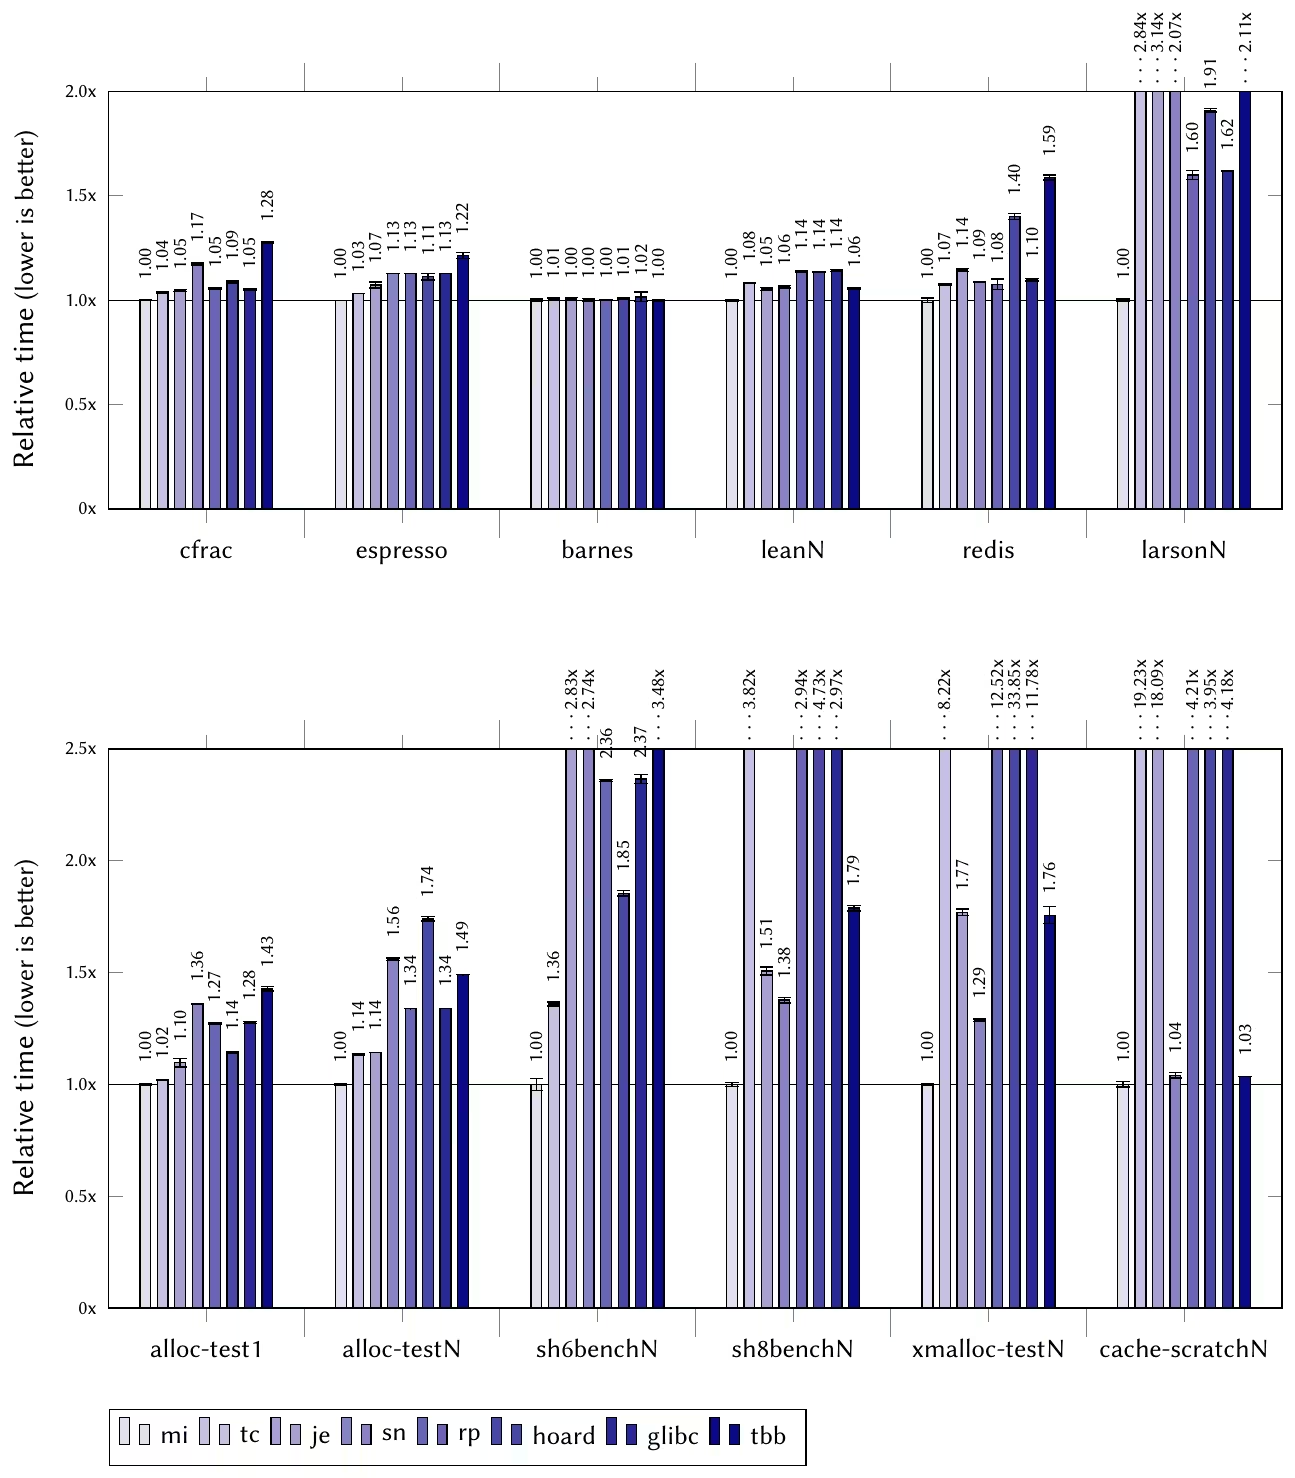
图 2:16 核 AMD EPYC(r5a.4xlarge)上的时间基准(相对 mimalloc,越低越好)。以 “N” 结尾的基准在所有核上并行运行。
- 前五个基准:mimalloc 适度领先,但所有现代分配器都表现不错,“常规负载下性能差距巨大的时代已经过去了”。在 cfrac 和 espresso 上,mimalloc 比 tcmalloc 和 jemalloc 稍快,在 espresso 上比其他分配器快 10% 左右;tbb 落后 mimalloc 20% 以上。
- leanN:作为大型真实并发负载最值得关注,比 tcmalloc 快 8%。如果 Lean 有 20% 的时间花在分配器上,这意味着 mimalloc 在分配器部分比 tcmalloc 快 1.3 倍。这一点在纯分配基准 alloc-test 中并未体现,作者推测这种超额收益来自更好的分配局部性,它让程序其余部分的计算也变快了。
- redis:差异更大,mimalloc 比 jemalloc 快 14%,tbb 和 Hoard 慢了 40% 以上。
- larsonN:mimalloc 比 tcmalloc 和 jemalloc 快 2.5 倍以上,可能是因为对象在线程间迁移,比排在第二的 snmalloc 也快 48%。
- alloc-test:tcmalloc、snmalloc 和 Hoard 的扩展性稍差,多核版本差了 10% 以上。即使最好的 tcmalloc 和 jemalloc 也比 mimalloc 慢 10% 以上。
- sh6bench:mimalloc 比 jemalloc 快 2 倍以上,作者推测部分原因在于"反向"释放模式。
- sh8bench:mimalloc 对线程间对象迁移的处理好得多,比第二名 snmalloc 快 36%。tcmalloc 在 sh6bench 上表现不错,但加入对象迁移后慢了近 3 倍。
- xmalloc-testN:非对称负载,snmalloc 正是为此设计的。mimalloc 无争用的分片 thread-free 链表在这里发挥了作用,甚至超过了 snmalloc。只有 jemalloc 也处理得还可以。full page 只做一次 delayed free 的优化非常重要,没有它 mimalloc 会慢近一倍(因为所有释放会再次争用同一个堆的 delayed free 链表)。
- cache-scratch:单线程时所有分配器表现一样,但多线程时分配器引起的伪共享造成巨大差异,mimalloc 比 jemalloc 和 tcmalloc 快 18 倍以上。只有 snmalloc 和 tbb 也像 mimalloc 一样避免了缓存行共享。
#4.4 4 核 Intel Xeon 工作站
在 4 核 Intel Xeon W2123 工作站上的相对结果与之前相当类似。大多数分配器在 larsonN 上表现更好,原因可能是体系结构差异(AMD vs. Intel),也可能只是并发度更低。SuperMalloc 在 leanN 和 xmalloc-testN 上崩溃了。
安全版本 smi 使用了保护页、链表编码和随机化初始空闲链表,作者原本以为它会差很多,但在第一组基准上平均只慢约 3%,综合排名第二。
#4.5 SpecMark 2019
大多数 SpecMark 基准分配不多,现代分配器的表现几乎相同。只有 4 个基准有较大差异:602.gcc、620.omnetpp、623.xalancbmk 和 648.exchange2。
- mimalloc 表现不错,但在 omnetpp 和 xalancbmk 上比 tcmalloc、jemalloc 和 snmalloc 稍慢。
- gcc 基准在开始时分配大量长期存活的数据,mimalloc 需要 full 链表来避免长时间搜索。tcmalloc 和 tbb 都有约 30% 的性能落后,作者推测它们也遇到了同样的问题(就像优化前的 mimalloc)。
- 在 exchange2 上,tcmalloc 和 jemalloc 使用的内存都明显多于 mimalloc,尽管 jemalloc 专门针对长期运行的服务程序做了降低常驻内存的优化。
#5. 相关工作
- VAM(Feng 和 Berger, 2005)是与 mimalloc 最接近的设计。VAM 开创了"优先考虑应用访存局部性而非减少内存碎片"的思路,mimalloc 的分片空闲链表改进了 VAM 的原始设计。VAM 为每个 4KiB 硬件页维护空闲链表,并支持 bump pointer 分配(mimalloc 考虑过但否决了)。VAM 对中大对象做了不同处理,为每个对象附加内联元数据以支持 best-fit。VAM 也不支持多线程。
- Grunwald 等人 (1993) 强调了分配器设计对应用整体局部性的影响,并认为 QuickFit 这样的按尺寸隔离方案能提供更好的局部性。与 Grunwald 或 VAM 不同,mimalloc 证明了对所有尺寸的对象使用统一的表示能显著降低复杂度、提高性能。
- Intel TBB 分配器与 mimalloc 有一些共同之处:按尺寸隔离的 bin、线程本地空闲链表、从私有空闲链表分配,并且每个 bin 有一个公共空闲链表供其他线程归还对象。但 TBB 没有单独的私有 local-free 链表,而是立即复用被释放的对象,不做延迟。mimalloc 的快速路径明显更快(例如 redis 上快 50%),在多线程基准中扩展性也更好。
- snmalloc 关注多线程生产者/消费者负载,引入了一种新颖的基数树结构,避免多个消费者线程在向同一个生产者归还对象时互相争用。mimalloc 则通过为每个 page 分片 thread-free 链表来处理跨线程释放的争用。
#6. 结论
mimalloc 的设计动机是支持语言运行时中延迟的引用计数递减,并着重改善应用的整体访存局部性。它为每个 64KiB 的软件 page 提供三条分片空闲链表,提高了整体局部性,减少了多线程争用,并支持时间节奏:慢路径操作被推迟,但保证会定期发生。为了避免快速路径上昂贵的分支,mimalloc 简化了对象表示,去掉了 bump pointer 分配、对中等对象的特殊表示等复杂性。与最先进的商业分配器相比,mimalloc 在默认配置下持续领先,无论是 redis 这样的单线程负载,还是多线程压力测试。
#读后总结
| 链表 | 谁写入 | 谁读取 | 作用 |
|---|---|---|---|
free | 慢路径(从下面两条迁移) | malloc 快速路径 | 分配;page 内分配保证局部性 |
local_free | 本线程 free | 慢路径 | 让 free 在固定次数后必然变空,形成时间节奏 |
thread_free | 其他线程 free(CAS) | 慢路径(原子 swap 整体取走) | 无锁跨线程释放,并自动批处理 |
和 jemalloc、tcmalloc 相比,mimalloc 的思路可以概括为:
- 把"线程缓存"做到 page 粒度:tcmalloc 等分配器在线程缓存中维护每个尺寸类别的一条空闲链表,对象可以来自任何 span;mimalloc 则让线程直接拥有 page,并把空闲链表放在 page 内。局部性更好,也不需要在线程缓存与中心缓存之间来回搬运对象。
- 快速路径只有一个分支:所有"不常见"的工作都被推到慢路径,而三条链表的设计保证慢路径一定会定期执行。
- 对齐即索引:4MiB 对齐的 segment 让 free 能 O(1) 找到元数据,这和 jemalloc 的 chunk、glibc 非主 arena 的 heap 对齐是同一个技巧。
#参考文献
- Daan Leijen, Benjamin Zorn, Leonardo de Moura. Mimalloc: Free List Sharding in Action. Microsoft Technical Report MSR-TR-2019-18, 2019
- Yi Feng, Emery D. Berger. A Locality-Improving Dynamic Memory Allocator. MSP 2005
- Emery D. Berger, Kathryn S. McKinley, Robert D. Blumofe, Paul R. Wilson. Hoard: A Scalable Memory Allocator for Multithreaded Applications. ASPLOS 2000
- Paul Liétar, Theodore Butler, Sylvan Clebsch, et al. snmalloc: A Message Passing Allocator. ISMM 2019
- Per-Åke Larson, Murali Krishnan. Memory Allocation for Long-Running Server Applications. ISMM 1998
- Jason Evans. A Scalable Concurrent malloc(3) Implementation for FreeBSD. BSDCan 2006