[OSDI'21] Beyond malloc efficiency to fleet efficiency: a hugepage-aware memory allocator 论文阅读
TCMalloc(Thread-Caching Malloc)最早由 Google 的 Sanjay Ghemawat 等人开发,作为 gperftools 的一部分开源,以"线程本地缓存 + 中心缓存 + 页堆"的多级结构著称。2020 年 Google 开源了内部持续演进的新版本 google/tcmalloc,它把线程缓存换成了基于 rseq 的 per-CPU 缓存,并引入了本文介绍的大页感知页堆 Temeraire。
本文发表于 OSDI 2021,作者 A.H. Hunter(Jane Street,工作完成于 Google 期间)、Chris Kennelly、Paul Turner、Darryl Gove、Tipp Moseley、Parthasarathy Ranganathan(Google)。论文原文:osdi21-hunter.pdf
#摘要
在仓库级计算机(warehouse-scale computer,WSC)中,内存分配是一项显著的计算开销,对它的优化可以节省可观的成本。一种经典方法是提高分配器本身的效率,减少花在分配器代码中的周期。然而,内存分配决策还会通过数据放置影响应用的整体性能,这提供了用更少硬件资源完成更多应用工作的机会。本文聚焦于大页覆盖率(hugepage coverage)。
作者提出 Temeraire,一个对 TCMalloc 的大页感知改进,用来降低应用代码中的 CPU 开销。在 8 个应用上,请求吞吐(RPS)平均提升 7.7%,内存使用降低 2.4%。全集群 1% 机器的实验以及在 Google WSC 中的全面推广显示:TLB miss 停顿减少 6%,碎片造成的内存浪费减少 26%。
#1. 引言
WSC 中的数据中心税(datacenter tax)是指花在序列化、RPC、压缩、拷贝和内存分配等通用服务开销上的累计时间。WSC 负载非常多样,通常无法通过优化单个应用显著提升整体系统效率;相反,优化数据中心税的组成部分能带来可观的收益,因为好处可以作用于整类应用。过去几年,作者所在团队一直致力于降低内存分配本身的开销。但除此之外,通过改变分配器来提升应用代码本身的效率也能带来显著收益。
缓存和 TLB miss 是现代系统中主要的性能开销。在 WSC 中,内存墙问题非常突出:一项分析显示 50% 的周期停顿在内存上;作者自己的负载分析发现约 20% 的周期停顿在 TLB miss 上。
大页可以显著减少 TLB miss 的次数和代价:更大的页让同样数量的 TLB 表项能映射大得多的内存范围;在所研究的系统上,大页还因为页表少一级而缩短了 miss 后的填充时间。
分配器无法改变用户代码访问的内存量,甚至无法改变对象的访问模式,但它可以与操作系统合作并控制新分配的放置。通过优化大页覆盖率,分配器可以减少 TLB miss。在 C/C++ 中,放置决策是终局的:对象一旦分配就不能移动,只能在分配时做出最优决策。这与作者此前的工作方向相反:可能会增加单次分配的 CPU 开销(也就是增加数据中心税),但通过减少其他地方的处理器停顿把损失补回来,从而提升 RPS 等应用指标。
减少停顿可以提升 IPC,但 IPC 本身并不能很好地代表固定硬件上完成的有用工作量。例如忙等的自旋锁 IPC 极高,但在争用下几乎什么有用的事都没做。
本文的贡献:
- Temeraire 的设计:一个大页感知的 TCMalloc 增强,用于降低应用其余代码的 CPU 开销;提出了最大化大页覆盖率、最小化碎片开销的内存布局策略。
- 在真实复杂应用和 WSC 规模下的评估:8 个应用 RPS 提升 7.7%、内存降低 2.4%;全集群 TLB miss 停顿减少 6%,碎片浪费减少 26%。
- 优化分配器开发过程的策略:结合追踪、遥测和仓库级实验。
#2. 协调大页的挑战
虚拟内存需要通过 TLB 把用户空间地址翻译为物理地址。TLB 表项数量有限,对很多应用来说,使用默认页大小时整个 TLB 只能覆盖总内存的一小部分。现代处理器通过在 TLB 中支持大页来扩大覆盖范围:一个对齐的大页(x86 上通常为 2MiB)只占一个 TLB 表项。
传统分配器以页为单位管理内存。透明大页(THP)让内核有机会在页表中用大页覆盖连续的小页。表面上看,分配器只需分配大页对齐、大页大小的内存块就能利用这一特性。
但会把内存归还给操作系统的分配器面临更难的挑战(在 WSC 中这是必需的,因为负载长期运行且负载周期动态变化):
- 归还非大页对齐的内存区域,会迫使内核用小页表示剩下的部分,破坏内核提供大页的能力,并让剩余的已用页付出性能代价。
- 反过来,分配器也可以等整个大页都空了再归还,这保住了大页覆盖率,但可能导致相对真实使用量的显著放大,让内存闲置。而 DRAM 是 WSC 部署的重要成本。
外部碎片(太小而无法满足请求的空闲空间)的管理在这里很重要。例如一系列分配和释放之后剩下了 2 个单位的空闲空间,这时要么使用小页(碎片少,但 TLB 使用效率低),要么使用大页(TLB 高效,但碎片多)。
一个了解这些策略行为的用户态分配器可以与之配合:把分配紧密地对齐到大页边界上,优先使用已分配的大页,并(理想情况下)以同样的对齐归还未用内存。大页感知分配器帮助在用户层管理内存连续性,目标是:
- 把分配尽可能多地塞进几乎满的大页;
- 反过来,尽量减少空的(或较空的)大页上的已用空间,使它们能作为完整大页归还给操作系统。
这样既高效利用了内存,也与内核的透明大页支持配合良好。而且更一致地分配和释放大页会形成正反馈:减少内核层面的碎片,提高未来分配被大页支撑的可能性(大页背后的物理内存必须是连续的,归还完整大页实际上是在帮助操作系统管理碎片)。
#3. TCMalloc 概览
TCMalloc 是一个用于大规模应用的内存分配器,常见于 WSC 环境,性能稳健。Temeraire 直接构建在 TCMalloc 的结构之上。
#尺寸类别与 span
TCMalloc 按尺寸隔离对象。它首先把内存划分为按页对齐的 span(TCMalloc 的"页"默认为 8KiB,即 x86 上两个小页)。
- 足够大的分配由只包含该对象的 span 直接满足。
- 其他 span 包含多个同样大小(同一个 sizeclass)的小对象。"小"对象的边界是 256KiB,在此范围内,请求会被向上取整到约 100 个 sizeclass 之一。
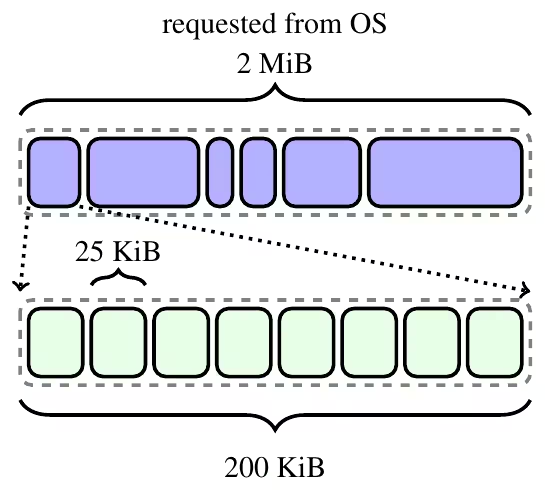
图 2:TCMalloc 的内存组织。从系统映射的内存被拆分为(多)页 span,每个 span 再切分为固定 sizeclass 的对象,这里是 25KiB。
#多级缓存
TCMalloc 把对象存放在一系列缓存中:
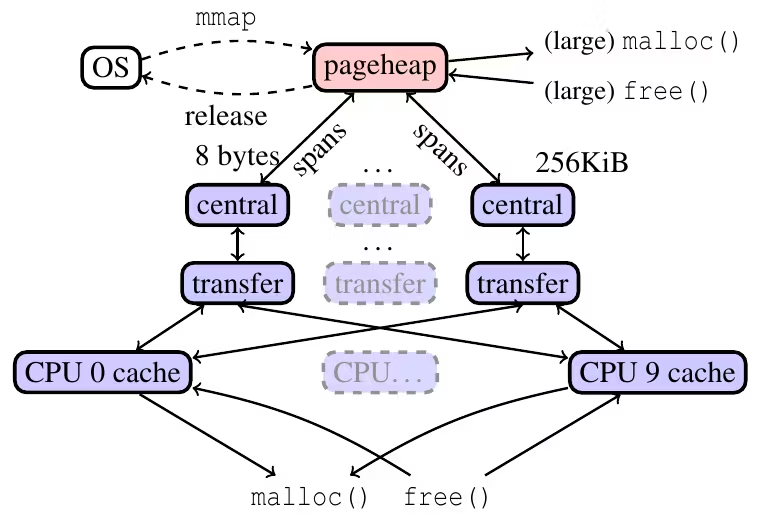
图 3:TCMalloc 的缓存组织。内存从操作系统分配给 pageheap,再以 span 的形式分给 central cache,最终到达本地缓存。本文关注的是 pageheap 的新实现。
- 本地缓存:TCMalloc 首先尝试从"本地"缓存满足分配,这和大多数现代分配器一样。最初它们就是同名的每线程缓存(Thread Cache),为每个 sizeclass 存一条空闲对象链表。为了减少滞留内存、改善高线程数应用的复用,TCMalloc 现在使用每超线程(per-hyperthread)本地缓存。
- 中心缓存:当本地缓存没有对应 sizeclass 的对象(或 free 后对象过多)时,请求被转发到该 sizeclass 唯一的中心缓存。它有两个组件:
- 小而快的、互斥锁保护的 transfer cache,存放该 sizeclass 对象的扁平数组;
- 大的、互斥锁保护的 central freelist,包含分配给该 sizeclass 的所有 span,可以从这些 span 取出或归还对象。当某个 span 的所有对象都归还后,这个 span 被交还给 pageheap。
- pageheap:span 从一个简单的 pageheap 中分配,它跟踪所有未使用的页并做 best-fit 分配。pageheap 还负责把不再需要的内存归还操作系统。它不在
free()路径上做这件事,而是由一个专门的 release-memory 方法周期性地调用,以维持一个可配置的、稳定的释放速率(MB/s)。
这里有一个两难:TCMalloc 希望在稳态下使用尽可能少的内存,同时又要避免本可以通过复用已有内存省掉的昂贵系统调用。理想情况下应归还所有用户代码近期不再需要的内存,但内存需求变化不可预测,很难做到既归还了不会用的内存、又保留了避免系统调用和缺页的内存。
在作者的 WSC 中,大多数分配都是小分配:按字节加权,50% 的已分配空间是 ≤ 8192 字节的对象。这些对象被聚合到 span 中,pageheap 主要分配 1 或 2 页的 span,80% 的 span 小于一个大页。
#分层的好处
这种"堆叠"缓存的设计让系统高度模块化:
- 清晰的抽象更容易理解和测试;
- 可以相对直接地用全新实现替换任意一层缓存;
- 需要时可以在运行时选择缓存实现,便于灰度发布和实验。
TCMalloc 的 pageheap 接口非常简单:
New(N):分配一个 N 页的 span;Delete(S):把一个New出来的 span 归还给分配器;Release(N):把 pageheap 缓存的至少 N 个未用页归还操作系统。
#4. Temeraire 的方法
Temeraire 用一个新设计替换了 pageheap,力图最大程度地填满(和清空)大页。
几个术语:
- slack:分配请求的大小与下一个完整大页之间的空隙。
- unbacked:从操作系统申请的虚拟地址空间,尚未占用物理内存。
- backed:被使用后,由操作系统映射了物理内存。
- 可以把内存再次释放给操作系统,使其重新变为 unbacked。
Temeraire 主要在大页边界内做紧密打包,但也使用由多个大页组成的 region 来跨大页边界打包。
#设计原则
根据对 malloc 使用情况和 TCMalloc 内部的遥测,以及对内核实现的了解,作者总结了几条指导原则:
- 总内存需求随时间不可预测地变化,但并非每个分配都会被释放。分配器无法控制调用代码,它可能快速、反复地调整用量,分配器必须对此足够稳健。但 pageheap 上很多分配是永生的(而且很难预测哪些是),任何一个分配都可能立即消失,也可能永远存在,两种情况都要处理好。
- 完全清空大页意味着要在大页粒度上打包内存。把并非几乎全空的大页归还给操作系统代价很高(见第 2 节)。要产生空或几乎全空的大页,就意味着其他大页要被密集地填满。设计必须支持把分配尽可能紧密地塞进尽可能少的饱和容器中。
- 我们希望只使用大页大小的容器,但 malloc 必须支持比单个大页更大的分配。这些分配可以正常分配,但要把较小的分配放进它们的 slack 中,以获得高分配密度。只有当小分配被 slack 压倒时,才需要把大分配首尾相接地放在 region 中。
- 清空大页带来了新的释放决策点。当一个大页完全变空时,可以选择保留它以供将来分配,或归还给操作系统。保留到 TCMalloc 后台线程释放为止会占用更多内存;立即归还能减少内存,但如果之后再次使用,就要付出系统调用和缺页的代价。自适应地做这个决定,可以比后台线程更快地归还内存,同时避免额外的系统调用。
- 犯错代价高,干活代价低。直接触及 pageheap 的分配很少,但所有分配背后都由 pageheap 支撑。分配的成本只付一次;但如果放置不当导致大页碎片化,就要在很长时间里为这块空间(或拆分大页的时间成本)买单。如果能让分配器做出更好的决策,让它慢一点也值得。
作者也指出,大多数现代分配器都有类似 span 的页级(或更大)后备分配:jemalloc 的 extent、Hoard 的 superblock、mimalloc 的 page。Hoard 的 8KB superblock 直接用 mmap 分配,妨碍了大页连续性;mimalloc 把 64KiB+ 的 page 放在 segment 中,但 segment 是每线程维护的,妨碍了跨 segment 的紧密打包;积极地把页归还操作系统虽然降低了内存开销,却会拆散大页。这些分配器也可以从类似 Temeraire 的设计中受益,jemalloc 已经在参考 Temeraire 做类似的工作。
#4.1 整体算法
Temeraire 通过委托给几个子组件来实现 pageheap 接口:
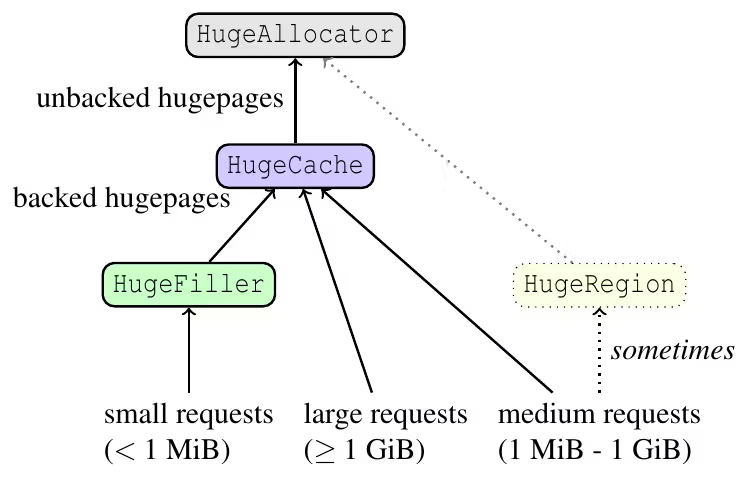
图 6:Temeraire 的组件,箭头表示请求在内部组件之间的流向。
| 组件 | 职责 |
|---|---|
HugeAllocator | 处理虚拟内存与操作系统,向其他组件提供 unbacked 内存 |
HugeCache | 缓存已 backed、完全空闲的大页 |
HugeFiller | 维护部分填充的单个大页列表,供后续小分配密集填充 |
HugeRegion | 当沿大页边界装箱效率低时使用的专门分配器 |
Temeraire 按请求大小把分配交给不同的子组件,算法如下(大页大小为 2MiB):
1 | Span New(N) { |
- 大小为大页整数倍,或大到 slack 可以忽略(≥ 1GiB)的分配,直接转给
HugeCache。 - 中等大小(1MiB 到 1GiB)的分配通常也从
HugeCache分配,最后一步是捐赠 slack。例如从HugeCache分配 4.5MiB 会产生 1.5MiB 的 slack,开销比例高得无法接受。Temeraire 把这块 slack 捐赠给HugeFiller:假装请求的最后一个大页上有一个"前导"的分配(图 8)。
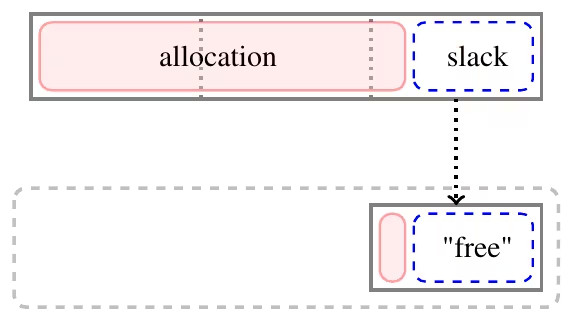
图 8:一个跨越 3 个大页的大分配产生的 slack 被"捐赠"给
HugeFiller,大分配的尾部被当作一个虚构的分配。
当这个大 span 被释放时,分配器也会把这个虚构的前导分配标记为空闲。如果 slack 没被用上,尾部大页就和其他部分一起归还;否则尾部大页留在 HugeFiller 中,只有前 N−1 个大页归还给 HugeCache。
- 对于某些分配模式,中等大小的分配产生的 slack 多到无法被严格 2MiB 容器中的小分配填满。例如大量 1.1MiB 的分配会让每个大页产生 0.9MiB 的 slack(图 12)。检测到这种模式时,
HugeRegion会跨大页边界放置分配,以减少这种开销。
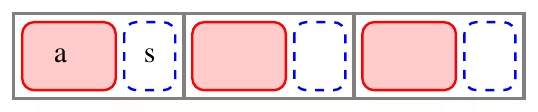
图 12:当许多分配(“a”)各自放在单个大页上时,slack(“s”)会不断累积,没有任何一块 slack 大到能容纳下一个大小为 “a” 的分配。
- 小请求(≤ 1MiB)总是由
HugeFiller满足。对于 1MiB 到一个大页之间的分配,依次考虑:- 先试
HugeFiller:如果有可用空间就用,乐于填充一个大部分为空的页; - 否则考虑
HugeRegion:如果已有能满足请求的 region 就用;如果没有(或都太满),只有在测得 slack 与小分配之比很高时才会考虑分配新的 region; - 否则从
HugeCache分配一个完整大页。这会产生 slack,但预期它会被将来的分配填满。
- 先试
Temeraire 的一个设计选择是:只在大页粒度以内关心外部碎片,超出大页的碎片基本不关心(4.5 节是例外)。例如,一个只有单个 1GiB 空闲区间的系统,和一个有 512 个不连续空闲大页的系统,Temeraire 处理得一样好:两种情况下分配器(通常)都会把所有未用空间归还操作系统,新的 1GiB 分配都需要缺页调入内存,只是碎片化的情况下要在新的虚拟内存上做。由于 64 位地址空间中虚拟内存几乎是免费的,浪费没有物理内存支撑的虚拟地址范围并不是问题。
#4.2 HugeAllocator
HugeAllocator 跟踪已映射的虚拟内存,所有操作系统映射都在这里完成。它存储大页对齐的 unbacked 区间。虚拟内存几乎是免费的,所以这里追求简单和合理的速度:用一棵 treap 跟踪未用区间,并在子树上维护其中最大的区间,从而快速选出近似的 best-fit。
#4.3 HugeCache
HugeCache 以完整大页粒度跟踪已 backed 的内存区间。由于 HugeFiller 会填满和清空完整的大页,就需要决定何时把空大页归还操作系统:归还了还要用的内存会后悔,不归还而让内存在缓存里闲置也会后悔。积极归还意味着要做系统调用来归还、再缺页来复用;只按 TCMalloc 周期性释放线程请求的速率释放,又意味着内存被闲置。
考虑下面这个没有其他堆分配的人造程序:
1 | while (true) { |
每次循环 New 都需要一个新大页并交给 HugeFiller,Delete 后这个大页又完全空闲。如果积极归还,这个简单但病态的程序每次迭代都要一次系统调用。
Temeraire 在一个 2 秒的滑动窗口内跟踪需求的周期性,计算其中的最小值和最大值(demandmin、demandmax)。每当有内存归还给 HugeCache 时,如果缓存会超过 demandmax − demandmin,就把多出的大页归还操作系统。作者也尝试过其他算法,但这个简单的算法足以捕捉实际观察到的动态:只要窗口内的需求曾经需要过这个大小,缓存就可以增长到这个大小。在振荡的使用模式下,它会(错误地)释放一次内存,然后(正确地)从此保留它。
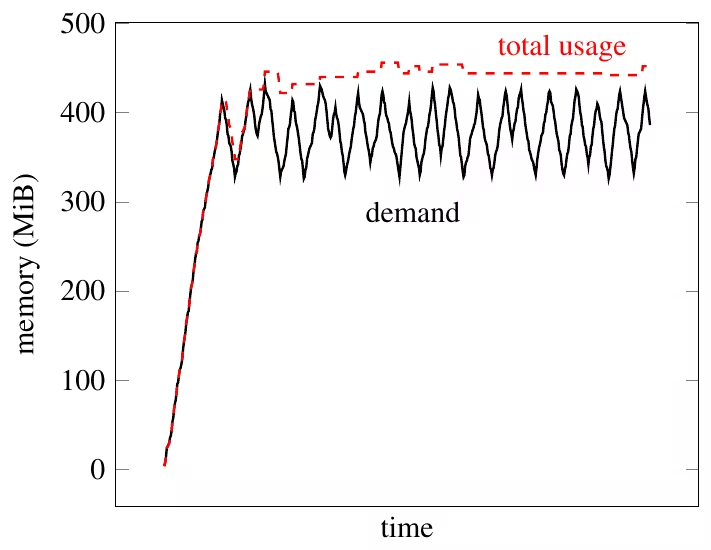
图 10:Tensorflow 对
HugeCache的需求随时间变化,以及缓存上限(+demand)。第一次需求下降时紧密跟踪了锯齿状的需求;之后识别出这个模式,把峰值需求保留在缓存中。
#4.4 HugeFiller
HugeFiller 满足那些能放进单个大页的较小分配,这是绝大多数分配(全集群平均 78% 的 pageheap 由 HugeFiller 支撑),也是整个系统中最重要、优化最多的组件。在给定大页内部用简单快速的 best-fit 放置分配,难点在于决定放在哪个大页上。
这个组件要解决一个装箱问题:目标是把大页分成两类,一类尽量保持全满,另一类空或几乎为空。最空的大页可以被回收(必要时拆分大页),同时对大页覆盖率影响最小,因为密集填充的页用大页覆盖了大部分已用内存。但清空大页很困难,因为不能指望某个特定分配会消失。
次要目标是减少每个大页内部的碎片,以便新请求更容易被满足。如果需要一个新的 K 页 span 但没有 ≥ K 页的空闲区间,就得从 HugeCache 再要一个大页,从而产生 (2MiB − K × pagesize) 的 slack。
这带来两个需要权衡的目标:
- 为了让大页尽可能变成完全空闲,几乎全空的大页很宝贵;
- 为了减少碎片,有长空闲区间的大页也很宝贵。
两者都可以通过保留空闲区间最长的大页来满足,因为更长的空闲区间意味着更少的已用块。
每个大页内部维护一个已用页的位图,从中做 best-fit 搜索来满足请求。同时跟踪几个统计量:
- L:最长空闲区间,即连续未分配页的数量;
- A:分配总数;
- U:已用页总数。
这三个统计量决定了放置分配时大页的优先级:选择 L 最小但足够、A 最大的大页。对于 K 页的分配,先只考虑 L ≥ K 的大页,这决定了它是否是可行目标;在 L ≥ K 且 L 最小的大页中,再按满度排序。大量实验后,作者选择用 A 而不是 U 来衡量满度。
这个选择源于放射性衰变式的分配模型:每个分配(无论大小)在每个时间步都以相同概率 p 被释放。在这个模型中,一个有 5 个分配的大页完全变空的概率是 p5 << p,所以应该强烈避免从分配很少的大页上分配。具体来说,这个模型预测 A 比 U 更能代表"空"的程度:一个大小为 M 的分配比 M 个大小为 1 的分配更可能被全部释放。衰变模型在真实应用中并不完全成立,但它是一个有效的近似,实验也支持其主要结论:按 A 排序清空的页面明显多于按 U 排序(用 U 结果尚可,但明显更差)。
更具体地,A 被用来计算一个 chunk 索引 C = min(0, Cmax − log2(A)),使最满的页 C = 0,最空的页 C = Cmax − 1。实践中 Cmax = 8 个 chunk 就足以避免从几乎全空的页上分配。区分分配数很多的大页没那么重要:例如有 200 个分配的大页和有 150 个分配的大页,都被预测为极不可能完全清空。这个方案着重区分可能变空的页面之间的细微差别。
大页存储在一个链表数组中,每个大页放在索引 I = Cmax × L + C 的链表上。由于 K 页分配可以从任何 L ≥ K 的大页上满足,能满足它的大页恰好就是 I ≥ Cmax × K 的那些链表。从最小的非空链表中任选一个大页,并用一个非空链表位图把这一步加速到常数时间。
这个策略不同于 best-fit。设大页 X 有一个 3 页的空隙和一个 10 页的空隙,大页 Y 有一个 5 页的空隙。best-fit 会选 X,而 Temeraire 选 Y。这个策略之所以有效,是因为它倾向于在最碎片化的页上分配,而碎片化的页本来就不太可能完全变空。如果需要 3 页,那么最多只有 3 页空闲空隙的页更可能是碎片化的,因此是好的分配候选。在放射性衰变模型下,大空隙附近的分配和其他分配一样可能被释放,这会让大空隙显著增长,之后就可以用于大分配。所以那个 10 页的空隙很宝贵,除非别无选择,否则避免在它附近分配,让它有机会继续增长。
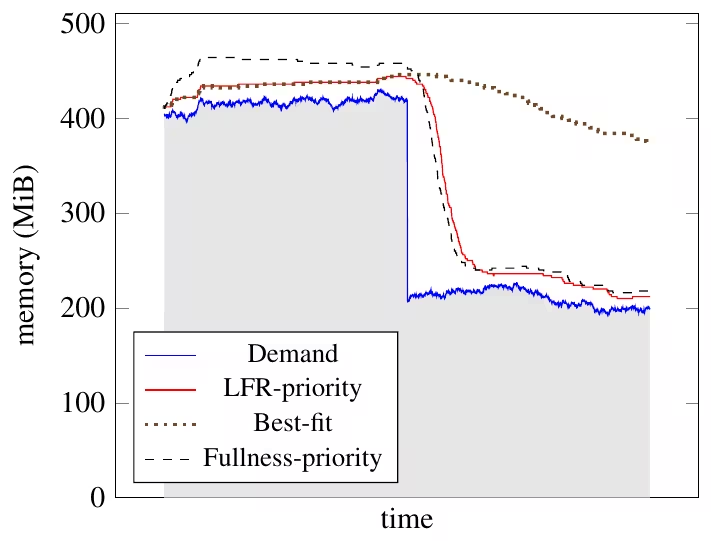
图 11:
HugeFiller使用不同装箱策略的效果。best-fit 不如按满度优先或按最长空闲区间(LFR)优先,而 LFR 优于按满度优先。
图 11 用合成轨迹(见 6.1 节)展示了这一点。轨迹中包含一次大幅的一次性下降和随机波动。LFR 优先算法胜过另外两种方法;特别是在用量下降后,best-fit 几乎没有回收任何内存,最终接近 100% 的开销,而另外两种算法都紧密跟随实际需求。令人惊讶的是,这个简单策略大幅超过了全局 best-fit(把请求放进所有大页中最接近其大小的那个空隙)。全局 best-fit 本身代价高得无法接受(不可能对每个请求都搜索 1 万到 10 万个大页),但它还会产生更高的碎片,这一点相当反直觉。
最后一个重要细节:被捐赠的大页是比任何非捐赠大页更不受欢迎的分配目标。考虑下面这个病态程序:
1 | while (true) { |
每次迭代净分配只有 1 页,但如果总是用 L 的 slack 来满足 S,最终每个 S 都会各自占据一个大页。实践中,只要在有其他可用大页时拒绝使用被捐赠的页就能避免这个问题,同时在需要时仍能有效利用 slack。
#4.5 HugeRegion
HugeCache(以及它背后的 HugeAllocator)足以处理大分配,因为向上取整到完整大页的代价很小;HugeFiller 很适合能塞进单个大页的小分配。HugeRegion 处理介于两者之间的情况。
考虑一个 1.1MiB 的请求。从 HugeFiller 满足它会在 2MiB 大页上留下 0.9MiB 的 slack。HugeFiller 假设这些 slack 会被将来的小分配(< 1MiB)填满,通常也确实如此:全集群观察到的小分配与 slack 的字节比为 15:1。但极端情况下,可能有一个程序只请求 1.1MiB 的 span(图 12)。
这个问题在一定程度上是 Temeraire 自己的选择造成的:它非常注重用 HugeFiller 把分配装进大页大小的容器,而用捐赠的 slack 来做这件事在某些分配模式下是灾难性的。大多数正常程序没有它也没问题,但通用分配器需要处理各种负载,包括被 slack 主导的负载。显然必须能跨大页边界分配。
HugeRegion 是一个大的固定大小分配(目前为 1GiB),以小页粒度跟踪,使用与 HugeFiller 中单个大页相同的位图。和单个大页一样,在 region 的所有页上对请求做 best-fit。region 列表按最长空闲区间排序,原因与 HugeFiller 相同。从这样更大的容器分配立即可以节省大量浪费:在最坏负载下,不再是每个大页损失 0.9MiB,而是每个 HugeRegion 损失 0.9MiB,只有约 0.1%(这正是 region 设计得很大的原因)。
大多数程序根本不需要 region。只有当累积的大量 slack 超过程序小分配的总量时,才会分配 region。全集群只有 8.8% 的程序会触发 region,但这个功能仍然重要:在这些程序中,53.2% 的分配由 region 满足。一个例子是键值存储:它以大块的形式把长期数据加载到内存中,同时为处理请求做少量短命的小分配。没有 region 时,请求相关的分配无法填满大分配产生的 slack。
#4.6 内存释放
如前所述,Release(N) 由支持线程以稳定的小流量周期性调用。Temeraire 实现 Release(N) 时通常只是从 HugeCache 中释放大页区间,并可能按前述方式缩小其上限。释放超过提示的 N 页也没关系,支持线程会把实际释放量作为反馈,调整后续调用以达到正确的总体速率。
如果 HugeCache 无法释放 N 页,HugeFiller 会对最空的大页做子释放(subrelease),只释放其中的空闲小页。
从部分填充的大页中归还小页是减少内存占用的最后手段,因为这个过程基本不可逆:只归还大页中的一部分小页,会让操作系统用剩余页的小页表项替换原来覆盖整个大页的单个页表项。这种单向操作会因 TLB miss 增加而拖慢对剩余内存的访问。即使之后复用了被释放的地址空间,Linux 内核仍会对仍在使用的页使用小页表项。
虽然 THP 机制可能重新组装大页,但这是不确定的,且依赖系统利用率。这里存在一个负反馈:高利用率场景恰恰会与 THP 的整理过程竞争并阻碍它,而这些场景本来最能从中受益。
HugeFiller 会单独对待被子释放过的大页:除非没有其他可用大页,否则不在上面分配。放在这些内存上的分配无法受益于大页,所以这样做既有助于性能,也让这些部分释放的大页有机会完全变空。
#5. 评估
作者在 Google 的 WSC 负载上评估了 Temeraire,关注 CPU 和内存两方面的节省。既然本文主张优先考虑负载效率而不是 malloc 自身的开销,评估主要看 IPC 指标(作为用户吞吐的代理),并尽可能获取应用层性能指标(如每核每秒请求数)。
#5.1 应用案例
作者与对性能敏感的应用合作,在其生产系统中启用 Temeraire 并测量效果。这些应用约占 WSC 中 10% 的周期和 15% 的内存。
| 应用 | 吞吐 | 平均延迟 | RAM 变化 | IPC 前 → 后 | dTLB 页表遍历 % 前 → 后 |
|---|---|---|---|---|---|
| Tensorflow | +26% | ||||
| search1† | −8.7% | 1.33 → 1.43 | 9.5 → 9.0 | ||
| search2† | −20% | 1.28 → 1.29 | 10.3 → 10.2 | ||
| search3† | −7% | 1.64 → 1.67 | 8.9 → 8.9 | ||
| ads1 | +2.5% | −14% | −6.9% | 0.77 → 0.84 | 38.1 → 15.9 |
| ads2 | +3.4% | −1.7% | −6.5% | 1.12 → 1.22 | 27.4 → 10.3 |
| ads3 | +0.5% | −0.2% | −0.8% | 1.36 → 1.43 | 27.1 → 11.6 |
| ads4 | +6.6% | −1.1% | −1.7% | 0.87 → 0.93 | 28.5 → 11.1 |
| ads5 | +1.8% | −0.7% | −1.1% | 1.16 → 1.16 | 21.9 → 16.7 |
| ads6 | +15% | −10% | −2.3% | 1.40 → 1.59 | 33.6 → 17.8 |
| Spanner | +6.3% | 1.55 → 1.70 | 31.0 → 15.7 | ||
| loadbalancer† | −40% | 1.38 → 1.39 | 19.6 → 9.5 | ||
| 平均(WSC 应用) | +5.2% | −7.9% | 1.26 → 1.33 | 23.3 → 12.4 | |
| Redis† / Redis | +0.75% / +0.44% |
表 1(节选):启用 Temeraire 后的应用实验结果。吞吐按 CPU 归一化。†:关闭了周期性内存释放的应用。dTLB 页表遍历为花在页表遍历(而非访问 L2 TLB)上的周期比例。
- 其中四个应用(search1/2/3 和 loadbalancer)此前关闭了 TCMalloc 的周期性内存释放。这让它们即使在旧的、对大页无感知的 pageheap 下也有很好的大页覆盖率,代价是内存。启用 Temeraire 后保持这一设置不变,它们保持了高 CPU 性能,同时减少了总内存占用。
- 对于 8 个开启了周期性释放的应用,平均 CPU 提升 7.7%,平均内存降低 2.4%。其中两个负载没有减少内存:Temeraire 的
HugeCache很好地处理了 Tensorflow 的分配模式,但无法改变其突发的需求;Spanner 会把缓存扩张到一定内存上限,所以降低 TCMalloc 的开销意味着在相同占用下能缓存更多应用数据。
#5.2 集群实验
作者随机选取了 WSC 中 1% 的机器作为实验组,另外 1% 作为对照组,在实验组的所有应用上启用 Temeraire,对照组继续使用原有的 pageheap。
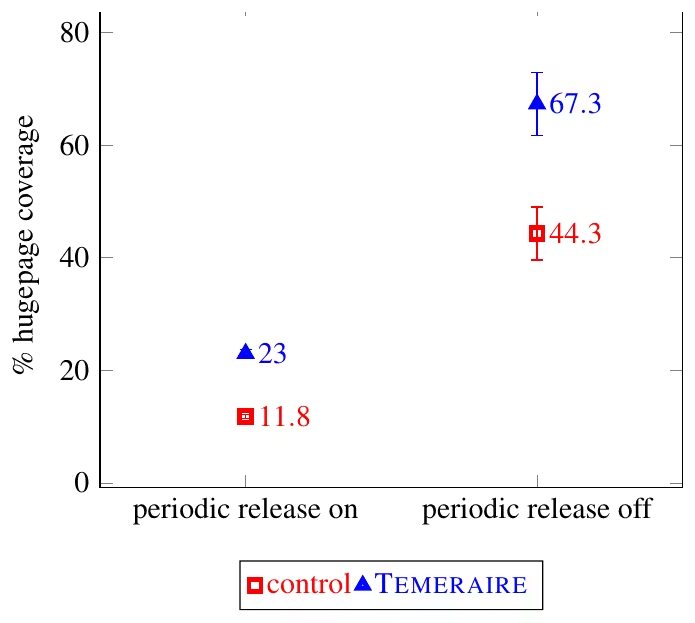
图 13:集群实验期间被大页支撑的堆内存比例及 90% 置信区间。
- 大页覆盖率:开启周期性释放的应用从 11.8% 提高到 23%;关闭周期性释放的应用从 44.3% 提高到 67.3%。
- 即使关闭了周期性释放,提升也很明显。这些程序在两种配置下都不会拆散大页,收益来自全系统大页可用性的提高(其他应用的碎片减少了):Temeraire 会积极释放空的大页(旧 pageheap 不会),消耗的不需要的大页更少,让其他应用能更成功地申请到大页;同时,同机部署的其他应用也不再以同样的速度拆散大页。
- TLB miss:页表遍历的 miss 周期减少了 4.5%–5%。
| 周期性释放 | 页表遍历周期 % 对照 | 实验 | MPKI 对照 | 实验 |
|---|---|---|---|---|
| 开 | 12.5 | 11.9(−4.5%) | 1.20 | 1.14(−5.4%) |
| 关 | 14.1 | 13.4(−5%) | 1.36 | 1.29(−5.1%) |
有点意外的是,不释放内存的应用(大页覆盖率更高)dTLB 停顿开销反而更高。与这些应用团队沟通后得知,他们关闭内存释放正是因为需要保证性能:这些应用平均有更复杂的访存模式,因而对微体系结构的波动更敏感。
- IPC:对照组全集群 IPC 为 0.796647919 ± 4e−9,实验组为 0.806301729 ± 5e−9,提升 1.2%。相对值不大,但绝对节省非常可观。
- 内存:pageheap 开销(pageheap 中已 backed 的内存与应用正在使用的堆内存之比)从 15.0% 降低到 11.2%。
#5.3 全面推广
基于单个应用和 1% 实验的数据,作者把默认行为切换为 Temeraire,并逐步推广到全部负载。
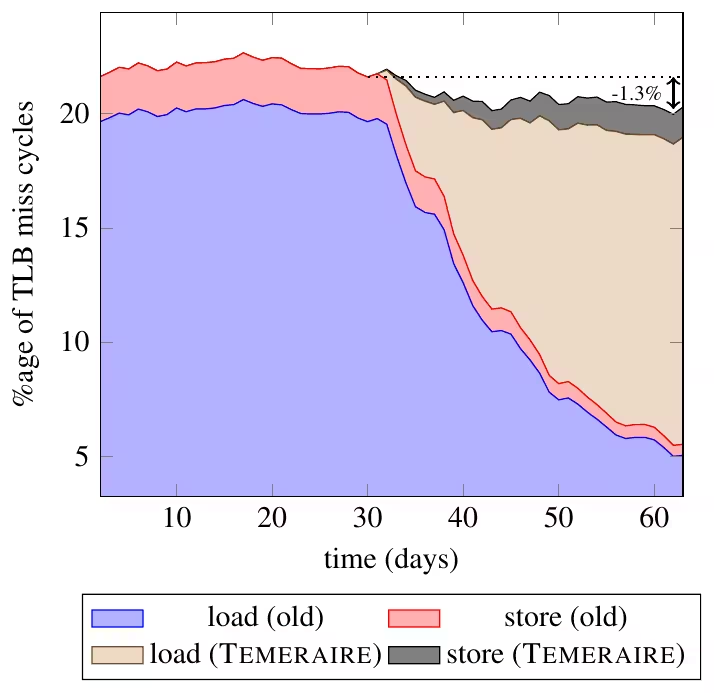
图 14:Temeraire 推广对 TLB miss 周期的影响(堆叠折线图)。随着 Temeraire 在 WSC 中占比增大,总体从 21.6% 下降到 20.3%。
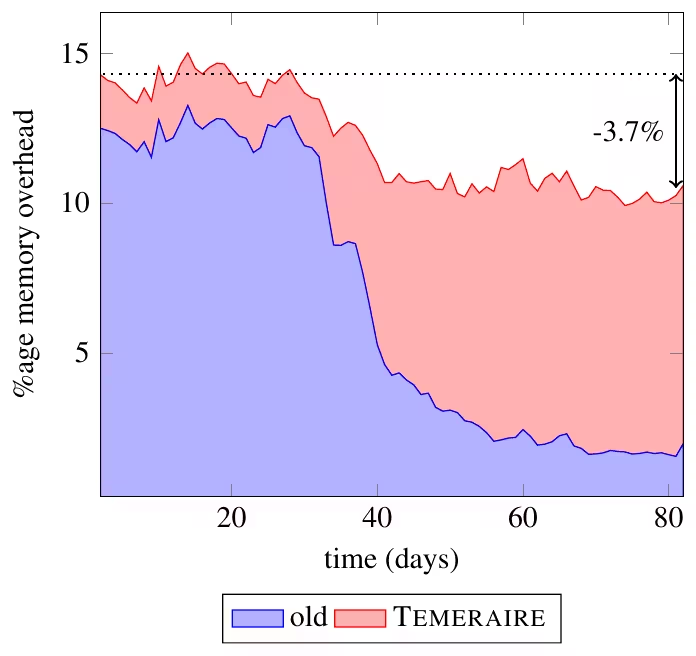
图 15:Temeraire 推广对 pageheap 开销的影响(堆叠折线图)。随着 Temeraire 从少数应用扩展到几乎所有应用,总内存开销从 14.3% 降到 10.6%。
推广期间,停顿在 TLB miss(L2 TLB 和页表遍历)上的周期从 21.6% 降到 20.3%(减少 6%),pageheap 开销从 14.3% 降到 10.6%(减少 26%)。大页优化在空间和时间之间本来有天然的权衡:节省最多的内存需要拆散大页,这会消耗 CPU 周期。但 Temeraire 在空间和时间两方面都优于之前的设计。几点结论:
- 应用生产力的提升超过了 IPC 的提升。简单的硬件指标并不总能准确反映应用层面的收益。
- 收益并非来自降低 malloc 的开销,而是来自加速用户代码,这有时非常剧烈,且是双向的。一个应用(ads2)的 malloc 周期从 2.7% 增加到 3.5%,看起来像是回退,但它获得了 3.42% 的 RPS 提升、1.7% 的延迟改善和 6.5% 的峰值内存降低。
- 仍有可观的提升空间。即使 Temeraire 很成功,由于物理内存连续性的限制,没有子释放时大页覆盖率也只有 67%,提高到 100% 能显著改善应用性能。
#6. 构建 Temeraire 的方法论
对一个复杂系统,很难事先预测最佳方案,迭代式的设计和改进是常用技术。军事飞行员发明了 OODA(Observe, Orient, Decide, Act)循环来衡量反应时间:看到新数据、分析、做出选择、付诸行动(产生新数据并继续循环)。更短的 OODA 循环对飞行员是巨大的战术优势,也能提升开发效率。优化自己的 OODA 循环,即多快能对一个设计选择形成洞见、评估其效果并迭代到更好的选择,是构建 Temeraire 的关键一步。
最终评估依赖生产服务器,但用它来测试中间想法既太扰动又太冒险;而 malloc 微基准在页级别又没什么意义。为此作者用轨迹从两方面驱动开发。
#6.1 "经验"分布采样
生产集群有一个全集群性能分析器,其中采集了带请求大小等属性的 malloc 样本,包括堆中当前存活数据的样本和 malloc 调用的样本,由此可以推出存活对象和 malloc 调用的经验尺寸分布。经验驱动器(empirical driver)以泊松过程生成 malloc 和 free 调用,复现这些分布,同时以一个任意的(平均)堆大小为目标。目标大小可以随模拟时间变化,以重现昼夜周期、瞬时使用或高启动开销等因素。
存活对象的平均数量 L 等于到达率 λ 与平均寿命 W 的乘积。要复现"存活对象中大小为 a 的占比为 pa"的分布,令 Wa = c · pa / λa 即可(c 是决定总堆大小的缩放参数)。
尽管叫"经验驱动器",它仍然是一个非常不真实的负载:给定大小的每个分配在每个时间步被释放的概率都一样,连续分配的大小之间也没有相关性,更不会复现每线程或每 CPU 的动态。尽管如此,它是让 malloc 承受极具挑战性的负载的一种快速高效的方式,并成功复现了真实负载的许多宏观特征。
#6.2 堆追踪
在不让插桩开销扰动负载本身的前提下追踪每一次 malloc 调用极其困难,长时间尺度下甚至不可行:典型应用每秒可以调用 malloc 数百万次。即使能无扰动地追踪,把这些轨迹实时或更快地准确回放到分配器中同样很难:很难让正确的线程组合在正确的 CPU 上、在正确的(相对)时间分配、访问和释放正确的缓冲区。
幸运的是,追踪 pageheap 要容易得多。它是一个单线程分配器,只有一小部分请求会调用它。回放也很简单:抽象让我们可以直接实例化和操作 pageheap 表示,而不必经过 malloc()。来自真实程序的轨迹,以及(令人意外地)来自经验驱动器本身的轨迹,在 Temeraire 的开发中起了重要作用。
Temeraire 的组件用地址范围 [p, p + K) 来满足 K 页的请求,但从不读写这段内存。这原本是为单元测试设计的,可以在不真正占用 64GiB 内存的情况下测试 64GiB 分配这类边界情况。但它对加速模拟也至关重要:经验驱动器需要几小时的工作,回放只需几分钟。
#6.3 遥测
全集群性能分析器本身就是设计分配器的强大工具:它揭示可以用来推导启发式的分配模式,可以验证关于典型(甚至可能)行为的假设,帮助识别哪些模式不重要可以忽略、哪些必须优化。除了显而易见的用途(例如按典型使用调整缓存大小,或根据分配大小的 CDF 确定"小"分配的阈值),每当对某个事实不确定时,第一步都是查询分析器。例如,作者通过查询页分配大小的比例,确认了填充 slack 的方法(4.5 节)对各种负载都有效。
作者团队对任何新项目的第一个问题都是:"应该向全集群分析器添加哪些指标?"他们持续暴露更多分配器内部状态和派生统计(如缓存命中率)。
#6.4 实验框架
作者还开发了一个实验框架,可以在集群规模上对实现或调优选项做 A/B 测试:在一小部分机器上启用或禁用实验组,不需要这些机器上的业务团队做任何操作。前面的 A/B 实验就展示了,即使对从不释放内存的作业,大页覆盖率也提高了,这是一种作用于邻近同机服务的效应,在单个服务的测试中很可能被忽略。
A/B 实验的两个显著优势:
- 降低重大行为变更的成本和不确定性:小规模的 1% 实验能在推出新默认值之前很早就发现潜在问题,成本低得多。
- 降低对容易测试的负载过拟合的可能性:针对贴近生产的压测调优对它们所代表的应用很好,但可能对其他负载不理想。A/B 实验可以确保优化对所有人平均来说是好的,并能发现(和修复)出问题的应用。
一个例子是 Kanev 等人提出的预取下一个对象:当 malloc 从空闲链表返回对象 i 时,预取对象 i + 1。预取需要及时:太早,数据可能在使用前被逐出缓存;太晚,程序就要等待。在返回对象 i 时预取 i 本身太晚了,因为用户代码几个周期内就会写这个对象,远早于预取完成;预取 i + 1 则让对象在下一次分配时已经进入缓存。尽管有相反的证据(它让微基准看起来更慢,并增加了表面上的 malloc 开销),作者仍然在 WSC 中为 TCMalloc 加入了这个预取,并借助上述方法证明了它在集群规模上提升了应用性能。
#7. 未来工作
- 峰值与均值:在峰谷之间快速振荡的作业,无法按其平均值来装箱。即使分配器能瞬间归还未用内存,作业调度器也来不及在它被再次需要前利用它,所以瞬时开销并不是现实的优化机会。这提示我们要衡量开销如何随时间变化,可能需要更慢的释放速率,或采用 Mesh 这样的压缩技术。
- 中间缓存与暴露空闲 span:TCMalloc 堆叠缓存的设计便于直接优化,扩展性好,但隐藏了有用的跨层信息。例如 Bigtable 的缓存区间是 8KiB 的 malloc 段(即一个 TCMalloc 页),以避免碎片。这意味着大多数被释放的缓冲区到不了本地缓存或 central freelist 之后,只有当整个 span 的对象同时被释放(且以某种方式被推出本地缓存)时,它们才会回到 pageheap。如果 pageheap 能看到每一次这类分配/释放,就能更精确地估计每个大页内的可用空间,从而减少碎片;但如果每次
malloc(8192)/free都走 pageheap,扩展性也就没了。是否存在折中? - 前期成本、摊销与预测:无法预测将来会有哪些
Delete()调用,是构建大页友好算法最难的部分。目前只能靠启发式和"希望":希望大部分为空的东西保持为空,希望最后的分配很快被释放。但有些分配很可能是永生的。如果知道(无论是否永生)某些分配会很热、被频繁访问,把它们放在大页上会带来更大的边际收益;而对较冷的分配,节省内存可能比降低访问延迟更划算。 - 远内存协作:远内存(far memory)可以把数据移到更慢但更便宜的内存上,降低 DRAM 成本。把很少访问的分配聚在一起能让远内存更有效。机器学习或 profile 引导的优化有望识别这些分配。
- 用户态与内核协作:Temeraire 的内存布局被设计为与内核大页策略兼容,但这只是隐式协作。如果内核 API 能优先在地址空间内或跨进程分配大页,就能主动管理哪些区域由大页支撑,而不是目前尽力而为的被动实现。一个常见问题是:最早在机器上运行的应用能占据大部分大页,即使之后被分配了更高优先级的应用。作者设想由一个独立的用户态守护进程与各应用协作,按更细的优先级、收益和价值梯度更智能地分配大页。
#8. 相关工作
- 用户态缓存效率:Dice 提出抖动分配大小以减少 L1 冲突;缓存索引感知分配器通过改变对象在页内的相对放置来减少冲突 miss;mimalloc 尽量从同一个 page 给用户分配对象以提高局部性。
- 内核侧:只在内核层面解决这个问题会面临同样的碎片挑战,而且更难处理,因为内核对应用内存使用的控制更少。内核可以用大页支撑一个内存区域,但如果应用不在该大页上密集分配,内存就会被碎片浪费。Ingens 尝试公平地分配有限的内核大页,HawkEye 管理内核大页分配以控制内存膨胀,Illuminator 改进内核的页决策以减少物理内存碎片,CoLT 提出可变大小大页。但内核方案会被那些把部分大页归还操作系统、且不在大页上密集打包的大页无感知用户态分配器所抵消。
- malloc 层面:SuperMalloc 考虑了大页,但只针对非常大的分配;LLAMA 研究了基于寿命预测的方案,但实用的方案仍是开放问题。
#9. 结论
在仓库级计算机中,TLB 查找开销是大型应用面临的最显著计算成本之一。Temeraire 通过改变内存分配器,使其在做出大页感知的放置决策的同时最小化碎片,从而优化了整个 WSC。关键负载的案例研究显示 RPS/CPU 提升 7.7%、RAM 降低 2.4%;集群规模实验和推广期间的纵向数据显示 TLB miss 周期减少 6%、碎片浪费的内存减少 26%。由于内存系统是 WSC 应用最大的瓶颈,通过改进分配器组织内存及与操作系统交互的方式,还有进一步加速应用的机会。
#读后总结
这篇论文最有意思的地方在于它换了优化目标:不再追求 malloc 本身更快,而是让 malloc 做出更好的放置决策,从而让应用的其余代码更快。哪怕 malloc 自身变慢(ads2 的 malloc 周期从 2.7% 涨到 3.5%),整体也是赚的。
Temeraire 的几个关键点:
| 问题 | 做法 |
|---|---|
| 大分配末尾的 slack 浪费 | 把尾部大页"捐赠"给 HugeFiller,用来装小分配 |
| 小分配放到哪个大页 | 按 (最长空闲区间 L, 分配数 A) 排序,优先填碎片化、分配多的页,保护长空闲区间 |
| 为什么用 A 而不是已用页数 U | 放射性衰变模型:分配越多的页越不可能被完全清空 |
| 1~2MiB 之间的中等分配 | slack 过多时改用 1GiB 的 HugeRegion 跨大页边界分配 |
| 空大页何时归还 OS | 2 秒滑动窗口内 demandmax − demandmin 作为 HugeCache 上限 |
| 不得已的子释放 | 只对最空的大页做,并且之后尽量不在其上分配 |
和 jemalloc、mimalloc 的对照:
- 三者都有"页级以上的后备分配"(span / extent / page),差别在于谁拥有它们:mimalloc 的 page 归线程所有,局部性好但难以跨线程紧密打包;TCMalloc 的 span 由全局 pageheap 管理,前端则是 per-CPU 缓存,这让 pageheap 有全局视角来做大页装箱。
- 论文脚注提到 jemalloc 正在参考 Temeraire 做大页感知的改造,后来的 jemalloc 中就出现了大页感知的页分配器(HPA)。
#参考文献
- A.H. Hunter, Chris Kennelly, Paul Turner, Darryl Gove, Tipp Moseley, Parthasarathy Ranganathan. Beyond malloc efficiency to fleet efficiency: a hugepage-aware memory allocator. OSDI 2021
- Sanjay Ghemawat, Paul Menage. TCMalloc: Thread-Caching Malloc. gperftools documentation
- Svilen Kanev, Sam Likun Xi, Gu-Yeon Wei, David Brooks. Mallacc: Accelerating Memory Allocation. ASPLOS 2017
- Youngjin Kwon, Hangchen Yu, Simon Peter, Christopher J. Rossbach, Emmett Witchel. Coordinated and Efficient Huge Page Management with Ingens. OSDI 2016
- Daan Leijen, Benjamin Zorn, Leonardo de Moura. Mimalloc: Free List Sharding in Action. MSR-TR-2019-18
- Jason Evans. A Scalable Concurrent malloc(3) Implementation for FreeBSD. BSDCan 2006