[NSDI'25] ByteCheckpoint: A Unified Checkpointing System for Large Foundation Model Development 论文阅读
论文:ByteCheckpoint: A Unified Checkpointing System for Large Foundation Model Development(NSDI’25)
作者:Borui Wan(港大)、Mingji Han、Yiyao Sheng、Yanghua Peng、Haibin Lin、Mofan Zhang、Zhichao Lai、Menghan Yu、Junda Zhang、Zuquan Song、Xin Liu(字节跳动)、Chuan Wu(港大)
#摘要
在大基础模型(LFM)的开发过程中,checkpoint 不仅用于故障后恢复训练,还要应对 GPU 资源和并行配置的变化,并且会被下游的评估、后训练等任务直接读取。随着训练规模扩大,checkpoint 系统必须足够高效,才能在整个开发周期内管理好海量 checkpoint。
ByteCheckpoint 是一个工业级的 LFM checkpoint 系统,主要特点:
- 与并行度无关的 checkpoint 表示,支持高效的加载时 resharding;
- 通用的保存/加载流程,同时适配多种训练框架和存储后端;
- 全栈优化,保证 I/O 效率与可扩展性;
- 一套监控工具,用于大规模下的性能分析与瓶颈定位。
与开源方案(PyTorch DCP、Megatron MCP)相比,checkpoint 阻塞时间平均降低 54.20×,保存和加载时间分别最多加快 9.96× 和 8.80×。
#1. 背景与动机
#1.1 LFM 的开发流程与 checkpoint
一个 LFM 从预训练到上线大致经过:预训练 → 持续预训练(如长上下文扩展)→ 后训练(SFT、奖励模型、PPO/DPO 等),每个阶段都会穿插自动评估任务,周期性地拉取中间 checkpoint 来评估模型质量。规模上,DeepSeek-V3 有 671B 参数、在 14.8T token 上预训练;单个训练任务可以用到 12288 张 GPU。
需要 checkpoint 的训练状态分两类:
- GPU 状态:模型参数和优化器状态(如 Adam 的 fp32 主权重、一阶和二阶动量),在各种并行策略下被切分到多张 GPU 上;
- CPU 状态:dataloader、随机数生成器(RNG)状态、全局步数、学习率调度器等。其中 dataloader 内部有一个 token buffer,缓存从各数据源读来的、长度不一的样本,攒够一个上下文窗口的 token 才拼成一个 micro-batch。
生产环境中,正式任务的 checkpoint 存放在独立的分布式文件系统里(HDFS、NAS,Meta 训练 Llama 3.1 用的是 Tectonic),以便保存多个历史版本。
#1.2 为什么需要 resharding
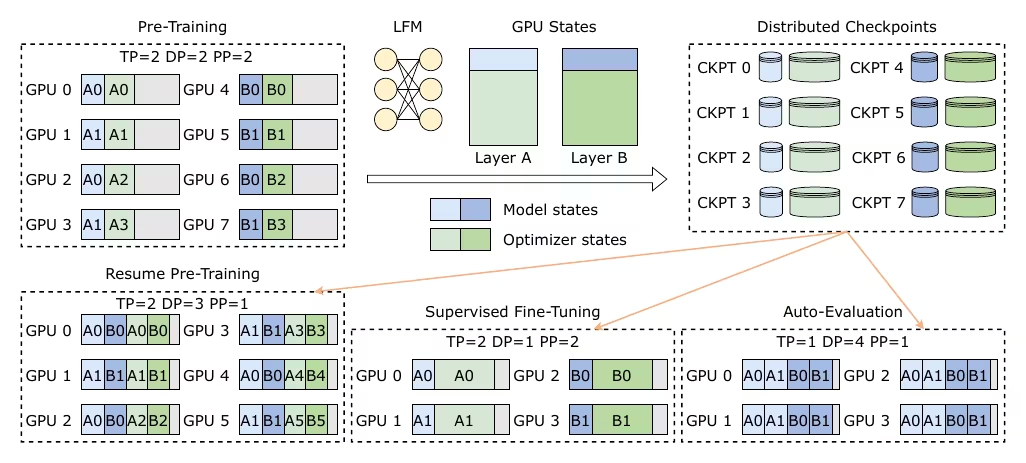
checkpoint resharding 指把按某种并行配置保存的分布式 checkpoint,转换成能被另一种并行配置正确加载的形式。这在 LFM 开发中非常常见:
- 恢复训练:剔除故障机器、获得新释放的机器、使用潮汐资源都会让 GPU 配额变化;大规模训练开始时,工程师也常常需要反复尝试不同的并行配置和优化手段(小规模的 profiling 结论不一定能迁移到大规模);长上下文训练改变上下文长度后同样需要调整并行度;
- 跨阶段切换:后训练数据量小得多,通常用更少的 GPU,预训练 checkpoint 必须重新切分;
- 评估:评估任务在独立资源上做推理,并行度要和分到的 GPU 匹配。
作者统计了平台上过去半年的 resharding 需求:预训练恢复 1870 次、跨阶段切换 13080 次、评估 19844 次。
#1.3 需求
加载时 resharding。以前平台上的做法是写离线 resharding 脚本,每遇到一种新场景就改一次脚本,再单独提交一个任务:下载 checkpoint → 按新并行度重切 → 上传回存储,然后目标训练或评估任务才能开始。这既费人力(附录提到,为了覆盖 TP/PP/虚拟流水线、分布式优化器、GQA/MLA 等各种组合,最大的脚本有 3193 行 Python),又浪费 GPU 时间:三种场景下离线 resharding 任务的平均完成时间分别为 1870s、650s、593s。而且产出的 checkpoint 又绑定在新的并行度上,无法复用,还增加了存储开销。
更好的做法是加载时(在线)resharding:加载时自动从已有的分布式 checkpoint 中找出并读取需要的数据。前提是 checkpoint 的存储表示必须与具体并行度无关。
多框架、多存储后端。根据近半年的 trace 统计,平台上主流的训练框架有三个:
| 框架 | 近半年预训练任务数 | 近半年后训练任务数 | 平均每任务 GPU 数 |
|---|---|---|---|
| Megatron-LM | 13727 | 68621 | 301 |
| FSDP | 16842 | – | 25 |
| DDP | 25393 | – | 6 |
Megatron-LM 用于训练大语言模型,FSDP 多用于文生视频、文生语音,DDP 常用于多模态模型的图像编码器或日常算法验证。存储从调试用的本地盘到正式任务用的 HDFS、NAS 都有。每个框架都有自己的 checkpoint 模块和文件格式,但都缺少生产必需的特性(加载时 resharding、异步 checkpoint、远程持久存储)。为每个框架分别补齐这些特性,工作量会成倍增加,接口也会越来越乱。
高效、可扩展的 I/O。在 4096 张 GPU 上训练 GPT 175B,把 checkpoint 存进 HDFS 平均要 200 秒,远超单个迭代的时间。异步 checkpoint 可以把大部分开销移出关键路径,但端到端时间依然重要:checkpoint 完成得越快,故障发生前就能存下越新的状态,丢失的训练进度越少;评估任务也能更早拿到 checkpoint。此外,许多在小规模下看不出来的问题,到了大规模会变成严重瓶颈甚至导致任务失败:海量文件请求压垮 HDFS 的 NameNode,朴素的集合通信(如完整性检查的 barrier)初始化和同步开销巨大乃至超时。
CheckFreq、Check-N-Run、Gemini 等已有系统都假设并行度不变;DCP 和 MCP 支持 resharding,但支持的并行策略和框架有限,I/O 性能和可扩展性也不够。
#2. 系统设计
设计原则有两条:
- 解耦:checkpoint 表示与运行时并行度解耦,训练框架和存储后端的接口与核心执行引擎解耦;
- 易用:API 简洁,方便研究人员直接集成。
#2.1 统一架构
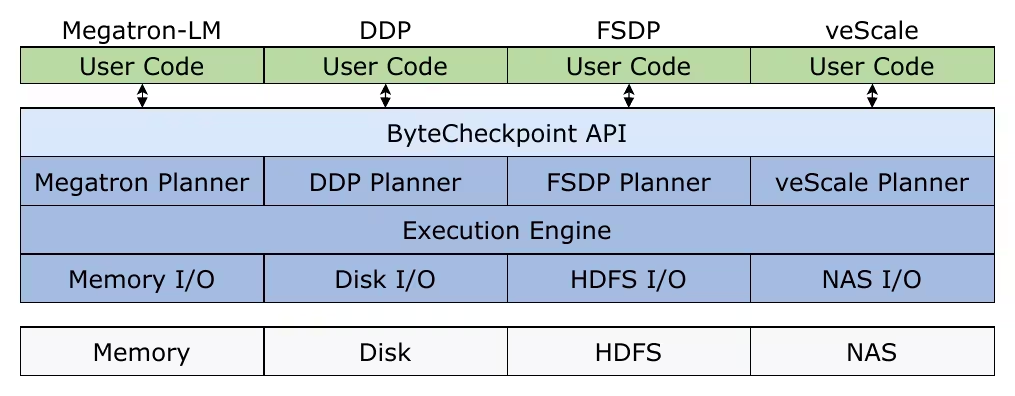
自上而下分为四层:
- API:
bytecheckpoint.save和bytecheckpoint.load两个统一入口。用户把模型、优化器、dataloader、额外状态放进一个字典,指定路径、框架名和性能选项即可; - Planner:对接训练框架。根据 rank 和框架特定的切分描述(如 Megatron 的
ShardedTensor、FSDP 的DTensor)为每个张量分片生成ShardMeta,并决定每个 worker 存取哪些张量和状态。每个 worker 先生成本地计划,再协作生成全局计划。每个框架有一个专门的 Planner; - Execution Engine:运行在每个训练 worker 上,执行 Planner 生成的计划,根据路径选择存储后端;
- Storage I/O:封装不同后端的读写与优化,对 Engine 暴露统一接口,支持内存、本地盘、HDFS、NAS 等。
典型用法是:在恢复训练、阶段切换或评估开始时调用 load,若并行度变了会自动 resharding;训练过程中周期性地调用 save(可开启异步保存)。
#2.2 与并行度解耦的 checkpoint 表示
设计与 PyTorch Distributed 的 Distributed Tensor 和 Checkpoint 概念保持一致。
模型与优化器状态。每个张量由全限定名(FQN)唯一标识,并有一个全局形状(切分之前的形状)。张量要么被切分、要么被复制;某个 rank 上的分片由三个因素决定:所用的并行方式(如 TP)、切分维度、该 rank 在对应并行组中的组内 rank。据此,每个分片可以用一个与并行度无关的三元组描述:
即该分片在全局张量各维上的起始偏移和长度。
Dataloader 与额外状态。dataloader 状态分为两类:
- 复制状态:读取进程数、数据源路径、采样比例等,各 rank 一致,只由 rank 0 保存一份;
- 分片状态:每个 I/O worker 独有的 token buffer 和各数据源的读取偏移,各自存为单独的文件。
拆开存放既减少了总体积,也让并行度变化时合并、重新分配这些状态变得简单。RNG 等其他额外状态则打包序列化为一个字节对象。
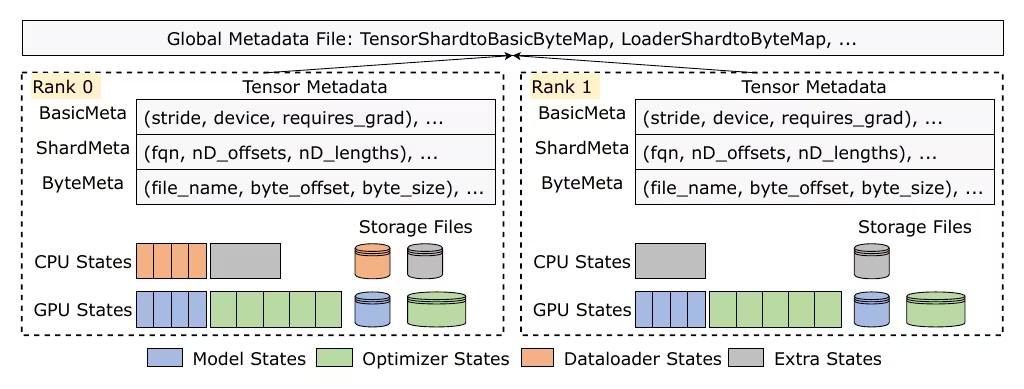
整体格式:一个分布式 checkpoint = 一个全局元数据文件 + 多个存储文件。每个 rank 生成模型状态、优化器状态、额外状态三个文件;dataloader 状态文件只由除 DP 外其余并行维度 rank 都为 0 的 worker 生成。每个张量分片的元数据有三部分:
| 元数据 | 内容 | 作用 |
|---|---|---|
| BasicMeta | stride、device、requires_grad 等 | 恢复运行时张量 |
| ShardMeta | fqn、nD_offsets、nD_lengths | 分片在完整张量中的位置 |
| ByteMeta | 文件名、字节偏移、字节长度 | 分片在存储文件中的位置 |
所有元数据汇总到全局元数据文件中,形成 TensorShardToBasicByteMap;另有 LoaderShardToByteMap 记录 dataloader 分片状态的文件索引。
不规则张量的分解。在 ZeRO(Megatron-LM 的 ZeRO-2、FSDP 的 ZeRO-3)中,一个 DP 组内的优化器状态会先被展平、拼接,再均匀切分。切出来的一维片段往往无法还原成 n 维的形状加偏移,作者称之为不规则张量。
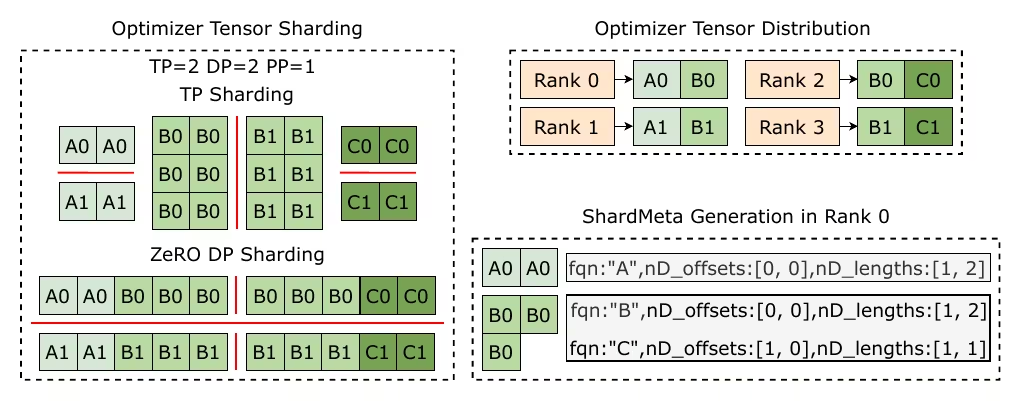
例如形状为 (3, 2) 的张量 B 被均分成两片,每片 3 个元素,这不是一个合法的二维矩形块。
- DCP 的做法是在保存前把分片合并成完整张量:FSDP 对每个分片做同步 all-gather,并穿插 D2H 拷贝,不管它是否真的不规则。通信开销大,GPU 与 CPU 之间还要频繁同步;
- ByteCheckpoint 的做法是分解:把一个不规则分片拆成若干个规则的矩形块,每块各用一个
ShardMeta描述。比如 rank 0 上 B 的 3 个元素拆成一个 1×2 的块加一个 1×1 的块。代价是元数据稍大,加载时可能要多查找几个小片段,但保存时完全不需要通信,也没有额外阻塞。
#2.3 加载时 resharding 流程
得益于 Engine、Planner、Storage I/O 三层相互独立,不同框架和存储后端都走同一套保存/加载流程。以张量 resharding 为例:
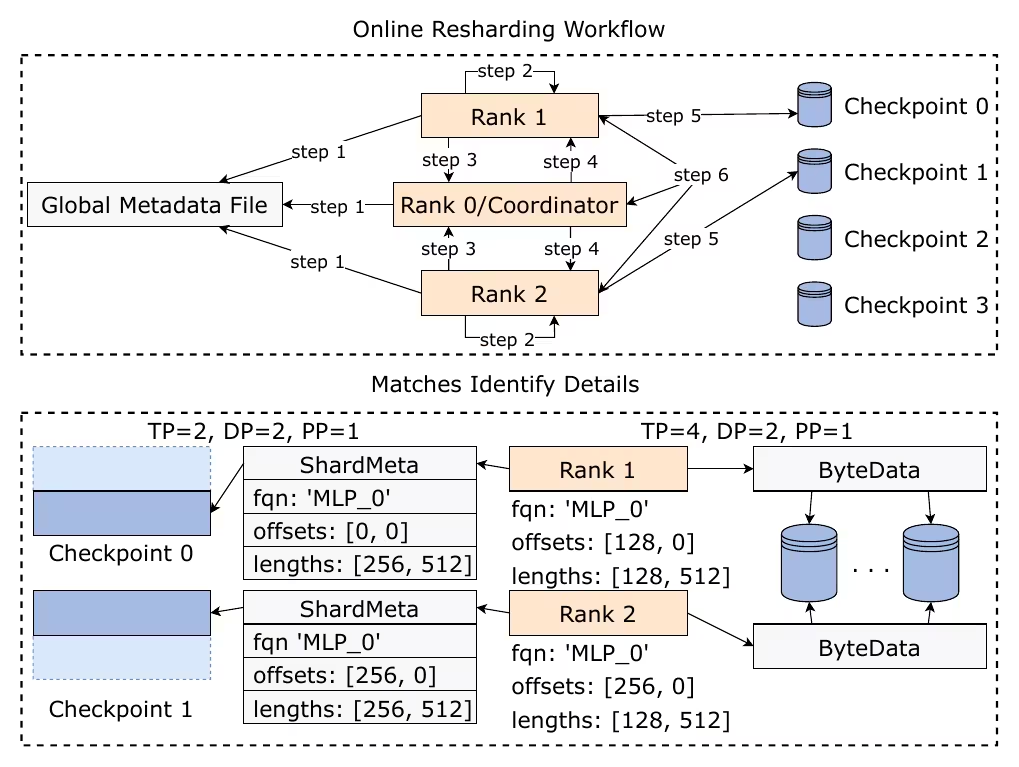
- 每个 rank 调用
bytecheckpoint.load(),读取全局元数据文件; - 对新模型/优化器中的每个分片,查询
TensorShardToBasicByteMap,找出与新分片有交集的已存分片,生成包含相应 BasicMeta 和 ByteMeta 的本地加载计划。例如原来 TP=2 时某个分片覆盖第 0–255 行,现在 TP=4 时新分片只需要第 128–255 行,那就只读那一段字节; - 协调者(通常是 rank 0)gather 所有本地计划,做去冗余优化(见 3.1 节),把读取负载分摊出去;
- 协调者把最终计划 scatter 回各 rank;
- 各 rank 的 Engine 根据路径选择存储后端,执行加载流水线(见 3.2 节);
- 加载完成后通过优化过的异步 barrier 保证分布式加载的原子性。
Dataloader resharding 同理,通过 LoaderShardToByteMap 进行:公共部分直接加载,token buffer 和读取偏移这些独有部分需要重新分配。
- DP 度不变、其他并行度变化(例如 TP 变了):把 token buffer 原样拷贝到对应的新 worker,保证逐比特一致地恢复;
- DP 度变化:token buffer 需要相应地拆分或合并,确保恢复后的 dataloader 既不丢弃已缓存的数据,也不重复训练已经喂过的数据。
#3. 性能优化
#3.1 计划生成的优化
保存负载均衡。有 DP 时模型状态在各 DP 组之间是重复的。DCP 和 MCP 的做法是让第一个 DP 组保存全部模型状态,这会让它成为拖慢整体的 straggler。ByteCheckpoint 在规划阶段用 Worst-Fit 算法去重:协调者按张量分片的大小依次分配,每次把当前分片交给累计保存量最小的 rank,使保存负载在所有 worker 之间均衡。
消除冗余读取。加载到含 DP 的并行配置时,同一个分片会被多个 DP 组重复读取。ByteCheckpoint 在规划时把读取任务在 DP 组之间平均分配,每个分片只读一次;读进来之后利用空闲的 GPU 间带宽,通过 all-to-all 发给其他需要它的 worker。读文件与 GPU 间传输同时进行。
计划与元数据缓存。在 8960 张 GPU 上训练 405B 模型时,一次保存的规划就需要 62 秒。但在同一次训练会话中,保存计划和全局元数据是固定不变的,于是第一次生成后缓存下来,后续保存直接复用,规划变成一次性开销。
#3.2 全异步的执行流水线
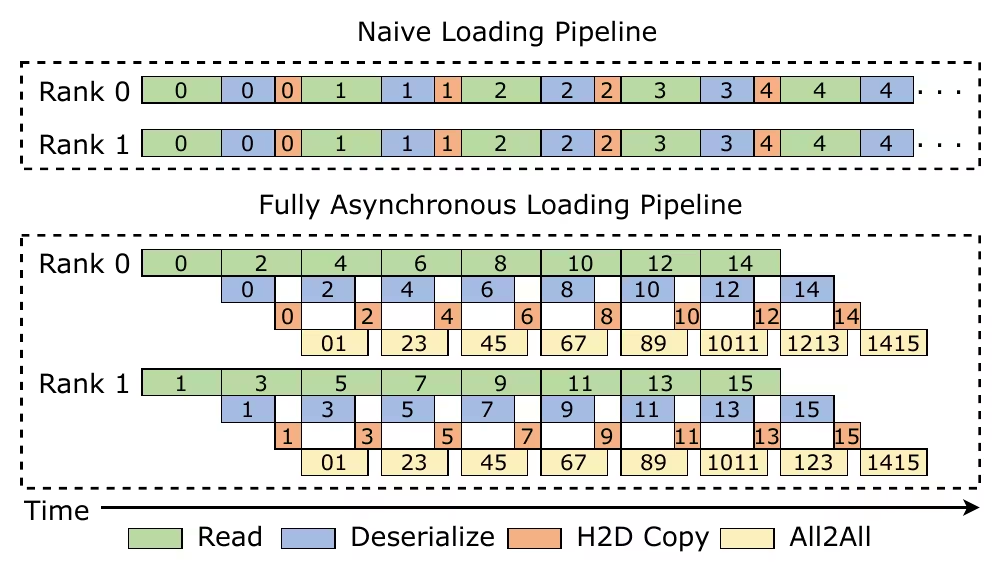
以加载为例,每个张量分片要经过读文件 → 反序列化 → H2D 拷贝 → All2All四个阶段。朴素实现中这些阶段串行执行;ByteCheckpoint 让不同分片的不同阶段相互重叠:
- 读文件:从存储系统下载到共享内存(
/dev/shm),多线程并行; - 反序列化:从共享内存反序列化张量,多线程并行;
- H2D 拷贝和 All2All 在 GPU 侧接着做。
保存则是对称的 D2H 拷贝 → 序列化 → 上传流水线:
- D2H 使用预分配的 pinned 内存池 + Ping-Pong 双缓冲,把对训练的阻塞压到最小;
- 多个进程并行序列化并写入共享内存;
- 上传线程监听写入完成事件,随即开始上传。
#3.3 高性能读写
针对 HDFS 做了专门优化:
- 读:HDFS 并不擅长随机读,但其 SDK 支持从指定偏移读取。ByteCheckpoint 利用这一点多线程读同一个文件,单文件读速度从 400MB/s 提升到 2–3GB/s(H800 机器,100+ CPU 核、TB 级内存、200Gbps 网卡);
- 写:HDFS 只支持追加写,无法按偏移多线程写同一个文件。于是把文件切成固定大小的子文件并发上传,再在 NameNode 上做元数据级的拼接(concat)合并成一个文件。无网络拥塞时单文件上传可达 3GB/s,而单个 HDFS 客户端平均读写吞吐不到 100MB/s。
#3.4 预取 dataloader 状态
dataloader 由多个读取子进程组成。checkpoint 时主进程要通知所有子进程准备状态,期间训练必须暂停,否则主进程的更新会改变子进程的状态。4 个 worker、约 1GB 状态时,这一过程要 8 秒左右。
由于 checkpoint 频率是预先设定的,ByteCheckpoint 让每个读取子进程在 checkpoint 的前一个训练步就准备好状态并放入队列;到了 checkpoint 那一步,主进程直接轮询队列取走即可,状态收集的延迟几乎为零。
#4. 大规模下的工程经验
#4.1 存储侧
高吞吐、可扩展的 HDFS:
- 用 C++ 重写了 NameNode、DataNode 和 SDK,性能相比原来的 Java 实现提升约一倍;
- 引入 NNProxy:一个无状态的 NameNode RPC 代理,支持大规模联邦部署 NameNode,解决海量 checkpoint 文件带来的元数据 QPS 瓶颈,同时提供鉴权、限流和元数据查询缓存;
- 优化后的 HDFS 容量达数百 PB,读写带宽约 10TB/s,元数据 QPS 约 10 万。
冷却策略:SSD + HDD 两级冷热存储。观察到新写入的 checkpoint 很快会被评估任务读取,之后如果没有出现 loss spike 等异常,就很少再被访问,但为了可追溯又必须保留。于是按最后修改时间把超过保留期限的文件从 SSD 迁到 HDD,并通过纯元数据操作把原路径重映射到新位置,用户无感知。
#4.2 集合通信
规划阶段的 gather/scatter 和完整性检查的 barrier 都依赖集合通信。
- 最初用 NCCL:扩展到 8960 张 GPU 时,NCCL 懒建立通信通道、分配显存要花很长时间,scatter/gather 需要协调者与每张 GPU 建立点对点连接,有时甚至卡死或 CUDA OOM。这些问题在小规模试验中完全看不出来;
- 改用 gRPC:规划阶段不再占用显存。但到了上万张 GPU,集中式的 gather/scatter 仍会压垮协调者;
- 最终采用树形分层通信拓扑:单机内的 worker 组成第一层子树,local rank 0 为根;机器之间再逐层分组,每组以全局 rank 最小的 worker 为根,直到汇聚到全局根(协调者)。在 3D 并行中,这样自然形成一棵 TP-DP-PP 通信树。
附录还提到,Megatron-LM 等框架用 torch.distributed 的 barrier 做完整性检查,在约 1 万张 GPU 时每次会阻塞约 20 秒。ByteCheckpoint 用同样的 gRPC 树形通信重新实现 barrier,并异步执行完整性检查,彻底消除了这部分阻塞;同时为 I/O worker 加了上传/下载重试,并记录失败发生在流水线的哪个阶段。
#4.3 监控与分析
- 数据采集:基于 Python 上下文管理器和装饰器的指标系统,自动记录每个操作的耗时、I/O 大小、rank、文件路径、当前步数等,通过后台消息队列发往远端数据库;
- 可视化:提供按并行拓扑排列的全 rank 热力图和单个 rank 的分阶段耗时时间线,便于定位 straggler 节点或慢阶段。例如热力图上 rank 0、4、8、12 的保存时间最长,因为它们还要保存 dataloader 状态;
- 存储侧监控:客户端以 I/O chunk 为粒度记录每次读写的延迟和大小,汇总到 ClickHouse 分析,延迟异常或带宽过低时告警;集群侧关注元数据 QPS、整体吞吐和容量使用率。
#5. 评估
ByteCheckpoint 基于 DCP 实现,约 2 万行 Python 代码。
负载:
- vDiT 4B:基于 DiT 的视频生成模型,在 A100 上用 FSDP(ZeRO-2)微调,32/128 卡保存,resharding 到 64 卡;
- tGPT 70B:基于 GPT-3 结构的文本生成模型,在 H800 上用 Megatron-LM 训练,2400 卡(TP=4, DP=75, PP=8)与 4800 卡(DP=150)之间互相 resharding。
基线:FSDP 对比 DCP,Megatron-LM 对比 MCP。两个基线都不支持 HDFS,作者用相同的线程数、分块大小等配置为它们补上了 HDFS 访问;它们也不支持 dataloader 状态,所以主要比较 GPU 状态。端到端指标用 ETTR(有效训练时间占比),按照 Gemini 的方法,假设每个 checkpoint 间隔内都发生一次故障并取平均:
其中 为 checkpoint 间隔步数, 为单步迭代时间;表中 ETTR 是普通加载和 resharding 两种情况的平均值。
#5.1 端到端效果
| 负载 | 基线 | 阻塞时间 | 保存时间 | 加载时间 | resharding 时间 | ETTR |
|---|---|---|---|---|---|---|
| vDiT 4B / 32 卡 | DCP | 16.25s → 0.54s(30.09×) | 3.16× | 4.29× | 4.68× | 38.60% → 46.22% |
| vDiT 4B / 128 卡 | DCP | 61.37s → 0.38s(161.50×) | 9.96× | 8.80× | 6.67× | 41.62% → 48.92% |
| tGPT 70B / 2400 卡 | MCP | 4.73s → 0.39s(12.13×) | 2.21× | 1.41× | 2.03× | 34.61% → 40.18% |
| tGPT 70B / 4800 卡 | MCP | 4.70s → 0.36s(13.06×) | 8.87× | 2.00× | 1.19× | 31.28% → 40.29% |
几点观察:
- 阻塞时间从秒级甚至分钟级降到亚秒级;
- 保存加速随规模增大:tGPT 从 2400 卡的 2.21× 提升到 4800 卡的 8.87×,因为 DP 越大,负载均衡去重越有效;
- FSDP 场景阻塞时间降幅尤其大,因为 DCP 处理不规则张量时需要大量通信和同步,规模越大越严重;而 ByteCheckpoint 的分解策略在生成元数据时完全不需要通信;
- 加上 dataloader 等 CPU 状态(full states)后,加载和 resharding 时间明显变长:文生视频训练中 token buffer 可达 20GB,而且只有部分 worker 持有 dataloader 状态,它们容易成为 straggler。作者把更高效的 dataloader 设计留作未来工作。
#5.2 微基准
| 优化 | 负载 | 效果 |
|---|---|---|
| 异步保存 | tGPT 13B / 30B | 保存加快 1.45× / 1.81× |
| + 负载均衡 + 计划缓存 | 同上 | 累计 2.52× / 2.50×,平均保存时间 48.3s → 19.27s |
| 异步加载 + 读传重叠 | 同上 | 加载加快 1.53× / 1.58× |
| 不规则张量分解 vs all-gather + D2H | ZeRO-2 32/64 卡 | 0.21s vs 4.12s,0.19s vs 5.84s(平均 25.15×) |
附录中对 rank 0 的保存时间拆分也显示:规划的通信开销随规模增长,但缓存后变成一次性开销;pinned 内存池让 D2H 阻塞几乎可以忽略;异步流水线让序列化、写共享内存、HDFS 上传相互重叠;负载均衡使 4800 卡时模型状态的上传速度是 2400 卡时的 3.03 倍。
#5.3 正确性
- TP、PP、DP 以及混合 resharding 后,tGPT 13B 的 loss 曲线能平滑衔接之前的趋势(DP 增大时全局 batch 变大,loss 下降更快);
- 并行度不变时恢复训练,在 2080 张 H800 上训练 175B 模型的真实生产任务中,恢复前后的 loss 逐比特一致;
- dataloader 也能逐比特恢复:RNG 状态固定时,多次重启前后的样本长度曲线完全相同。
#5.4 真实生产中的规模与问题
| 模型 | GPU 数 | 并行 | 阻塞 | 保存 | 加载 |
|---|---|---|---|---|---|
| Vision Transformer 7B(FSDP) | 1488 | ZeRO-2 | 0.34s | 20.13s | 265.73s |
| Text Transformer 405B(Megatron-LM) | 8960 | TP=8, DP=70, PP=16 | 0.59s | 51.06s | 129.49s |
即使在 8960 卡规模,平均阻塞时间也保持在 600ms 以内。部署中通过监控工具发现并解决的问题:
- dataloader straggler:为了支持 resharding,dataloader 状态被拆成多个小文件(tGPT 实验中是 6 个),串行上传带宽利用率很低。在 7B 视觉模型上,dataloader 状态的上传时间占总保存时间的 73.16%。改用进程池并发上传后大幅缓解;
- HDFS 元数据瓶颈:NameNode 上的 concat 操作是串行执行的,checkpoint 文件一多就成了瓶颈,改成并行执行;另外 HDFS SDK 为了方便用户封装了大量保护逻辑(检查、创建父目录、校验目标文件),带来很多多余的元数据操作。ByteCheckpoint 预先确保目录存在、文件名唯一后再调用 HDFS API,单个文件写入的最大元数据开销从 3s 降到 150ms。
#6. 相关工作
- checkpoint 框架:
torch.save/load基于 pickle,没有分片的全局元数据,无法自动 resharding;DCP 把元数据与张量数据分开存放,支持 FSDP 的 resharding,但不支持 TP、PP;DeepSpeed-UCP 通过离线脚本 resharding;MCP 在 DCP 流程之上扩展了 Zarr 等格式。ByteCheckpoint 采用 DCP 的表示并补上了不规则张量的处理,还能导出 Safetensors 格式,方便接入 Hugging Face 生态; - checkpoint 优化:Check-N-Run 针对推荐模型做差分 checkpoint 和量化;CheckFreq 让快照与计算流水并行,并在线调节 checkpoint 频率;Gemini 做内存 checkpoint 并跨机备份;JIT-Checkpointing 在出错时即时保存;ServerlessLLM 优化推理场景的分块多级加载。它们大多假设并行度不变;
- 存储系统:Meta 用 Tectonic 存放 Llama 3.1 的 checkpoint,DeepSeek 的 Fire-Flyer 使用自研的 3FS;
- 弹性训练:Varuna、Bamboo、Oobleck 等只支持特定的并行策略(如不带 ZeRO 的 DP),可以借助 ByteCheckpoint 的表示获得更大的灵活性。
#读后总结
这篇论文读起来更像一份扎实的工业系统经验报告,而不是单点的算法创新。核心思想其实很朴素——把"数据在哪"(ByteMeta)和"数据是什么"(ShardMeta)分开存——但把它在生产环境中真正做通,需要大量的工程打磨。
几个印象深刻的点:
- resharding 是刚需,而不是边缘场景。半年 3.5 万次 resharding 需求、最大 3193 行的离线脚本,说明在真实的 LFM 开发流程中,并行度几乎从来不是固定的。把 resharding 从"写脚本、提交任务"变成"加载时自动完成",节省的是人力和 GPU 时间两方面的成本;
- 不规则张量用"分解"代替"合并"。ZeRO 展平切分带来的一维片段是 DCP 在 FSDP 上的主要开销来源。ByteCheckpoint 不去还原完整张量,而是把一维片段拆成若干个矩形块,用稍大的元数据换取保存时零通信,这个取舍很漂亮;
- dataloader 状态是被低估的难点。很多 checkpoint 系统只管模型和优化器,但要逐比特恢复训练,token buffer 和读取偏移同样必须保存和 reshard。它体积大(可达 20GB)、只集中在少数 worker 上,至今仍是端到端时间的主要瓶颈之一;
- 规模本身就是 bug 的来源。NCCL 做控制面通信会 OOM、集中式 gather 压垮协调者、barrier 每次阻塞 20 秒、NameNode 串行 concat、SDK 的多余元数据操作……这些问题在小规模测试中都看不到。解决办法也很"系统":控制面改用 gRPC + 树形拓扑,数据面用 HDFS 的偏移读和子文件拼接,再加上可视化监控来定位问题;
- 存储系统需要与训练系统协同设计。C++ 重写 HDFS、NNProxy 联邦、SSD→HDD 冷却,可以看出 checkpoint 性能有相当一部分来自存储侧。这也和 Meta 的 Tectonic、DeepSeek 的 3FS 一样,说明大模型训练基础设施里,存储已经是和计算、网络同等重要的一环。
可以与 Megatron-LM 对照阅读,理解 TP/PP/DP 下参数和优化器状态具体是如何切分的;HDFS 的 NameNode/DataNode 架构可参考 HDFS 论文笔记。
#参考文献
- Borui Wan, Mingji Han, Yiyao Sheng, et al. ByteCheckpoint: A Unified Checkpointing System for Large Foundation Model Development. NSDI 2025
- PyTorch Distributed Checkpoint (DCP). https://pytorch.org/docs/stable/distributed.checkpoint.html
- Jayashree Mohan, Amar Phanishayee, Vijay Chidambaram. CheckFreq: Frequent, Fine-Grained DNN Checkpointing. FAST 2021
- Assaf Eisenman, Kiran Kumar Matam, Steven Ingram, et al. Check-N-Run: A Checkpointing System for Training Deep Learning Recommendation Models. NSDI 2022
- Zhuang Wang, Zhen Jia, Shuai Zheng, et al. GEMINI: Fast Failure Recovery in Distributed Training with In-Memory Checkpoints. SOSP 2023
- Samyam Rajbhandari, Jeff Rasley, Olatunji Ruwase, Yuxiong He. ZeRO: Memory Optimizations Toward Training Trillion Parameter Models. SC 2020
- Mohammad Shoeybi, Mostofa Patwary, Raul Puri, et al. Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism. arXiv 2019