[ASPLOS'24] Characterizing a Memory Allocator at Warehouse Scale 论文阅读
论文:Characterizing a Memory Allocator at Warehouse Scale(ASPLOS’24)
作者:Zhuangzhuang Zhou(Cornell,工作完成于 Google 实习期间)、Vaibhav Gogte、Nilay Vaish、Chris Kennelly、Patrick Xia、Svilen Kanev、Tipp Moseley、Parthasarathy Ranganathan(Google),Christina Delimitrou(MIT)
代码:所有改动均已合入 google/tcmalloc
这篇可以看作 Temeraire(OSDI’21) 的续作,作者团队高度重合。Temeraire 只改了 TCMalloc 最底层的 pageheap,而这篇先用全集群遥测把 TCMalloc 从上到下"体检"了一遍,然后给每一层缓存都提出了一个改进。
#摘要
内存分配是仓库级计算(WSC)中很大的一块开销。优化分配器不仅能降低"数据中心税",还能通过更好的数据局部性提升应用本身的性能。
本文是第一篇针对 TCMalloc 在 Google 生产集群中的全面特征分析。分析发现:WSC 负载在分配模式、对象大小、对象生命周期上差异巨大,所运行的硬件平台也高度异构。基于这些发现,作者对 TCMalloc 的各级缓存做了针对性改进:
- 按使用率动态调整 per-CPU 缓存的大小;
- 利用硬件拓扑减少跨核(跨 LLC 域)的数据搬运;
- 利用统计数据改进 span 与大页的装箱(packing)算法。
通过全集群 A/B 实验评估,整体吞吐提升 1.4%、内存降低 3.4%;对 malloc 用量最高的应用,吞吐最高提升 8.1%,内存最高降低 6.3%。
#1. 动机:优化"生产力"而不是 malloc 本身
数据中心税指序列化、RPC、压缩、哈希、数据搬运、内存分配这类所有服务都要交的公共开销。因为 WSC 的负载极其分散,优化某一个应用对整个集群几乎没有影响;而优化公共库则能惠及所有应用。
以往对分配器的研究大多关注分配器自身花了多少时间,或者用分配模式很单一的 benchmark 来测。作者认为这不够:
- malloc 本身只占集群约 4.3% 的周期,就算降到零,收益也有限;
- 而已有研究表明 WSC 应用 20%–64% 的流水线停顿来自后端(主要是 cache miss)。分配器决定了对象放在哪里,直接影响 cache 和 dTLB 的局部性,杠杆更大。
所以本文的优化目标是应用生产力(每个应用自定义的吞吐指标,比如每秒处理的 RPC 数),而不是 malloc 的 CPU 占比。这与 Temeraire 的思路一脉相承:哪怕 malloc 自己变慢一点,只要应用整体更快就值得。
#2. 背景与方法
#2.1 TCMalloc 架构
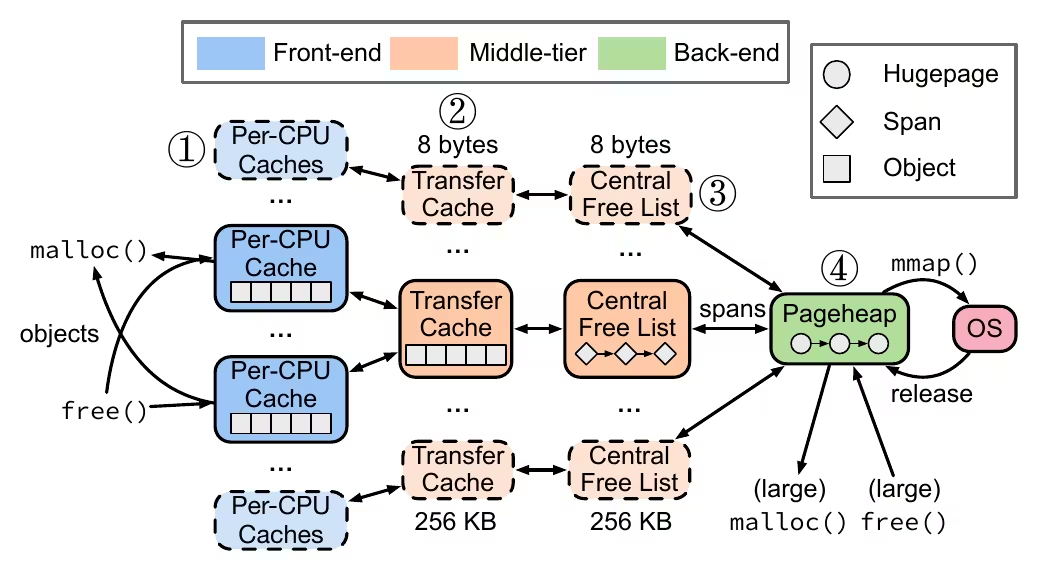
TCMalloc 把 ≤256KB 的小对象向上取整到 80–90 个 size class 之一,每个 size class 分别经过三层缓存,大对象则直接走 pageheap:
| 层级 | 组件 | 特点 |
|---|---|---|
| 前端 | ① per-CPU cache | 一整块连续内存按 CPU 切分,每个 CPU 存放各 size class 的空闲对象指针;借助 rseq 无锁访问,快路径约 40 条手写 x86 指令 |
| 中间层 | ② transfer cache | 用扁平数组存放空闲对象,有锁;让对象在不同 CPU 之间快速流转(CPU 0 分配、CPU 1 释放) |
| 中间层 | ③ central free list | 以链表管理 span,从 span 中切出对象;span 是对齐到 8KB TCMalloc 页的连续区域,只装同一 size class 的对象 |
| 后端 | ④ pageheap | 以大页(2MB)为单位管理内存,从大页中切出 span 回填 central free list,并定期把内存还给 OS |
注意 TCMalloc 的"页"是 8KB,等于两个 x86 原生页,不要和系统页混淆。另外,TCMalloc 现在默认用 per-CPU cache 做前端,早已不是"Thread-Caching"了——per-thread 缓存在线程空闲时会把内存"困住",线程数上千时扩展性也很差,名字其实已经名不副实。
两种碎片:
- 外部碎片:被分配器缓存着、但还没分配给应用的内存,例如大页里没切出去的区域、span 里空闲的对象槽位;
- 内部碎片:请求大小被取整到 size class 后多出来的那部分 slack。
#2.2 特征分析方法
- 持续剖析:使用 Google-Wide Profiling(GWP),每天随机挑 1%–10% 的机器短时间采集剖析数据,开销可忽略;
- 集群 A/B 实验:每个设计随机选 1% 机器作为实验组、另 1% 作为对照组,在真实负载下比较。之所以必须做全集群实验,是因为 WSC 没有"杀手级应用":malloc 周期排名前 50 的二进制只覆盖约 50% 的 malloc 周期和 65% 的已分配内存;
- 通用性:虽然研究对象是 TCMalloc,但 jemalloc、mimalloc 等现代分配器同样是多级缓存结构(如 jemalloc 的 thread cache + arena,按 region/run/extent 组织内存),结论大体可迁移。
评估所用负载包括 5 个 malloc 用量最高的生产服务——Spanner、Monarch(监控时序库)、Bigtable、F1 Query、Disk(底层分布式存储)——以及 4 个单机 benchmark:Redis、单进程 word count 数据处理流水线、图像处理服务、TensorFlow Serving(InceptionV3)。
#3. 总体特征
#分配延迟
用微基准测量命中各层缓存的平均分配延迟:
| 命中层级 | 延迟 |
|---|---|
| per-CPU cache | 3.1 ns |
| transfer cache | 59.9 ns |
| central free list | 78.5 ns |
| pageheap | 136.9 ns |
| mmap 向 OS 要 2MB 大页 | ~12917 ns |
层与层之间是数量级的差距,这正是用户态分配器需要多级缓存的原因。
#malloc 的 CPU 开销
- 全集群 4.3% 的 CPU 周期花在分配与释放上,Top 5 应用在 3.6%–10.1% 之间;
- 对比之下,SPEC CPU2006 的大多数程序在稳态下几乎不分配也不释放,malloc 周期接近 0,不适合用来研究分配器。
malloc 周期的构成(全集群):
- per-CPU cache 占 53%——绝大多数请求在这里命中,符合预期;
- central free list 占 12%——链表操作比数组贵;
- transfer cache、pageheap 各占 3%;
- 采样占 4%:每分配 2MB 采样一次并记录调用栈,用于分析内存用量和查内存泄漏;
- 预取竟占 16%:每次分配时 TCMalloc 会预取下一个将要返回的同 size class 对象。当前对象来不及预取(应用几个周期后就会访问它),但预取下一个可以让它在下次分配前进入 cache。看上去贵,但它是降低数据 cache miss 的关键。
#内存碎片
碎片率定义为碎片内存与应用实际使用内存之比。全集群碎片率为 22.2%,其中外部碎片 18.8%、内部碎片 3.4%;Top 5 应用在 11.2%–42.5% 之间。
按组件拆分碎片来源:
- pageheap 占 51%:为了保住大页覆盖率,它倾向于等整个大页空了再归还,代价是内存闲置;拆开大页做 subrelease 则会降低大页覆盖率。TCMalloc 选择了逐步释放、尽量保持大页完整;
- central free list 占 29%:只有 span 上所有对象都被释放,span 才能还给 pageheap,一个长寿对象就能钉住整个 span;
- 内部碎片占 15%:更细的 size class 能减少取整浪费,但每多一个 size class,前端和中间层就多一组空闲链表,外部碎片随之增加,对象复用率也降低。size class 的选择本质上是在内外碎片之间做权衡。
#对象大小分布
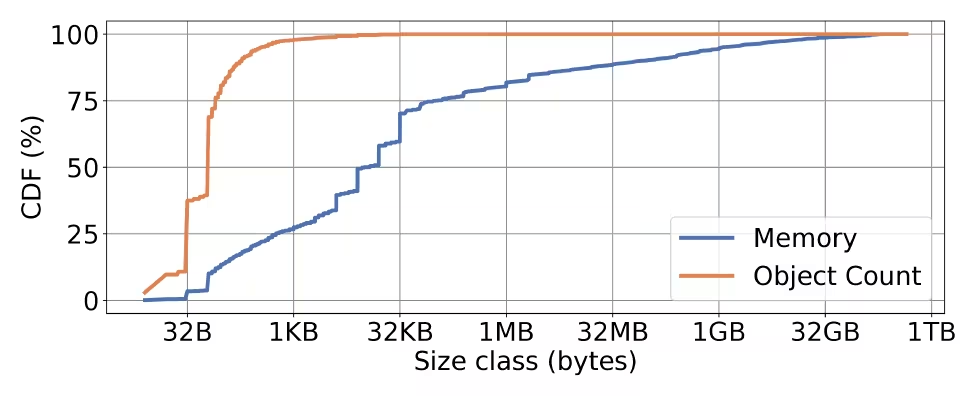
- 小于 1KB 的对象占对象数的 98%,但只占内存的 28%;
- 大于 8KB 的对象占了一半内存;
- 超过 256KB、绕过缓存直接走 pageheap 的大对象占 22% 内存。
因此缓存容量应该优先照顾小 size class,以降低整体分配延迟。
#对象生命周期分布
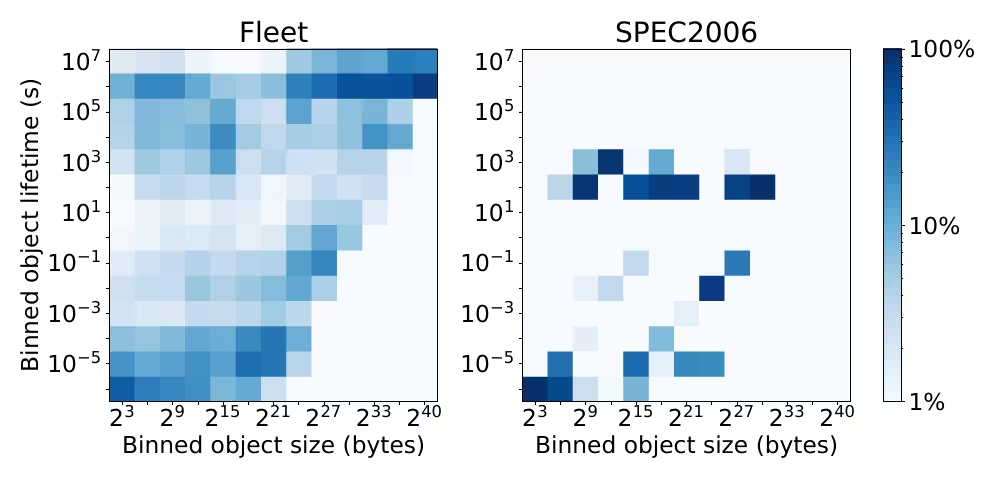
- 生命周期极其多样:同一大小区间内,既有活不到 1ms 的,也有活超过 7 天的;
- 小对象(≤1KB)大多短命,46% 活不过 1ms;
- 大对象倾向于长寿,大于 1GB 的对象有 65% 活过 1 天;
- SPEC2006 的分布则单调得多:要么与程序同寿,要么极短命。
这种多样性意味着,把生命周期相近的对象放在一起可能显著降低外部碎片。
#4. 逐层特征分析与改造
#4.1 Per-CPU Cache:异构的动态容量
vCPU。容器化部署下,应用往往被调度器限制在机器的一部分 CPU 上。而近五代平台每台服务器的超线程数涨了 4 倍,如果为每个物理 CPU 都初始化一份 per-CPU cache,元数据和缓存会白白膨胀。TCMalloc 因此使用内核提供的 virtual CPU ID(rseq 的扩展):内核在进程私有的编号空间里分配稠密的 vCPU ID。应用只跑在两个核上,就只会看到 vCPU 0 和 1,无论实际是哪两个物理核。
问题:缓存利用率严重不均。默认每个 per-CPU cache 静态上限为 3MB。但 vCPU ID 是稠密分配的,低编号的 vCPU 总是先被占用:
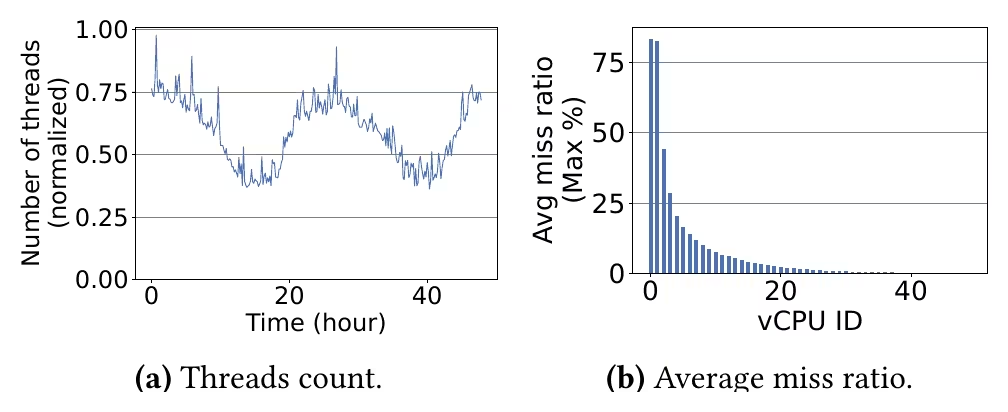
线程数随着负载尖峰和昼夜周期持续波动。一阵突发流量会让高编号 vCPU 的缓存被填满,但负载回落后这些缓存就很少再被使用。从 miss 分布上看,vCPU 0 的 miss 最多,编号越高 miss 越少——这里的 miss 指因容量不足而落到 transfer cache 的分配或释放。高编号的 cache 同样占着 3MB 上限,却几乎没被用到。
方案:异构 per-CPU cache。
- 每 5 秒统计每个 per-CPU cache 的 miss 数,作为利用率的代理指标(直接统计请求数会拖慢快路径);
- 后台线程每个周期挑出 miss 最多的前 5 个 cache 作为扩容候选,然后轮询其他 cache,从中"偷"容量;
- 缩容时优先缩大 size class 的容量,因为绝大多数分配是小对象。
效果:动态调整提高了容量利用率,于是作者顺势把每个 per-CPU cache 的默认上限从 3MB 砍半到 1.5MB,且不影响性能。前端缓存的少了,下游的 transfer cache、central free list、pageheap 也连带少囤内存。全集群内存降低 1.94%,Top 5 应用降低 0.58%–2.45%;三个多线程 benchmark 降低 2.08%–2.66%(Redis 是单线程,只用一个 per-CPU cache,不参与比较)。
#4.2 Transfer Cache:NUCA 感知
背景:chiplet 与 NUCA。摩尔定律放缓之后,CPU 厂商纷纷采用 chiplet 架构来提升扩展性、降低制造成本。这类平台在一个 socket 内有多个 LLC 域,形成非一致缓存访问(NUCA)。作者用 Intel MLC 在生产平台上测得:跨 LLC 域的核间数据传输延迟是 110.7ns,是同域(53.6ns)的 2.07 倍。而大型 WSC 应用往往跨多个 LLC 域运行。
问题:原来的 transfer cache 是全局唯一的。在 chiplet 上,某个 LLC 域里释放的对象,可能被另一个域的核拿去用,访问时就得从远端 LLC 取数据。
方案:NUCA 感知的 transfer cache。
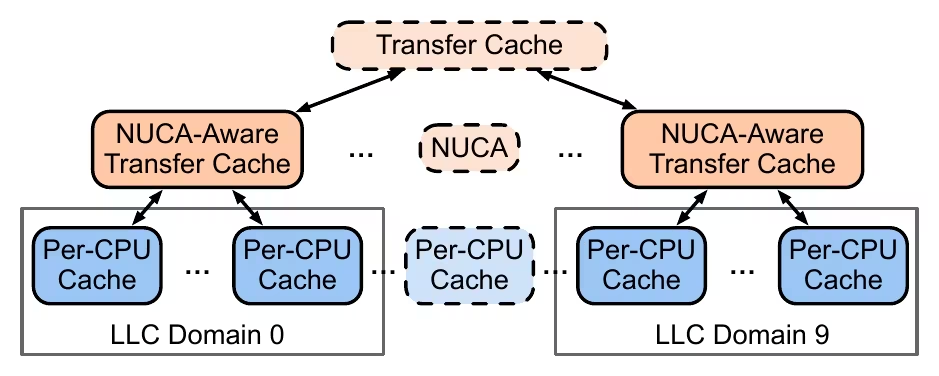
- 为每个 LLC 域维护一个本地 transfer cache,只服务本域 CPU 的分配与释放请求;
- 只激活应用实际被调度到的域对应的缓存,并定期释放其中未使用的对象,防止内存被困住;
- 保留原来的全局 transfer cache 作为后备,因为它仍然比 central free list 便宜。
效果(全集群):LLC load miss 率降低 4.37%,吞吐提升 0.32%,代价是多一层缓存带来的 0.10% 内存增长。Top 5 应用吞吐提升 0.28%–1.72%,CPI 降低 0.42%–3.32%;benchmark 吞吐提升 1.37%–3.80%。用一点点内存换取更多的应用吞吐,总体上节省了服务器资源。
#4.3 Central Free List:按占用度给 span 排优先级
问题:span 只有在其上所有对象都释放后才能归还给 pageheap,而同一个 size class 内对象的生命周期也千差万别,长寿对象会把 span 钉住。可以用生命周期标注(编译器引导或应用指定)把长短命对象分开放,但已有的机器学习预测方案运行时开销很大。
观察:用两周的集群遥测统计"span 上的存活对象数"与"该 span 最终被归还的概率"之间的关系。以 16B size class 为例(一个 8KB span 最多 512 个对象),存活对象越多,span 被归还的概率越低。
而原来的 central free list 每个 size class 只有一条单链表,总是从表头的 span 分配。结果可能恰好从一个快空了、马上就能归还的 span 上分配,把它重新钉住。
方案:span 优先级。
- 把单链表拆成 条链表,存活对象数为 的 span 放进下标为 的链表;
- 取对数让"对象少"的 span 区分得更细,而存活 132 个和 255 个对象的 span 反正都不太可能被释放,放进同一条链表即可。实验表明 已足够;
- 分配时从下标最小(即最满)的非空链表取 span;每次分配和释放后按需在链表间移动 span。
这样新分配会被密集地塞进本来就满、本来就不太可能被释放的 span,而快空的 span 得以真正变空并归还。
效果:全集群内存降低 1.41%,Monarch 降低 2.76%,其他应用降低 0.34%–2.54%,吞吐不受影响;benchmark 内存降低 0.61%–1.36%。
#4.4 Pageheap:生命周期感知的 HugeFiller
Temeraire 的 pageheap 由三部分组成(详见 Temeraire 笔记):
- HugeFiller:处理小于一个大页的请求,把 span 装进大页;
- HugeRegion:处理略大于大页的请求(如 2.1MB),把它们装进一段连续的大页;
- HugeCache:处理至少一个大页的大请求,尾部产生的 slack(例如 4.5MB 分配剩下的 1.5MB)捐赠给 HugeFiller。
pageheap 占了外部碎片的 51%,而其中 HugeFiller 管理着 83.6% 的已用内存,贡献了 94.4% 的 pageheap 碎片,因此重点改造 HugeFiller。
问题:HugeFiller 原本优先从分配数多的大页上切 span(与 4.3 节同样的思路),但它假设所有 span 被释放的可能性相同且相互独立。事实并非如此。
观察:span 容量是生命周期的好代理。span 容量指一个 span 最多能装多少个该 size class 的对象(例如 8KB span 能装 1024 个 8B 对象)。
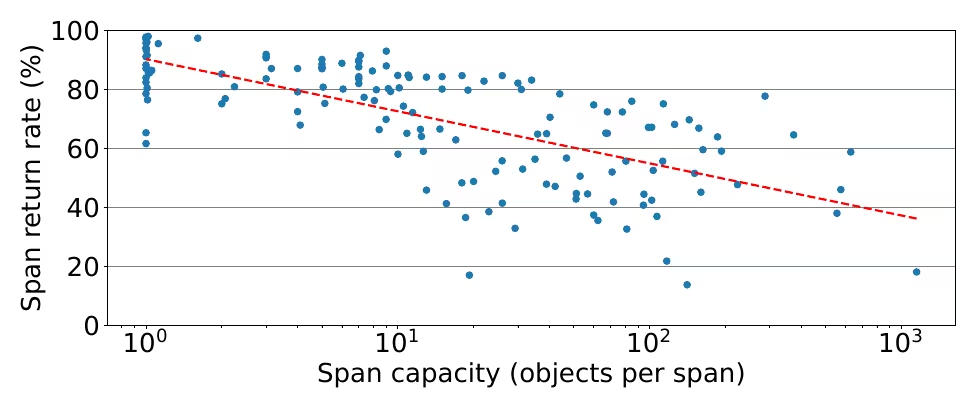
span 容量与归还率呈强负相关(Spearman 相关系数 −0.75):
- 只能装 1 个对象的 span(大 size class),对象一释放 span 就空了,归还率很高;
- 能装成百上千个对象的 span,要等所有对象都释放才能归还,几乎总是长寿的。
用 span 容量而不用对象生命周期,有两个原因:span 的寿命取决于其上最后一个对象,对象生命周期不能直接代表 span 生命周期;而且 span 容量是静态已知的,零运行时开销,不需要编译器或应用提供标注。
方案:以容量阈值 为界,容量 的 span(短命)和容量 的 span(长寿)分别从两组不同的大页上分配,每组各自维护一套链表结构;组内仍优先从分配数最多的大页上分配。实验取。
这样短命 span 被密集地放在专用大页上,更容易整页变空、以完整大页归还 OS,从而提高大页覆盖率。另外,小 size class 的对象访问密度更高,把它们的 span 集中起来也能更好地利用有限的 TLB 表项。
效果(基线为 Temeraire):
- 全集群吞吐提升 1.02%,内存降低 0.82%;
- Top 5 应用吞吐提升 0.38%–6.29%,CPI 降低 0.99%–17.61%;
- 大页覆盖率从 54.4% 提升到 56.2%,dTLB load walk 周期减少 2.94%,dTLB miss 减少 8.1%;
- benchmark 吞吐提升 1.05%–3.91%,内存降低 1.29%–7.02%。
这再次印证了本文的论点:分配器在数据局部性和 TLB 效率上的杠杆,远大于 malloc 自身 CPU 开销的优化空间。
#4.5 汇总
| 层级 | 观察 | 改造 | 集群收益 |
|---|---|---|---|
| per-CPU cache | 负载动态变化,低编号 vCPU 的缓存被用得多 | 按 miss 动态调整容量,默认上限 3MB→1.5MB | 内存 −1.94% |
| transfer cache | chiplet 跨 LLC 域传输慢 2.07× | 每个 LLC 域一个本地 transfer cache | 吞吐 +0.32% |
| central free list | 存活对象越多的 span 越难归还 | 按存活对象数分 8 条链表,优先填满的 span | 内存 −1.41% |
| pageheap | span 容量越大越长寿 | 按容量(阈值 16)分组到不同大页 | 吞吐 +1.02%,内存 −0.82% |
这些设计在两年内逐步推广到全集群。由于 WSC 负载一直在变,很难做严格的端到端对比,作者按各项的相对提升估算总体效果:集群吞吐提升 1.4%、内存降低约 3.5%(摘要写 3.4%);Top 5 应用吞吐提升 0.7%–8.1%,内存降低 1.0%–6.3%。
#5. 讨论
- Room at the top:硬件红利放缓后,性能提升要更多来自软件栈的上层。通过全集群剖析找到公共库的"横向"优化机会,是一种可规模化的方法;
- 数据中心税 vs. 生产力指标:数据中心税能帮你找到最大的公共构件,但只盯着降低税本身收益有限——malloc 降到零也只省 4.3% 的 CPU,而 20%–64% 的周期停顿在内存上;
- NUMA 及更远:TCMalloc 已经内置 NUMA 模式(为每个 NUMA 节点复制一套 size class 和页分配器,保证分配本地内存),本文的 NUCA 感知 transfer cache 则把这一思路延伸到了 cache 层面;
- 与内核协作:rseq 实现无锁 per-CPU 快路径,vCPU ID 压缩前端缓存,THP 提供大页覆盖。用户态分配器的性能离不开内核特性;
- 生命周期与访问密度:未来可以引入用户标注或 profile 引导的生命周期、访问密度信息,进一步改进放置决策。
#6. 相关工作
- 数据中心负载剖析:Kanev 等人对 Google 数千个服务的剖析提出了"数据中心税"的概念;Sriraman 等人对 Meta 微服务做了类似分析。但这些工作只关心分配器消耗的 CPU 周期,本文补充的是生产环境中多样的分配行为;
- 现代分配器:jemalloc(Meta)强调避免碎片与可扩展并发;mimalloc(微软)让同一页内的对象一起分配以提升局部性;Hoard 关注线程争用与伪共享;Mesh 通过重映射虚拟页实现压缩;snmalloc 用批量消息传递把释放发回原线程;
- 大页支持:Ingens 把内存连续性当作一等资源来管理;Contiguitas 把可移动与不可移动的分配放到不同区域。用户态分配器同样受益于这些内核侧优化。
#读后总结
这篇论文的价值主要在两方面:一是第一次公开了 TCMalloc 在 Google 全集群上的"体检报告",二是展示了一套"特征分析 → 洞察 → 改造 → 全集群 A/B"的方法论。几个值得记住的数字:
- malloc 占集群 4.3% CPU,per-CPU cache 快路径 3.1ns,mmap 要 13μs;
- 碎片率 22.2%,其中 pageheap 占一半,central free list 占近三成;
- 98% 的对象小于 1KB,但只占 28% 的内存;
- 预取下一个对象就占了 16% 的 malloc 周期。
四个改造背后其实是三条通用原则:
- 适应动态负载:静态容量配置在负载波动时必然浪费,要按实际使用(miss)来分配容量;
- 感知硬件异构:chiplet/NUCA 让"全局共享"的缓存变成了跨域搬运,需要按拓扑分片;
- 利用生命周期做装箱:central free list 和 HugeFiller 的改造本质相同——把不太可能被释放的东西挤在一起,让可能被释放的东西真正空出来。关键在于找到廉价的生命周期代理:前者用 span 上的存活对象数,后者用 span 容量,都不需要任何额外标注,运行时开销为零。
和 Temeraire 一样,单项收益看起来只有 1% 左右,但在 Google 的规模下,1% 的 CPU 或内存就意味着可观的服务器成本。另外,论文中的设计都已开源进 google/tcmalloc,读源码时可以和本文对照着看。
#参考文献
- Zhuangzhuang Zhou, Vaibhav Gogte, Nilay Vaish, et al. Characterizing a Memory Allocator at Warehouse Scale. ASPLOS 2024
- A.H. Hunter, Chris Kennelly, Paul Turner, et al. Beyond malloc efficiency to fleet efficiency: a hugepage-aware memory allocator. OSDI 2021
- Svilen Kanev, Juan Pablo Darago, Kim Hazelwood, et al. Profiling a warehouse-scale computer. ISCA 2015
- Akshitha Sriraman, Abhishek Dhanotia, Thomas F. Wenisch. SoftSKU: Optimizing server architectures for microservice diversity @scale. ISCA 2019
- Jonathan Corbet. Extending restartable sequences with virtual CPU IDs. LWN, 2022
- Martin Maas, David G. Andersen, Michael Isard, et al. Learning-based memory allocation for C++ server workloads. ASPLOS 2020
- Youngjin Kwon, Hangchen Yu, Simon Peter, et al. Coordinated and Efficient Huge Page Management with Ingens. OSDI 2016