[VLDB'24] Bf-Tree: A Modern Read-Write-Optimized Concurrent Larger-Than-Memory Range Index 论文阅读
Bf-Tree 是 UW-Madison 的 Xiangpeng Hao(在微软研究院实习期间)与微软研究院的 Badrish Chandramouli(FASTER 的作者)在 VLDB 2024 发表的 B 树变体,“f” 代表 “faster”。它用 Rust 从零实现,约 1.3 万行。
它想回答的问题是:B 树和 LSM 树各有短板,能不能有一种结构在点查、写入、范围扫描三方面都不输?
本文发表于 PVLDB Vol. 17, No. 11(VLDB 2024)。论文原文:p3442-hao.pdf
和 Bw-Tree 一样出自微软研究院,但思路几乎相反:Bw-Tree 用 delta chain 攒写入,读的时候要沿链表追指针;Bf-Tree 把攒写入的地方换成一个按 key 有序、长度可变的 mini-page,读写都只需一次二分查找。论文的实验里专门实现了一个"类 Bw-Tree"的 Bδ-Tree 作为对照。
#摘要
B 树是大于内存(larger-than-memory)数据系统中使用最广的范围索引。它把数据组织成页(通常 4KB),与磁盘 I/O 对齐,每次 I/O 都被充分用于缩小查找范围。但另一方面,基于页的组织也带来了低效的缓存和高写放大:即使页里只有一小部分记录是热的,也必须把整页缓存下来;更新一条记录也要写回整个页。
本文的关键洞见是把缓存页与磁盘页分开:缓存页不再是磁盘内容的纯粹镜像,而是磁盘页中值得缓存的那个子集,并能以一致的方式吸收读和写。基于这一洞见,本文提出 Bf-Tree:它构建了一个新的变长缓冲池来管理这类缓存页,称为 mini-page。Bf-Tree 用这个内存缓冲池实现高效的记录级缓存、缓冲最近的更新、缓存范围间隙(range gap),并在需要时缓存磁盘页的完整镜像。
用 Rust 实现的 Bf-Tree 扫描比 RocksDB(LSM 树)快 2.5 倍,写入比 B 树快 6 倍,点查比 B 树和 LSM 树都快 2 倍。
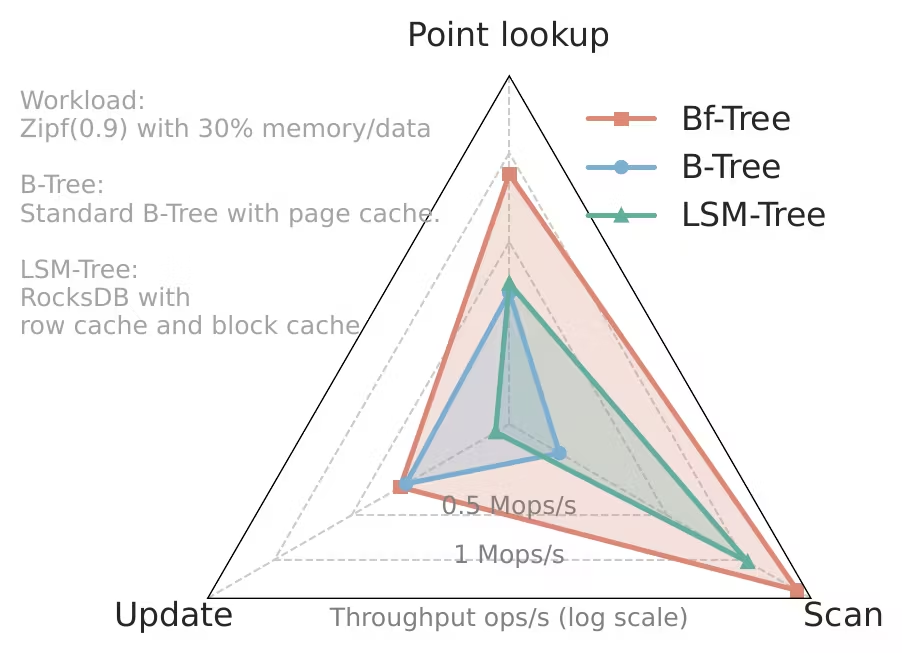
上图每个三角形代表一个系统,越大越好:Bf-Tree 在三个维度上都覆盖了 B 树和 LSM 树。负载是 Zipf(0.9),内存为数据量的 30%。
#1. 引言
B 树面临两个关键挑战:
- 写放大高:改一个页的一小部分,需要把整个页写回磁盘;
- 缓存策略低效:以页为粒度缓存,即使页上只有少数记录是热的。
当 B 树用作 key 和 value 都很小的二级索引时,这些问题更严重。
已有很多缓解办法,但都引入了新问题:
- LSM 树用日志结构写(追加)缓解写放大,但读和 compaction 代价更高;
- Bw-Tree、Bε-Tree 用 delta record 把更新串起来、批量写出,降低写放大,但拖慢了读和扫描:页的 delta chain 越长,随机内存访问越多;
- TwoTree、Anti-Caching、Siberia、TreeLine 用独立的记录缓存提升缓存效率,点查有效,但对范围扫描无用,反而挤占了扫描可用的内存;它们也难以与页缓存保持一致,内存配比难以调优。
有意思的是,两个问题的根源都是 B 树的核心设计原则——基于页的数据组织:一个页上的记录被绑在一起,整体在内存和磁盘之间传输。根本矛盾在于磁盘页远大于记录,这种粗粒度的管理限制了性能。做个思想实验:如果磁盘页和记录一样大,两个问题都会消失。
于是本文提出把缓存页与磁盘页分开。称为 mini-page 的缓存页是树的内存部分的原生组成,可以一致地读写。mini-page 有三个用途:
- 缓存频繁访问的记录;
- 缓冲最近的更新;
- 缓存一个范围间隙(两个 key 之间的区间)。
这依赖于 mini-page 能动态改变大小:它可以变大以容纳更多更新、缓存更多记录,甚至长到整页(4KB)以支持高效的跨节点扫描;也可以缩小,让别的 mini-page 长大。
变长 mini-page 是解决上述问题的理想手段,但它的内存管理面临对齐、碎片和资源利用的挑战。变长缓冲池必须满足四个要求:
- 把 mini-page 的总内存限制在配置值以内;
- 管理并追踪已用/未用的内存,即分配和释放 mini-page;
- 识别冷热 mini-page:让热的变大,让冷的缩小或被驱逐;
- 与磁盘上的叶页交互,保证一致性和数据完整性。
并且以上都要在多线程并发下高效完成。为此作者设计了一个基于环形缓冲区的变长缓冲池:总大小固定,所有 mini-page 都在其中;分配就是推进尾指针,释放就是把内存区域加入空闲链表供以后复用;mini-page 的伸缩通过分配新 mini-page 并拷贝内容(read-copy-update)完成;缓冲区满时,靠近头指针的 mini-page 被驱逐到磁盘。
贡献:
- 提出 Bf-Tree,一种新的并发大于内存范围索引,在所有测量维度上超过 B 树和 LSM 树,数据装得进内存时与内存 B 树相当;
- 设计了 mini-page 抽象,以及首个实用的、面向 mini-page 的变长缓冲池;
- 用现代 Rust 从零实现了功能完整、有较强正确性保证的 Bf-Tree;
- 用全面的负载实验分析其性能。
#2. 背景
B 树和 LSM 树传统上分别针对读密集和写密集负载优化,但实际场景必须同时处理两者,所以二者都在向对方的长处扩展。
#2.1 B 树
大于内存的 B 树把热页留在内存、冷页放在磁盘,每个页有唯一 ID,并维护页 ID 到物理位置(磁盘或内存)的映射。
- 点查:从根走到叶,再在叶内二分查找。内部节点都缓存在内存里时,一次点查只需一次 I/O 读叶节点。但当热记录和冷记录混在一个页上时,页缓存会把冷记录也带进来,缓存效率低。Two-Tree、Siberia、Anti-caching、Tree-line 等引入了记录级缓存,对点查有效,但无法单独工作:它对范围扫描无益,扫描仍需页级缓存;作为独立组件,对写也没帮助;两种缓存并存还需要精细地分配内存。
- 写:记录通常不到 100 字节,而页有 4KB 到 64KB,改一条记录往往要读整页、改、再写整页。为降低写放大,Bw-Tree 的 delta chain 是一个重要进展:对叶页的写被"盲目"追加到内存中的 delta chain,不碰叶页本身,链变长后再批量合并进叶页。但长 delta chain 会拖慢读和写,因为要沿链追指针找目标记录。
- 范围扫描:叶节点相互链接,支持高效的前后向扫描;以页为单位缓存保留了相邻记录的空间局部性,非常适合扫描。
#2.2 LSM 树
LSM 树(RocksDB、TiDB、Bigtable 等)补足了 B 树在写密集场景的短板,代价是读更贵。
- 写:写入先追加到内存 buffer,定期刷到磁盘;写盘时与已有数据排序合并,即 compaction。尽管有多层文件组织等优化,compaction 仍然非常耗资源,常带来 I/O 放大和高尾延迟。
- 点查:要在多层可能很大的文件里二分查找。加速手段包括文件级的 Bloom filter、缓存 SST 数据块的 block cache,以及缓存单条记录的 row cache(比 block cache 细,但对扫描无效)。
- 范围扫描:要搜索所有层再合并结果,效率低;row cache 对扫描也无效。
#2.3 现代 NVMe SSD
- 随机写与顺序写:HDD 上顺序写远快于随机写,日志结构写很合适。而 NVMe SSD 没有机械部件,用闪存实现并行访问,并有高效的硬件垃圾回收,随机写几乎和顺序写一样快——近期研究表明 4KB 随机写几乎可以跑满 SSD 带宽,日志结构写的吸引力因此下降。
- 绕过内核的 I/O:NVMe SSD 的 I/O 延迟只有几微秒,与一次上下文切换相当,带宽超过 10GB/s,可以占到内存带宽的相当一部分。SPDK 和 io_uring 可以绕过内核直接访问设备,省去多余的拷贝和上下文切换。
- 页大小:为了减少放大,较小的页更好。Bf-Tree 默认用 4KB 页,而不是常见的 8~32KB。近期评估表明现代 SSD 偏好 4KB,更小的页因 FTL 开销和 512B 访问未经优化,IOPS 和延迟反而更差;作者在 PCIe 4.0 NVMe SSD 上的初步实验也表明 4KB 是最佳点。
#3. Bf-Tree 架构
传统 B 树的两大问题——写放大和低效缓存——都源于磁盘页远大于单条记录。这一粒度失配迫使 B 树要么缓存冷记录,要么为一条记录写整页。
页组织适合块设备,也自然地导致了以页为单位的缓存。但缓存不必以页为单位,因为内存是字节寻址的。Bf-Tree 从一个思想实验出发:如果缓存页可以是变长的呢?那么内存缓存就不必与磁盘页对齐,可以只缓存值得缓存的部分:(1) 页中"读热"的部分,高效服务读;(2) 页中"写热"的部分,尽量(往往是原地)吸收更新,再批量写盘。必要时也可以长到缓存整个范围间隙。
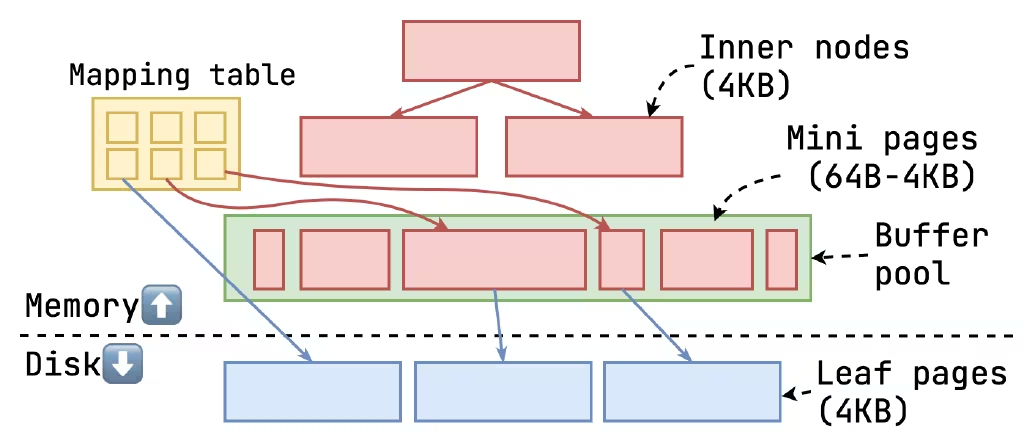
Bf-Tree 由四部分组成:(1) 内部节点;(2) 缓存 mini-page 的缓冲池;(3) 磁盘上的叶页;(4) 叶页和 mini-page 的映射表。整体和传统 B 树没太大区别,只是缓冲池支持变长页。
#3.1 Mini-page
mini-page 是对应叶页在内存中的"瘦身版",有两个作用:缓冲最近的更新,缓存频繁访问的记录。mini-page 只用于叶页(不用于内部节点),每个叶页至多有一个 mini-page。
mini-page 中的记录保持有序,保留了空间局部性,可以二分查找——这与需要一连串指针追逐的 delta chain 不同。
吸收写操作。 写操作尝试插入目标叶页的 mini-page。如果叶页还没有 mini-page,就创建一个最小尺寸的(比如 64 字节,与 cache line 对齐)、刚好能装下新记录的 mini-page。mini-page 满了就长大,每次大小翻倍,直到能装下新记录。mini-page 最终可能长得太大(最多 4KB),影响插入和查找性能,这时或者在它需要被驱逐时,就把它批量写回并合并到磁盘上的叶页。
缓存热记录。 读操作在去磁盘读叶页之前,先在 mini-page 中二分查找,找到就提前结束。找不到再从磁盘加载叶页。从磁盘读到记录后,可以把它插入 mini-page 缓存起来,此后的读就能提前结束。注意 mini-page 缓存的是单条记录而非整页,避免了传统 B 树页级缓存的低效。为了不让冷记录淹没 mini-page,只以很小的概率(比如 1%)缓存从叶页读到的记录。缓存热记录就是一次内存中的插入,必要时会让 mini-page 长大。
缓存范围间隙。 记录缓存对范围扫描没用:扫描必须查看叶页才能拿到完整记录集合,记录缓存破坏了扫描所需的空间局部性;而页级缓存保留了空间局部性,非常适合扫描。mini-page 支持缓存范围间隙:当它长到整页大小时,与叶页合并(如有必要),变成一个镜像磁盘的完整叶页。RocksDB 之类的系统需要为 row cache 和 block cache 静态划分内存,而 Bf-Tree 的 mini-page 能自动适应负载变化(偏点查还是偏扫描),同一份内存预算同时服务两类查询。
#3.2 Mini-page 与叶页的布局
mini-page 和叶页的布局相同,都按序存放 key-value 对,共享同一份实现,只是 mini-page 可以变长。这大大降低了系统复杂度,优化只需实现一次。
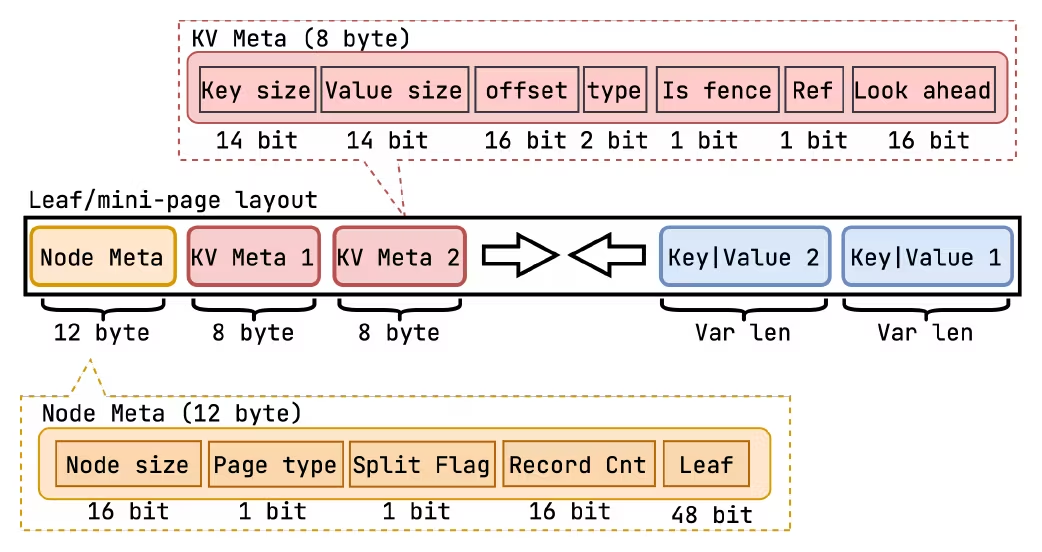
- 页开头是 12 字节的 Node Meta:节点大小(16 bit)、页类型(mini-page 还是叶页,1 bit)、分裂标志(页是否已满,1 bit)、记录数(16 bit),以及叶页地址(48 bit)。
- 之后是 KV Meta 数组,每个 8 字节:key 长度(14 bit)、value 长度(14 bit)、偏移(16 bit)、记录类型(2 bit,见表 1)、是否 fence key(1 bit)、引用位(1 bit),以及 key 的前 2 字节 look-ahead(16 bit)。
- 元数据从页头往后长,key-value 数据从页尾往前长,两者在中间相遇时页满。元数据和数据分开存放,既支持变长 key/value,也让插入时只需移动元数据,而不必移动整个节点。
#3.3 叶页与映射表
叶页总在磁盘上,在内存中至多有一个对应的 mini-page。最后一层内部节点存的是页 ID,可能指向 mini-page 也可能指向叶页。映射表把页 ID 映射到实际位置;如果指向的是 mini-page,叶页地址可以从 mini-page 头部的 leaf 字段找到。
映射表可以用哈希表/间接数组、OS 页表或指针混写(pointer swizzling)实现。Bf-Tree 用间接数组,因为简单且快,但设计上与映射表的实现解耦。
除了地址翻译,映射表还为每个页存一个读写锁:16 位读写锁和 48 位页地址打包进一个 64 位字。mini-page 和它的叶页共享同一个页 ID,锁住 mini-page 也就锁住了叶页,简化了加锁机制。
#3.4 内部节点
传统 B 树对内部节点和叶节点一视同仁,用同一张映射表翻译页 ID,于是内部节点访问有翻译开销,映射表也成了争用热点。而实际 B 树的内部节点通常不到总大小的 1%,访问却频繁得多(每次访问叶页都要经过好几个内部节点)。
Bf-Tree 默认把内部节点钉在内存里,用直接指针引用,实现更简单、访问更快、映射表争用更少,缓冲池也只需缓存叶页。这不是硬性要求:内存紧张时可以关闭,或者只钉住前几层,未钉住的内部节点和叶页一样通过映射表访问。
内部节点虽然争用激烈,却很少被修改(只在分裂/合并时)。Bf-Tree 因此对内部节点使用乐观锁耦合(optimistic latch coupling):每个节点一个 8 字节的版本锁,读操作在操作前后比较版本号,一致才继续;写操作获取排他锁,修改后递增版本。读不写共享内存,就不会污染缓存行、引发缓存一致性流量,因此能扩展到高并发。
#3.5 性能优化
以下优化同时作用于内部节点、叶节点和 mini-page:
- Fence key:页的第一个 key 是 low fence,第二个是 high fence,之后才是真正的记录。fence key 界定了页的 key 范围,并确定范围查询时的左右邻居。
- 前缀压缩:URL、名字这类 key 常有很长的公共前缀。节点的前缀隐含在 fence key 中——low fence 和 high fence 的公共前缀就是节点的前缀。插入时跳过公共前缀,只存后缀,节省空间、提高扇出;读完整 key 时再拼回去。这一点受 ART 的前缀压缩启发。
- Look-ahead 字节:元数据和数据分开存放带来一个问题:比较 key 要先读元数据,再根据它读实际 key,相当于两步指针追逐。Bf-Tree 在元数据中存 key 的前 2 字节,先比较这 2 字节。因为有前缀压缩,前 2 字节通常已经不同,多数情况下不必加载完整 key 就能结束比较。
#4. Mini-page 的缓冲池
变长缓冲池面临三个挑战:
- 管理所有 mini-page 的内存,即每个 mini-page 的确切位置。这需要应对内存碎片——和大多数分配器一样,一大块连续内存被切成各种尺寸的小块后,很难再拼回大块;
- 追踪每个 mini-page 的冷热,需要时驱逐冷的;
- 多线程并发地驱逐和分配,既要保证内存安全,又要发出足够多的并行 I/O 跑满 SSD 带宽。
Bf-Tree 的方案是一个环形缓冲区:mini-page 依次追加在尾部,满了以后把靠近头部的 mini-page 驱逐到磁盘,腾出空间让尾部继续前进。这一设计受 FASTER 的 hybrid log 启发。
#4.1 环形缓冲区的内存区域
单纯的环形缓冲区会驱逐所有到达头部的 mini-page,这对热的 mini-page 不合适。
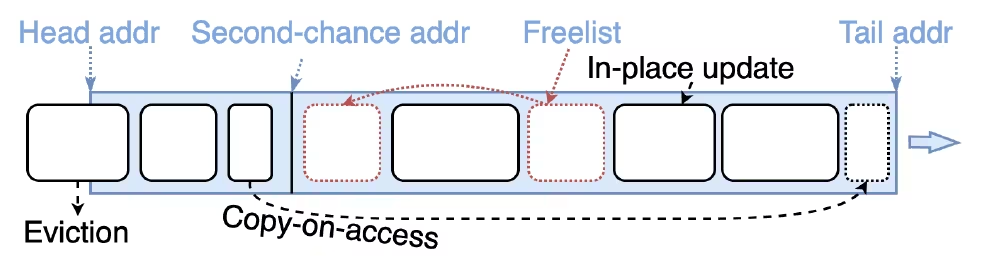
环形缓冲区有三个地址:head、tail 和 second-chance,它们把内存分成:
- 原地更新区(tail 到 second-chance 之间,占 90%):其中的 mini-page 可以原地修改;
- 访问即拷贝区(其余部分,占 10%):其中的 mini-page 一旦被访问,就被拷贝到 tail(见 5.5 节)。
这样热的 mini-page 就不会到达 head 而被驱逐。
环形缓冲区还维护多条空闲链表,每条对应一个尺寸类别,追踪最近释放的内存。mini-page 伸缩时会发生释放:先分配一个新 mini-page,拷贝旧内容,再释放旧的,释放的内存挂到空闲链表上供以后复用。
#4.2 环形缓冲区 API
- Alloc:先从对应尺寸类别的空闲链表取;没有就推进 tail 分配。缓冲区满(tail 与 head 的物理位置接近)时返回错误,调用者转去做驱逐。
- Eviction:从最靠近 head 的 mini-page 开始。调用回调函数把 mini-page 中的脏记录合并到磁盘上的叶页,然后把映射表更新为指向叶页,推进 head。可能有多个线程同时驱逐。
- Dealloc:把内存区域加入对应的空闲链表。
这其实是一个专用的内存分配器:bump 分配(推进 tail)+ 分尺寸类别的空闲链表,和 通用 malloc 的"top chunk 切块 + bins"如出一辙。不同之处在于它有一个通用 malloc 做不到的退路:碎片多了、空间不够了,可以把 head 附近的东西驱逐到磁盘,整段内存就又变成连续的了。这和日志结构存储、FASTER hybrid log 的思路一致。
#4.3 性能优化
- 内存碎片:环形缓冲区里没有"页"的概念,mini-page 一个挨一个紧密分配。每个 mini-page 前面有 8 字节元数据,记录大小和状态(如就绪、已进空闲链表)。不需要对齐到特定边界,碎片最少。
- 内存对齐:没有分页意味着 mini-page 只按 8 字节对齐,可能跨越 4KB 物理页边界,访问时多一次页表查找。解决办法是用 Linux 的大页(2MB 或 1GB)支撑整个环形缓冲区,大幅降低跨页概率。
- 并发驱逐:驱逐要推进 head,而 head 只能线性增长,本质上是串行的。为了并行化,允许各线程并发地开始驱逐各自的 mini-page,但要求它们按顺序完成:只有前面的线程都完成了驱逐,head 才能推进。
#5. 核心操作
#5.1 Get
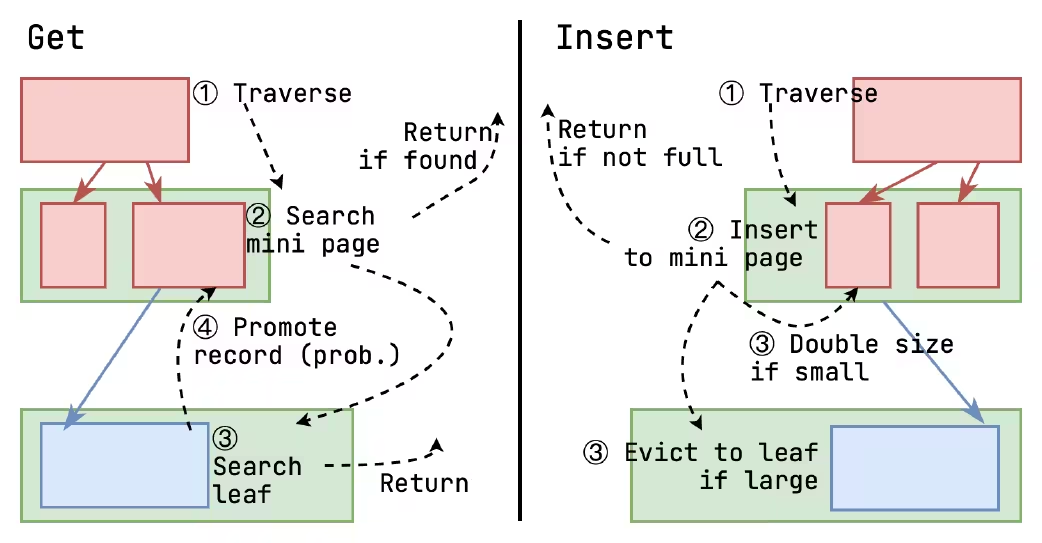
先遍历树到可能包含目标记录的 mini-page,在 mini-page 中查找。找到(已缓存)就直接返回;找不到(或者没有 mini-page),就用 mini-page 头部(或映射表)中的偏移加载磁盘上的叶页,在叶页中查找。然后以一个小概率把记录插入 mini-page 缓存起来,没有 mini-page 就新建一个。
1 | def get(key): |
#5.2 Insert
1 | def insert(key, value): |
遍历到 mini-page,不存在就新建一个刚好装下新记录的,使写放大最小。然后尝试插入:
- 成功(mini-page 有空间吸收这条记录)就结束,不需要任何 I/O;
- mini-page 满了,就尝试扩容:分配一块新内存,把 mini-page 拷过去,再插入;
- mini-page 已经很大(如 4KB),说明已经吸收了足够多的记录,就把它合并到叶页,合并时驱逐所有脏记录和冷记录。
#5.3 范围扫描
范围扫描要扫描 mini-page 和叶页中的区间,再合并结果。这意味着 mini-page 本身无法减少扫描的 I/O,因为叶页总是要读的。
为此 Bf-Tree 允许频繁被扫描的 mini-page 长到整页大小,把整个页缓存在环形缓冲区中,缓冲池此时就表现为页级缓存。页级缓存与记录级缓存的本质区别在于它同时缓存了单条记录和整个范围间隙。缓存整个叶页也让间隙锁(gap locking)、负查找等的处理变得简单。
#5.4 删除与更新
删除就是往 mini-page 插入一条墓碑记录。读到墓碑就直接返回"不存在",不用碰叶页;mini-page 合并进叶页时,墓碑把叶页上的对应记录删掉(如果存在)。
更新和删除类似:把新记录插入 mini-page,后续读直接从 mini-page 读到;合并时再更新叶页。
#5.5 Mini-page 操作
合并。 两种情况下 mini-page 会被合并:
- 太大:mini-page 会长大以缓存/缓冲尽可能多的记录,但不能无限长大,因为记录有序,太大的 mini-page 插入开销高。超过 2KB 时,它与磁盘上的叶页合并,变成一个镜像叶页的 4KB mini-page;
- 太冷:在 second-chance 区域期间没有被访问的 mini-page 会被驱逐(合并到叶页)。
合并时,先通过 mini-page 头部的 leaf 字段找到叶页,计算叶页需要多少空间来容纳 mini-page;空间不够就先分裂叶页,再把 mini-page 的记录插入相应的叶页。全部合并后丢弃 mini-page,复用其内存。
拷贝到 tail。 mini-page 在 second-chance 区域被访问时,被拷贝到 tail,避免频繁访问的 mini-page 到达 head 被驱逐。做法就是从环形缓冲区分配新内存,把 mini-page 拷过去,旧地址标记为墓碑,不触发驱逐。拷贝的同时会剔除冷记录。也就是说:
- 一条记录如果在 mini-page 处于原地更新区期间没被访问过,就会被驱逐到磁盘;
- 整个 mini-page 如果在 second-chance 区域期间没被访问,就会被整体驱逐到磁盘。
驱逐冷记录。 冷热由 KV Meta 中的引用位区分:记录被访问时置位。驱逐开始时,引用位为 0 的记录全部驱逐,其余记录的引用位清零(类似 CLOCK)。如果冷记录是缓存记录(读缓存或 phantom),直接丢弃,不必写回;如果是脏记录(insert 或墓碑),就把整个 mini-page 合并到叶页(最大化这次磁盘写的价值),同时在 mini-page 中保留热记录。
叶页分裂。 和传统 B 树一样,叶节点满了就分裂成两个。Bf-Tree 的插入总是先进 mini-page,mini-page 超过 4KB 时触发驱逐,随后叶页分裂。分裂时,mini-page 中剩下的每条记录与分裂 key 比较,决定插入哪个叶页。
#5.6 负查找
已有的记录缓存系统大多处理不好负查找(查找一个不存在的 key):缓存只能断言某条记录存在,缓存中找不到时,既可能是没缓存,也可能是不存在,于是还得去查叶页确认。
Bf-Tree 的做法是向 mini-page 插入一条 phantom 记录来缓存负查找的结果。观察是:负查询记录和其他频繁查询的记录没什么不同,缓存起来就是了。作者也提到 Bloom filter 等技术可以加速存在性判断,但会显著增加设计复杂度,留作未来工作。
至此 mini-page 中共有四种记录:
| 记录类型 | 脏? | 存在? |
|---|---|---|
| Insert | 是 | 是 |
| Cache | 否 | 是 |
| Tombstone | 是 | 否 |
| Phantom | 否 | 否 |
"脏"表示合并时必须写回叶页,"存在"表示该记录在系统中是否存在。
#5.7 快照、日志与恢复
Bf-Tree 兼容标准的快照、日志和恢复机制,目前实现了一个简单的 ARIES 风格的物理逻辑(physiological)日志。
- 日志:写操作提交前必须向 WAL 追加一条日志,并等到日志刷盘(日志满或默认 1ms 间隔)。日志项指向磁盘上的一个页,描述一个操作(如插入、删除)。
- 检查点:与 Aurora 类似,检查点通过并行重放 WAL 在后台异步、持续地完成。也实现了在线快照:暂停写操作,把脏 mini-page 写回磁盘,映射表追加到快照文件末尾;内部节点也写回磁盘以便恢复,并生成一张特殊映射表,把内部节点的虚拟内存地址映射到磁盘偏移。
- 恢复:先根据快照文件重建内存结构——加载那张特殊映射表重建内部节点,对每个内部节点找到磁盘偏移加载进内存,递归加载其子节点;再重放 WAL,找到对应页重新执行操作。
#6. 评估
#6.1 实验设置
- 类 YCSB 基准:2 亿条初始记录,每条 32 字节(16 字节 key + 16 字节 value);Zipf 分布,偏斜系数 0.9(80% 的请求访问 33% 的记录);默认 50% 读 50% 写,2GB 内存缓存。预热后重复 5 次取最好结果。
- 实现:1.3 万行 Rust,使用 io_uring 的内核轮询模式,由专门的内核轮询线程做 direct I/O,零系统调用、绕过 OS 页缓存。
- 机器:CloudLab sm110p,32 个超线程 @ 2.4GHz,128GB 内存,1TB PCIe 4.0 NVMe SSD(60 万+ IOPS),Ubuntu 22.04、内核 5.15、ext4。日志/快照/检查点与核心设计正交,所有系统都关闭。
- 正确性:用轻量形式化方法验证——以 Rust 标准库的 BTreeMap 为参考模型做差分模糊测试;在 CloudLab 上用 libfuzzer + AddressSanitizer 持续检查内存问题(泄漏、use-after-free);用 shuttle 确定性、系统地探索线程交错,发现微妙的多线程 bug;借助 Rust 的所有权模型静态检查对 mini-page 的所有访问都是安全的。
#6.2 对比系统
- RocksDB:业界最先进的 LSM 树 KV 存储。它有 memtable、block cache、row cache 三个缓存组件,需要用户自行分配内存。实验中一半内存给写、一半给读,读的一半中 block cache 和 row cache 各占一半;开启 direct I/O,关闭 fsync 和 WAL。
- 传统 B 树:用 Rust 从零实现,享有 Bf-Tree 除 mini-page 之外的所有优化(混合锁、fence key、前缀压缩、look-ahead、io_uring)。换句话说,它就是"用页级缓存的 Bf-Tree"。
- Bδ-Tree:为研究 delta record(如 Bw-Tree)的效果,作者实现了一个带 delta record 的 B 树,同样是 Rust,同样有除 mini-page 外的所有优化,设计上尽量接近 Bw-Tree。为了限制 delta chain 的内存,所有 delta 和页缓存都放在与 Bf-Tree 类似的环形缓冲区里。
- Leanstore:一种同时针对内存和大于内存负载优化的 B 树,通过指针混写降低映射表开销;而 Bf-Tree 关注的是缓存效率和写放大。纳入它主要是为了确认 Bf-Tree 的新缓冲池设计没有牺牲内存性能。
- TwoTree:用现成组件搭建记录缓存的新索引结构,用来验证 mini-page 实现的记录缓存与之同样高效。
#6.3 总体性能
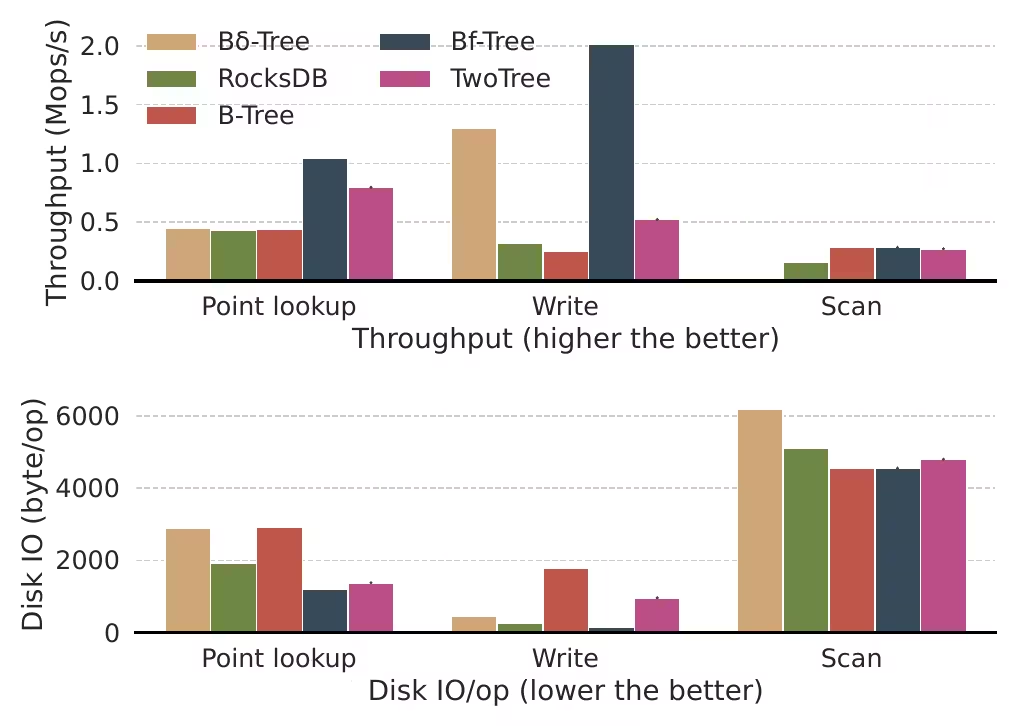
31 个线程,三种负载分别运行:
- 写:传统 B 树最差,改一条记录要写整页,每操作磁盘 I/O 最高。Bδ-Tree、RocksDB 和 Bf-Tree 都有写缓冲来批量写,每操作 I/O 更低。Bf-Tree 比 Bδ-Tree 快,因为 mini-page 可以更大,而 Bδ-Tree 最多只能挂 10 个 delta,Bf-Tree 能吸收更多写再落盘。Bδ-Tree 每操作 I/O 更高,但因为 I/O 处理更高效(零拷贝等)、内存数据结构更高效,吞吐与 RocksDB 相近。
- 点查:Bf-Tree 和 TwoTree 突出,因为它们用记录级缓存,能更有效地识别单条热记录。Bδ-Tree 和 B 树用页级缓存,吞吐和 I/O 相近。RocksDB 的 row cache 也提升了缓存效率(I/O 比 Bδ-Tree 和 B 树低),但它的内存跳表不如 B 树高效,吞吐相近。
- 扫描:基于 B 树的系统表现相近,都把整个叶页缓存在内存里,保留了记录局部性。RocksDB 最差,要扫描所有层的 SST 再合并,每操作 I/O 更高。
Bf-Tree 是唯一在三种负载上都表现良好的系统。
#6.4 可扩展性
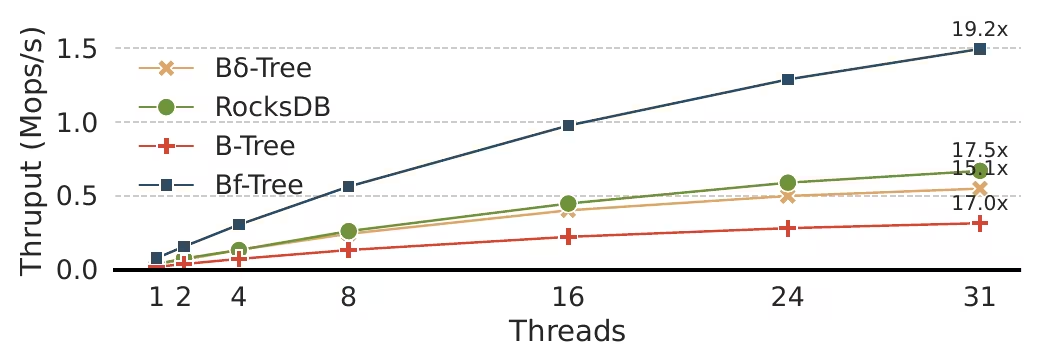
默认负载(50% 读 50% 更新)下改变线程数,所有系统在打满磁盘带宽之前都扩展良好,Bf-Tree 最好:写放大最低、缓存最高效,基于 io_uring 的 I/O 也不受内核开销限制。31 线程时 Bf-Tree、Bδ-Tree、B 树都打满了磁盘带宽,扩展倍数分别为 19.2×、15.1×、17.0×;RocksDB(17.5×)在 31 线程时还没打满带宽。Bδ-Tree 不如 RocksDB,因为它没有 RocksDB 的 row cache 那样的记录级缓存;B 树最差,因为页级缓存低效、写放大高。
数据装得进内存时,Bf-Tree、B 树、Bδ-Tree 三者退化为同一种设计。与针对内存高度优化的 Leanstore 对比:低线程数时 Leanstore 略好,因为它用指针混写避开了映射表,每次操作可能少一次缓存未命中;高线程数时 Bf-Tree 略好,扩展倍数 23.9× 对 Leanstore 的 14.5×,说明 Bf-Tree 处理争用更高效。两者的技术可以互相借鉴。大于内存时 Leanstore 与基线 B 树相近,因为它们都用页级缓存。
#6.5 延迟
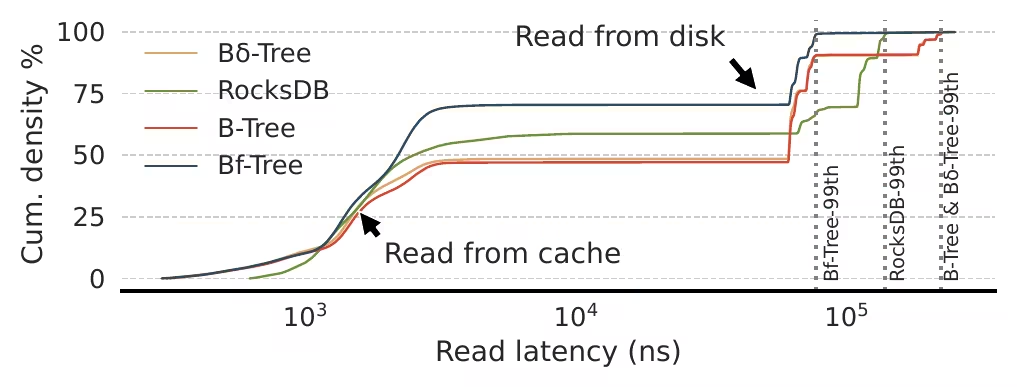
所有系统都呈现两段式分布:数据在内存时约 1µs,从磁盘读时增加 100 倍到约 100µs。
- Bf-Tree 的变长 mini-page 让它能在内存中缓存更多记录,缓存命中比例接近 75%,其他系统约 50%;
- 中位延迟:Bf-Tree 1.18µs,Bδ-Tree 1.61µs,RocksDB 1.86µs,B 树 58.7µs;
- P99 延迟:Bf-Tree 70µs,几乎只有 RocksDB(131µs)的一半,得益于零拷贝、零系统调用的 I/O。
RocksDB 的多个延迟台阶来自 LSM 的多层结构;B 树和 Bδ-Tree 末尾的台阶来自缓存替换(新页提升进缓存、旧页驱逐到磁盘),Bf-Tree 也有类似台阶,但因为缓存比例高而小得多。
#6.6 偏斜度
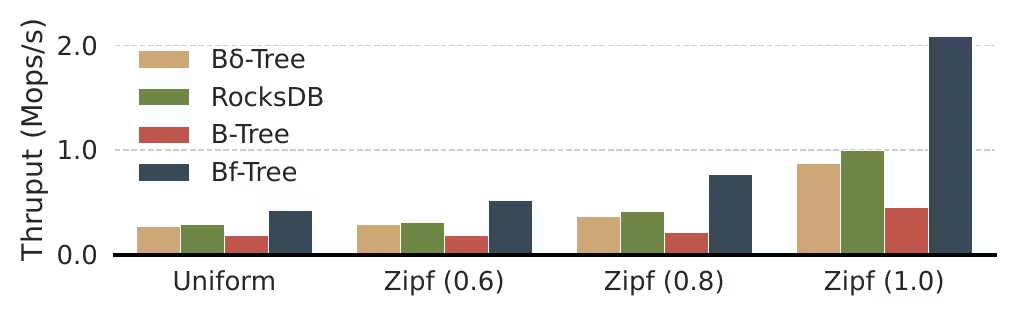
负载越偏斜,热记录越容易被缓存,所有系统性能都提高。Bf-Tree 在各偏斜度下都最好,偏斜越高优势越明显:记录级缓存比页级缓存更擅长识别热记录;RocksDB 虽然有 row cache,但内存要分给 memtable、block cache、row cache,而 Bf-Tree 可以把全部内存都用于记录缓存;Bδ-Tree 的 delta chain 和页缓存也在争同一份内存。
均匀分布时所有系统都差,因为每条记录同样热,缓存作用有限。即便如此 Bf-Tree 的缓存比例仍最高:实际 B 树叶页因为分裂的特性,只有约 70% 的空间被使用,整页缓存会浪费 30% 的内存;而 mini-page 会随页中实际记录数伸缩。
#6.7 读写比
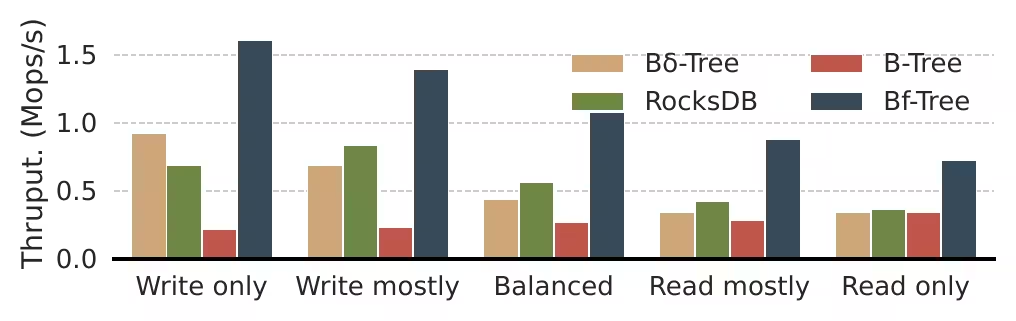
对有写缓冲的系统(Bf-Tree、Bδ-Tree、RocksDB),写越多吞吐越高:写大多被缓冲在内存里,buffer 满了才刷盘;而每次读未命中都是一次随机磁盘 I/O。传统 B 树正好相反,读越多越好,因为读只要一次读 I/O,写要读 I/O 加写 I/O。Bf-Tree 在所有读写比下都明显领先,因为 mini-page 既能缓存热记录又能吸收写。
#6.8 缓存大小敏感性
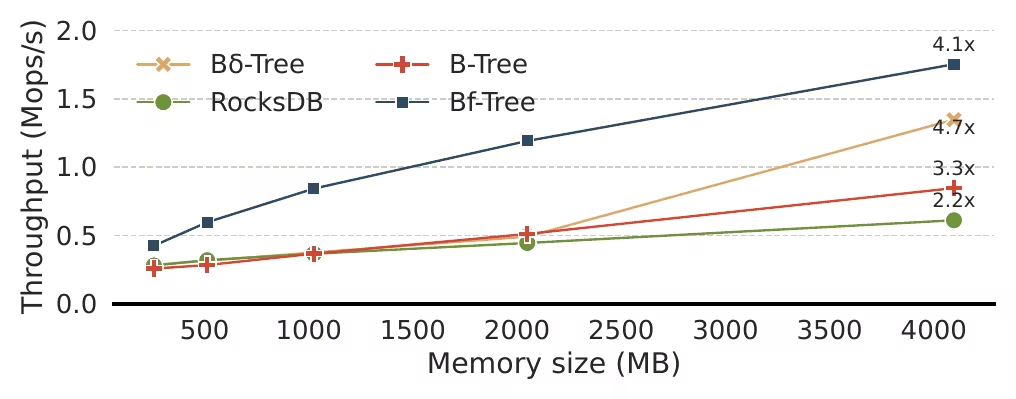
只读负载,内存从 256MB 增加到 4GB(16 倍):RocksDB 稳步提升但只到 2.2 倍,缓存效率低;Bδ-Tree 和 B 树都用页级缓存,分别提升 4.7 倍和 3.3 倍,在大部分数据在磁盘上时提升慢、大部分在内存里时提升快;Bf-Tree 提升 4.1 倍,在所有内存大小下都最好。数据大多在磁盘上时差距更大,体现出 Bf-Tree 缓存机制的效率;数据大多在内存里时差距缩小,因为 B 树类系统都退化为同一种设计。
#6.9 时间分解
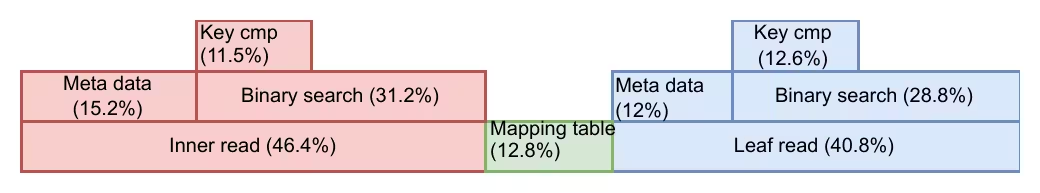
内存中只读负载的火焰图(大于内存时类似,只是 95% 以上的时间花在磁盘 I/O 上):
- 内部节点查找约占一半时间(46.4%),包括多次内部节点查找;映射表读取只占 12.8%,一次内存访问就完成地址翻译和加锁;叶节点查找占 40.8%。
- 多次内部节点查找与一次叶节点查找耗时相当:内部节点访问频繁,大多在 CPU 缓存里,而叶节点访问不那么频繁,几乎每次都要从内存加载。
- 节点内部,元数据加载与二分查找耗时相近;二分查找中约三分之一时间在比较 key 字节,其余在从内存加载数据。
#6.10 访问即拷贝区的大小
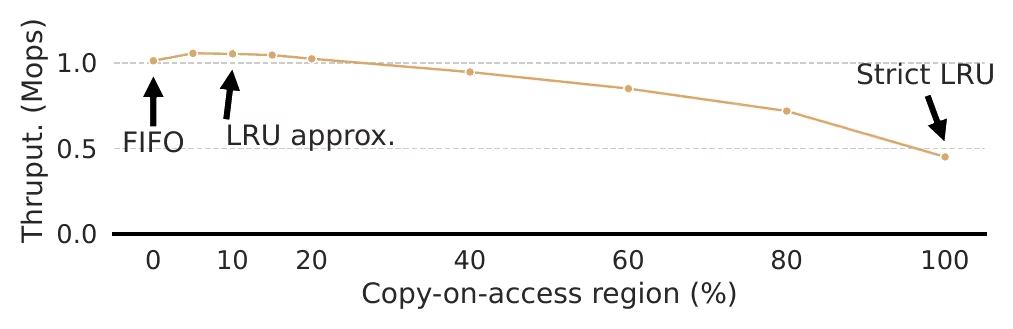
访问即拷贝区从 0% 变到 100%:0% 时缓冲区就是一个 FIFO 队列,运行开销低但缓存质量差;100% 时就是严格的 LRU,缓存质量高但运行开销大。Bf-Tree 默认取 10%,在两者间取得平衡。
#6.11 提升率
提升率指把一条冷记录从磁盘页提升到 mini-page 的概率。作者在负载切换后观察吞吐随时间的变化:提升率低(如 1%)时偏重频率,对负载变化响应慢,但可能收敛到更高的吞吐;提升率高(如 100%)时偏重近期性,收敛快,但会把冷记录也提升进来扰乱缓存,最终吞吐更低。这一节写道 Bf-Tree 默认取 20%,以平衡近期性与频率(注意 5.1 节的伪代码和正文给的默认值是 1%,论文前后不一致)。
#7. 相关工作
- 内存索引:ART 是针对点查和内存效率优化的内存范围索引,Bf-Tree 的前缀压缩受其启发;Blink-hash 是针对追加密集负载优化的内存 B 树,mini-page 受其写缓冲设计启发。
- 大于内存的 KV 存储:FASTER 是针对点查和写密集负载的大于内存哈希 KV 存储,Bf-Tree 的环形缓冲区受其 hybrid log 启发(hybrid log 支持变长记录分配),但 Bf-Tree 是支持高效扫描的范围索引。TreeLine 是带记录缓存和插入预测的 B 树实现,目前只支持定长记录。Leanstore 首个用指针混写降低映射表开销。Two-tree 用现有 B 树实现高效的记录缓存。SplinterDB 是专注于低读写放大的 Bε-tree 实现。
- 新硬件上的 B 树:PIM-tree 面向存内计算,利用 SSD 透明压缩降低写放大的 B 树,以及 Bztree 等一系列面向持久内存的范围索引。
- LSM 树:WALTZ 利用 ZNS SSD 降低尾延迟,Chucky 用新的过滤器替代 Bloom filter,WiscKey 用键值分离降低写放大。
#8. 结论
Bf-Tree 是一种针对点查、写入和范围扫描优化的 B 树变体。它用 mini-page 实现变长缓存页,以缓存热记录、缓冲写入、缓存范围间隙;为管理 mini-page,设计了基于环形缓冲区的新型变长缓冲池。Bf-Tree 在扫描上比 RocksDB 快 2.5 倍,写入比 B 树快 6 倍,点查比两者都快 2 倍。
#读后感
- "缓存页不必是磁盘页的镜像"这个出发点非常简洁,而且一下子统一了三件过去要分开做的事:记录缓存(TwoTree 等)、写缓冲(Bw-Tree 的 delta、LSM 的 memtable)、页缓存(传统缓冲池)。同一份内存预算、同一套代码、同一个淘汰机制,不再需要 RocksDB 那样手工划分 memtable/block cache/row cache。
- 和 Bw-Tree 对照着看很有意思。两者都在内存里给叶页挂了一个"增量",区别在于这个增量的形态:Bw-Tree 是不可变的 delta 链,靠 CAS 安装,读要遍历链表;Bf-Tree 是可变的有序 mini-page,靠映射表里的读写锁保护,读只要一次二分。十年间硬件和观念都变了:Bw-Tree 为了无锁和闪存顺序写付出指针追逐的代价,Bf-Tree 则认为 NVMe 随机写够快、日志结构不再必要,乐观锁加短临界区也足够扩展。
- 变长缓冲池本质上是一个带驱逐能力的内存分配器:bump 分配 + 按尺寸分类的空闲链表 + 大页,碎片问题靠"把头部驱逐到磁盘"兜底。这和 CacheLib 用淘汰代替 free 的 slab 分配器、FASTER 的 hybrid log 是同一个家族。second-chance 区域则是用"位置"代替 LRU 链表来近似 LRU,省去了每次访问都要改链表的开销。
- 实验部分的 B 树和 Bδ-Tree 基线都是作者自己用同一套代码实现、只差 mini-page 的版本,控制变量做得很干净;但这也意味着它们不等于工业级的 B 树或 Bw-Tree 实现,读结论时要注意。另外负载里每条记录只有 32 字节,正是页级缓存最吃亏、记录级缓存最占便宜的场景。
#参考资料
- Xiangpeng Hao, Badrish Chandramouli. Bf-Tree: A Modern Read-Write-Optimized Concurrent Larger-Than-Memory Range Index. PVLDB 17(11), 2024.
- Justin J. Levandoski, David B. Lomet, Sudipta Sengupta. The Bw-Tree: A B-tree for New Hardware Platforms. ICDE 2013.
- Badrish Chandramouli et al. FASTER: A Concurrent Key-Value Store with In-Place Updates. SIGMOD 2018.
- Viktor Leis, Michael Haubenschild, Alfons Kemper, Thomas Neumann. LeanStore: In-Memory Data Management Beyond Main Memory. ICDE 2018.
- Viktor Leis, Alfons Kemper, Thomas Neumann. The Adaptive Radix Tree: ARTful Indexing for Main-Memory Databases. ICDE 2013.