[ICDE'13] The Bw-Tree: A B-tree for New Hardware Platforms 论文阅读
Bw-Tree 是微软研究院 Justin Levandoski、David Lomet、Sudipta Sengupta 在 2013 年提出的 B+ 树变体,"Bw"取自 “buzz word”。它的目标是同时适应两种新硬件:多核 CPU(要求高并发且不能频繁让缓存行失效)和闪存(随机写慢于顺序写)。
Bw-Tree 后来成为 SQL Server Hekaton 内存引擎的范围索引,以及 Azure Cosmos DB 存储引擎的基础,也是"无锁 B 树"这一方向最常被引用的工作。
本文发表于 ICDE 2013。论文原文:bw-tree-icde2013-final.pdf
一句话概括:加一层间接,把一切修改都变成"新建一个对象 + 一次 CAS"。页之间不再用物理指针相连,而用逻辑页号(PID);PID 到物理地址的翻译放在一张映射表里。于是改一个页只需要把新状态挂上去、再 CAS 一下映射表的槽位,页的物理位置在内存里、在闪存上都可以随意搬动。
读完 Bw-Tree,可以接着看十年后同一个研究组的 Bf-Tree,它在实验中专门拿"类 Bw-Tree 的 delta chain"做了对比,并给出了不同的答案。
#摘要
新硬件和新平台的出现促使人们重新思考数据管理系统的设计,但按 key 访问记录这类基本功能依然必不可少。本文沿用了已有系统的经典分层架构,但在每一层都做了全新的设计决策。新的 B 树形式 Bw-tree 通过无锁(latch-free)的方法有效利用现代多核处理器的缓存,从而获得很高的性能;存储管理器采用一种独特的日志结构,模糊了页存储和记录存储的界限,并且很适合闪存。本文介绍 Bw-tree 的架构和算法,重点是内存部分,并给出实验结果。
数据库里 lock 和 latch 是两回事:lock 保护的是事务看到的逻辑数据(记录、范围),持有到事务结束,由锁管理器管理,有死锁检测;latch 保护的是内存里的物理数据结构(比如一个 B 树页),只在一次操作的临界区内持有,本质上就是 mutex / rwlock。本文说的 latch-free 指 B 树内部不用 mutex,事务层面的并发控制交给别的组件。
#1. 引言
#1.1 原子记录存储
NoSQL 系统本质上是原子记录存储(Atomic Record Store, ARS):支持按 key 读写单条记录,基于树的 ARS 还支持按 key 顺序高效访问一个子区间。这种随机 + 顺序访问的组合正是 B 树成为数据库首选索引的原因。ARS 也可以作为完整事务系统的一个组件,数据库内核里本身就包含一个 ARS。
ARS 不只是访问方法,还包括稳定存储的管理以及崩溃后可恢复的要求。本文提出的 ARS 以 Bw-tree 为核心,重点讨论内存部分:如何无锁地完成更新和结构修改。
#1.2 新的硬件环境
为多核设计。 单核性能不再随摩尔定律增长,必须利用好大量核心,这有两方面:
- 多核要求高并发。但并发越高,latch 越容易阻塞,限制扩展性。
- 多核性能依赖高的 CPU 缓存命中率。原地更新内存会让其他核的缓存行失效,所以更新的方式和时机需要仔细设计。
对第一点,Bw-tree 是无锁的,线程遇到冲突时不会让出 CPU,也不会转去做别的事;对第二点,Bw-tree 用 delta 更新代替原地更新,保留已经缓存的页面内容。
为新的存储设备设计。 磁盘的延迟是大问题,更要命的是每秒 I/O 次数太低。闪存以更低的成本提供更高的 IOPS,对降低 OLTP 成本很关键。但闪存写之前需要擦除,随机写比顺序写慢;SSD 的 FTL 虽然隐藏了这一点,性能差距依然明显——2011 年,即使高端的 FusionIO 盘顺序写也比随机写快 3 倍。Bw-tree 在自己的存储层做日志结构,不依赖 FTL,使无论高端还是低端闪存的写入都不成为瓶颈。
#1.3 贡献
- Bw-tree 围绕一张映射表组织,它把页的位置和大小都虚拟化了。这是无锁内存操作和日志结构存储的基础。
- 更新 Bw-tree 节点的方式是把更新 delta 前插(prepend)到页的旧状态之前。delta 更新保留了旧状态,提升 CPU 缓存性能;新状态位于新的内存位置,所以可以用原子 CAS 指令安装。因此 Bw-tree 在经典意义上是无锁的:多个线程可以并发访问同一个页。
- 设计了页分裂和合并这两种结构修改操作(SMO)。每个 SMO 由多个原子操作组成,每一步之后树都是良构的;看到进行中 SMO 的线程不会阻塞,而是帮忙把它完成。
- **日志结构存储(LSS)**名义上是页存储,但大部分时候只写页的变更 delta(一条或几条记录),存储利用率很高。页通过合并 delta 以及闪存"清理"(cleaning)过程最终变得连续。
- 实现了基于 Bw-tree 和 LSS 的 ARS,在真实和合成负载上都远超 BerkeleyDB(为磁盘设计的传统系统)和内存中的无锁跳表。
作者认为更广泛的经验是:无锁技术和避免原地更新的状态变更是现代处理器上高性能的关键;日志结构是提供高存储性能的途径,不只对闪存,对磁盘也一样。
#2. Bw-tree 架构
Bw-tree ARS 在很多方面是经典的 B+ 树:对一维 key 空间提供对数时间的访问,对子区间提供线性时间的访问。架构也是经典的三层:
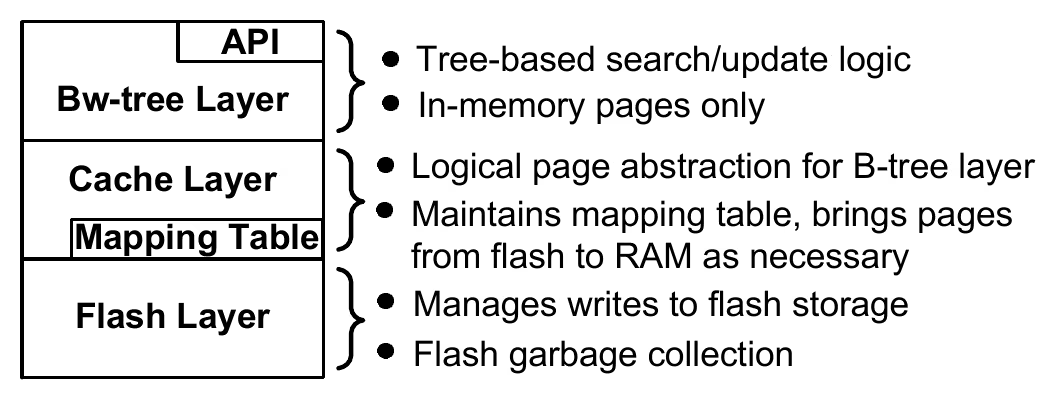
- Bw-tree 层:访问方法,提供 API,负责基于树的查找和更新逻辑,只操作内存中的页;
- Cache 层:为 Bw-tree 层提供逻辑页抽象,维护映射表,按需把页从闪存读进内存;
- Flash 层:即 LSS,管理闪存写入和闪存垃圾回收。
这一设计与已有数据库内核在架构上兼容,也适合在"解耦的事务系统"(如作者的 Deuteronomy)中作为独立的数据组件。但每一层都与经典设计有显著不同。
#2.1 对现代硬件敏感
Bw-tree 中线程几乎从不阻塞,主要手段就是消除 latch,用 CAS 安装状态变更。唯一会阻塞的情况是需要从稳定存储读页,而内存缓存很大时这很少发生。线程持续执行有助于保留指令缓存,避免空闲和上下文切换的开销。用 delta 更新代替原地更新,减少了 CPU 缓存失效,提高命中率,进而提高每周期执行的指令数。
存储方面,日志结构让系统可以写大块 buffer,基本消除写瓶颈;闪存的高随机读性能加上大内存缓存,使读很少阻塞。写多页的大 buffer 还允许写变长页,不需要为对齐到统一大小而填充。
#2.2 映射表
Cache 层维护一张映射表,把逻辑页映射到物理页。逻辑页用**页标识符(PID)**标识,映射表把 PID 翻译成:
- 闪存偏移:页在稳定存储上的地址;或
- 内存指针:页在内存中的地址。
这种间接本身不是新东西,但 Bw-tree 把它作为好几项创新的基础:树节点之间的所有链接都是 PID,而不是物理指针,包括所有向下的查找指针。
映射表切断了物理位置和节点间链接的联系。于是节点每次更新、每次写回稳定存储时都可以换物理位置,而不需要把位置变化一路传播到根(即不必修改节点间的链接)。这种"可搬迁性"直接支撑了内存中的 delta 更新和存储上的日志结构。
节点因此是逻辑的,不占据固定的物理位置。"页"只是一个策略而非约束,无论是节点的表示方式还是大小都可以灵活决定。作者允许页是弹性的:没有尺寸上限强制分裂,在方便时再分裂即可。
#2.3 Delta 更新
页状态的修改方式是:创建一个描述变更的 delta record,把它前插到现有页状态之前,然后用 CAS 把 delta 的地址装进映射表中该页的槽位。成功后,delta 的地址就成了页的新物理地址。数据变更(如插入记录)和管理变更(如页分裂、刷盘)都用这一策略。
偶尔会对页做合并(consolidation):新建一个应用了所有 delta 的页,以减少内存占用、加快查找。合并后的页同样用 CAS 安装,旧的页结构(包括 delta)放进待回收列表,在安全时用 epoch 机制回收。
delta 更新同时带来了无锁访问和对 CPU 数据缓存的保护,而映射表是这一切的关键:它把节点更新的影响隔离在节点自身。
#2.4 结构修改
结构修改(SMO,如页分裂)期间也没有 latch 保护树的某一部分,这就带来了问题:分裂会同时修改多个页——过大的原页 O、接收一半内容的新页 N,以及原来指向 O、之后要同时指向 O 和 N 的父页 P。一次 CAS 装不下一个页分裂,合并就更难了。
解决办法是把 SMO 拆成一串原子动作,每个都能用一次 CAS 安装。作者借助 B-link 设计:每个页有一个指向右兄弟的侧链,于是分裂可以拆成两个"半分裂"原子动作。为了保证没有线程需要等待 SMO 完成,看到部分完成的 SMO 的线程会先把它做完,再继续自己的操作。
#2.5 日志结构存储
LSS 具有日志结构的通常优点:页按大批量顺序写入,大大减少写 I/O 次数。但日志结构通常因为垃圾回收而产生额外写入——回收日志旧区域时要搬迁仍然存活的页。LSS 大大缓解了这个问题:
- 刷一个页时,只需刷自上次刷盘以来的 delta,大幅减少写入量,让一个刷盘 buffer 能装下更多页,减少每页的 I/O 次数;
- 代价是读:页的不连续片段都要读回来才能重建页,这时闪存极高的随机读性能就发挥了作用;
- 增量刷盘减少了每页占用的存储,从而减轻清理器的压力,降低日志结构特有的"写放大";清理时 LSS 会把页及其 delta 变成连续的,改善后续访问。
#2.6 事务日志的配合
和传统数据库一样,ARS 要保证更新在崩溃后依然存在。每个更新操作都带有唯一标识,通常是该更新在事务日志(由别处维护,如事务组件)中的 LSN,用来保证恢复的幂等性(操作至多执行一次)。
页按需延迟刷盘,并遵守 WAL 协议。不寻常的是,Bw-tree 不会为了遵守 WAL 而阻塞刷盘:因为最近的更新是和页其余部分分开的 delta,刷盘时可以把"太新"(尚未进入稳定事务日志)的更新直接排除掉。
#3. 内存中的无锁页
#3.1 弹性虚拟页
Bw-tree 页上存的信息和普通 B+ 树类似:内部节点存按 key 排序的(分隔 key,指针)对,叶节点存(key,记录)对。此外每个页还有:
- low key:页(及其子树)能存的最小 key;
- high key:页能存的最大 key;
- 侧链指针:指向同层的右兄弟,和 B-link 树一样。
两个特点让 Bw-tree 的页设计与众不同:
- 页是逻辑的,不占据固定物理位置,也没有固定大小。页由映射表中的 PID 标识,访问者通过映射表把 PID 翻译成当前物理地址;节点之间的所有链接(查找指针、侧链)都是 PID。
- 页是弹性的,大小没有硬上限,靠前插 delta record 来"长大"。一个 delta 表示一次记录修改(如插入、更新)或一次系统管理操作(如页分裂)。
更新。 Bw-tree 从不原地修改页,而是创建描述更新的 delta record 并前插到页之前:
- 创建新 delta D,让它(物理地)指向页的当前地址 P,P 从映射表中该页的槽位读出;
- 用 CAS 把槽位从 P 替换成 D 的地址。CAS 比较当前地址是否仍为 P:是则安装成功,否则失败。
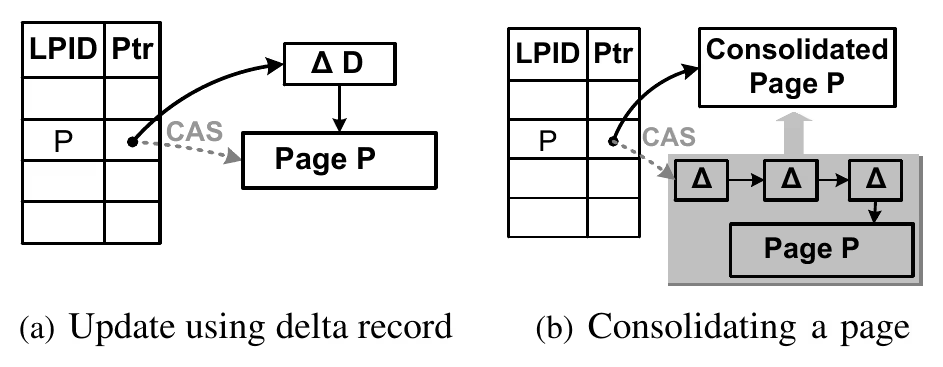
由于节点间的指针都是 PID,映射表槽位上的这一次 CAS 是安装页更新所需的唯一一次物理指针修改。这也是更新 Bw-tree 页的唯一方式,所有修改页的操作都一样,下文把"用 CAS 更新页"称为安装。如果多个线程针对同一个旧状态竞争安装 delta,只有一个能赢,其余的需要重试。
多次更新后页上会形成 delta chain,每次成功更新都成为链的新头。所以一个 Bw-tree 页的物理结构是:一条 delta chain + 链尾的 base page(即合并后的 B 树节点)。
叶节点更新。 叶节点上的 delta 有三种:insert(插入新记录)、modify(修改已有记录)、delete(删除记录)。所有更新 delta 都带有发起更新的客户端提供的 LSN,用于和事务日志管理器配合遵守 WAL。insert 和 modify delta 带有新的记录内容,delete delta 只带要删的 key。
页内查找。 叶节点查找先遍历 delta chain,在第一次遇到该 key 时停下:如果是 insert 或 modify,查找成功并返回记录;如果是 delete,查找失败。如果 delta chain 中没有该 key,就在 base page 上按普通 B 树的方式二分查找。
#3.2 页合并
delta chain 太长时查找会变慢,所以要偶尔做页合并:新建一个"重组过"的 base page,包含原 base page 的所有条目并应用 delta chain 上的所有更新。
- 触发:访问线程在查找时发现 delta chain 长度超过系统阈值,就在完成自己的读写操作之后执行合并。
- 过程:分配一块新内存作为 base page,填入一个有序数组,其中每条记录取 delta chain 或旧 base page 中最新的版本(被删除的记录丢弃);然后用 CAS 把新地址装进映射表。
- 成功:请求对旧页状态做垃圾回收;失败:直接释放新页,不重试,因为之后总会有别的线程成功合并。
#3.3 范围扫描
范围扫描由一个 key 区间(low key, high key)指定,任一端可以省略,并指定升序或降序。扫描维护一个游标,记录扫到了哪个 key。
第一次访问包含区间内数据的叶页时,构造一个包含页上所有相关记录的数组,在页没有被修改的常见情况下,就可以高效地提供"下一条记录"。
每次"取下一条记录"是一个原子单位,整个扫描并不是原子的。事务锁可以防止已经看过的记录被修改(假设可串行化事务),但对还没返回的记录,Bw-tree 不知道上层用的是哪种并发控制。所以每次从数组返回记录之前,会检查是否有更新影响了尚未返回的子区间,如果有就重建数组。
#3.4 垃圾回收
无锁环境不允许独占访问共享数据结构,一个页状态正在被替换时,可能仍有读者在访问它。例如合并时,一个线程把页的旧状态(delta chain + base page)“换出”、请求回收,就不能在别的线程还在访问时把它释放掉。页从树中移除时也有同样的问题。
这通过 epoch 机制解决:
- 线程想保护正在使用的对象(比如查找过程中)不被回收时,加入一个 epoch,依赖结束后退出。通常一个线程在 epoch 中停留的时间就是一次操作(如一次插入、一次 next-record)。
- 加入 epoch E 的线程可能看到过在 E 中被释放的对象的旧版本,但不可能看到在 E−1 中被释放的对象,因为那时它的依赖区间还没开始。
- 所以当加入 E 的所有线程都退出(epoch “排空”)后,在 E 中释放的对象就可以安全回收了。
epoch 既保护存储,也保护被释放的 PID:epoch 排空之前,这些对象和 PID 都不能被复用。
#4. 结构修改
Bw-tree 的所有 SMO 都是无锁的。作者称,据他们所知这是第一次有人做到这一点。
#4.1 节点分裂
访问线程发现页大小超过系统阈值时触发分裂,同样在完成自己的操作之后执行。Bw-tree 采用 B-link 的两阶段原子分裂安装:先在子节点层原子地安装分裂(半分裂),再原子地更新父节点,加入新的分隔 key 和指向新页的指针,必要时递归向上。B-link 结构使分裂可以拆成两个原子动作,因为侧链保证在子节点层安装分裂之后,搜索树依然有效。
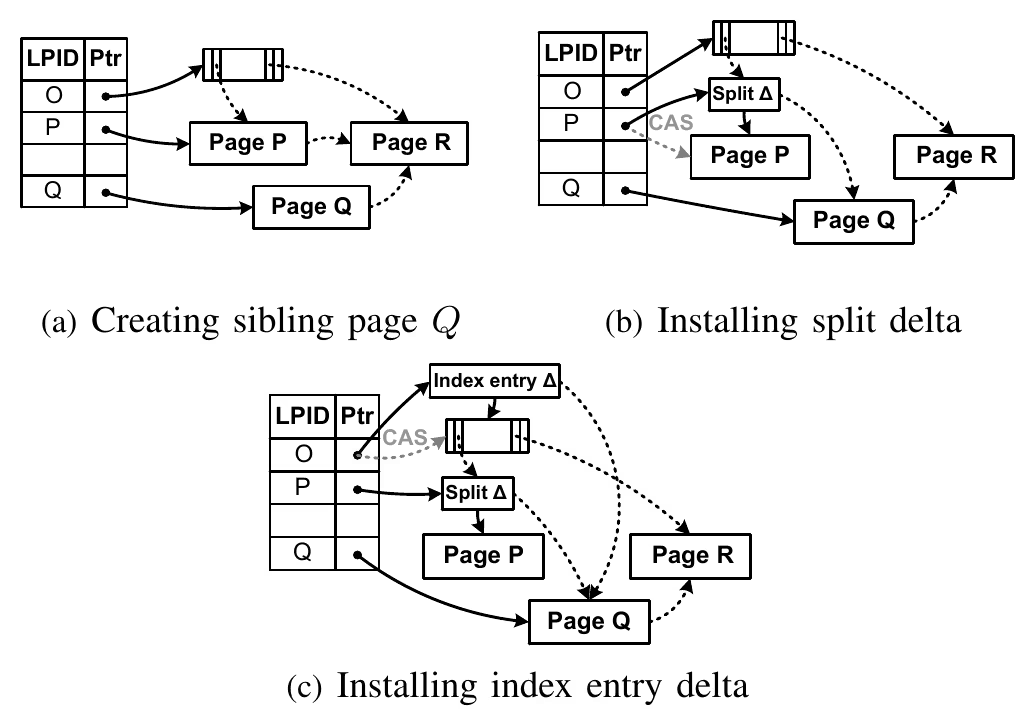
子节点分裂(图 (a)、(b)):
- Bw-tree 层向 Cache 层申请一个新的 PID Q,作为 P 的新右兄弟;
- 在 P 中找一个使分裂均衡的分隔 key,为 Q 新建一个合并好的 base page,包含 P 中所有大于 的记录;Q 的侧链指向 P 原来的右兄弟 R;
- 把 Q 的物理地址装进映射表——不需要 CAS,因为此时只有分裂线程能看到 Q;
- 在 P 上前插一个 split delta 来原子地安装分裂。它包含两样东西:分隔 key,用来使 P 中所有大于 的记录失效(它们已经在 Q 里了);以及指向 Q 的逻辑侧指针。
完成第一次半分裂后,即使父节点 O 里还没有 Q 的索引项,索引也是有效的:要找 Q 中 key 的搜索会先到 P,看到 split delta 后发现 key 大于,就沿侧链去 Q;小于 的搜索留在 P。
父节点更新(图 ©):为了让搜索直接到达 Q,在 P 和 Q 的父节点上前插一个 index entry delta,完成第二次半分裂。它包含:
- ,P 与 Q 之间的分隔 key;
- 指向 Q 的逻辑指针;
- ,Q 的分隔 key(原先指向 P 的那个分隔 key)。
线程在下降过程中记住了路径上的 PID,因此能立刻找到父节点。大多数时候记住的父节点就是对的,可以立即提交。偶尔父节点可能已经被合并进别的节点了,但 epoch 机制保证父节点的 PID 不会是悬空引用,线程会看到"已删除"的状态,此时就回到祖父节点,再重新向下找到"还活着"的父节点。
index entry delta 里同时带 和 是一个加速查找的优化:在内部节点的 delta chain 上,如果找到一个满足 的边界 delta,搜索就能立即结束,沿逻辑指针去 Q;否则继续在 base page 上二分查找。
合并。 用 delta 安装分裂比创建并安装全新的 base page 延迟更低,延迟低就减少了"分裂失败"(安装之前别的更新先抢了进来)的概率。但分裂后的页最终仍会被合并:对带 split delta 的页,新 base page 只包含小于分隔 key 的记录;对带 index entry delta 的页,新 base page 包含新的分隔 key 和指针。
#4.2 节点合并
和分裂一样,线程遇到小于某阈值的节点时触发合并。合并比分裂复杂得多,需要更多原子动作:
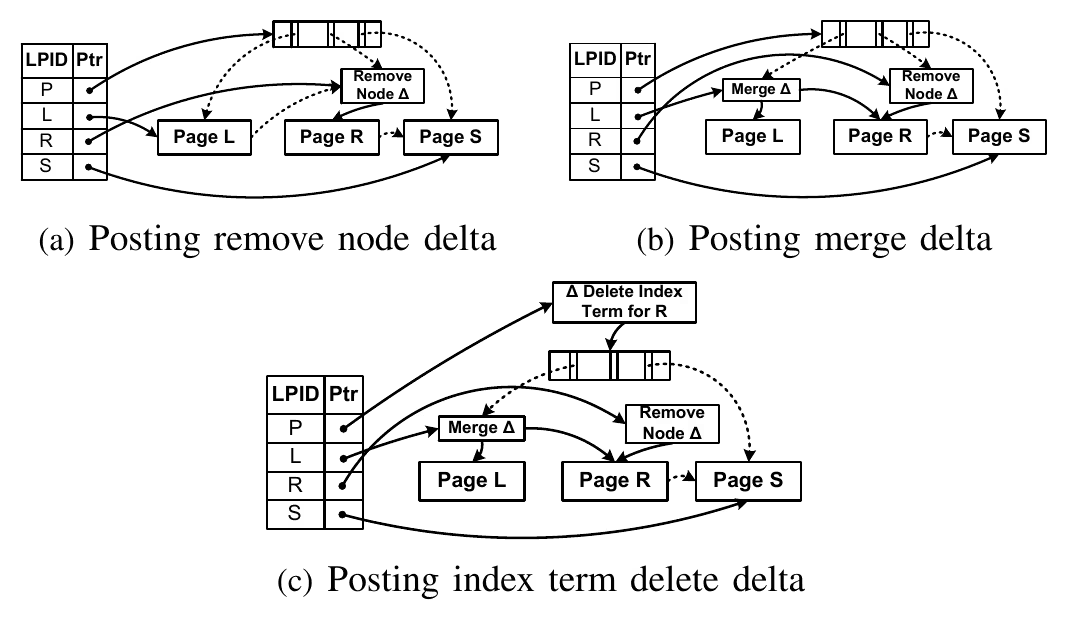
- 标记删除(图 (a)):在要被合并掉的节点 R 上安装一个 remove node delta,阻止对 R 的一切后续使用。线程遇到它时,需要转去 R 的左兄弟 L 读写原本属于 R 的内容,因为 R 的数据将被并入 L。
- 合并子节点(图 (b)):在 L 上安装一个 node merge delta,它物理地(用内存地址)指向 R 的内容,表示 R 的内容现在属于 L。R 的存储由此转交给 L(remove node delta 本身除外),要等 L 被合并时才回收。原本线性的 delta chain 由此变成了一棵树:在 L 中查找时,会根据 node merge delta 里的分隔 key 决定去 L 原来的页还是从 R 接收的页。
- 更新父节点(图 ©):在 R 的父节点 P 上安装一个 index term delete delta,删除 R 的索引项,同时说明 L 现在包含了 R 原来的 key 空间。L 的新区间被显式写出:low key 是 L 原来的 low key,high key 是 R 原来的 high key。这样搜索能识别何时需要转向变更过的部分,落到 base page 的搜索也能用简单的二分找到正确的索引项。
index term delete delta 安装之后,所有通向 R 的路径都被阻断,于是开始回收 R 的 PID:把它放进当前活跃 epoch 的待删除 PID 列表,直到所有可能看到过 R 旧状态的线程都退出 epoch,才会复用。
#4.3 串行化结构修改和数据更新
Bw-tree 假设冲突的数据更新已经被系统别处的并发控制挡住了:可能是集成数据库的锁管理器,可能是解耦事务系统(如 Deuteronomy)的事务组件,也可能 ARS 本身就允许并发更新任意交错。
但在 Bw-tree 内部,数据更新与 SMO、SMO 与 SMO 之间必须正确串行化:要能把 Bw-tree 中发生的一切排成一个串行调度,其中数据更新和 SMO 各自是原子单位。这并不容易。
作者把 SMO 看作原子的系统事务,但没有 latch 来遮住"一个 SMO 有多步"这一事实。一个线程撞上未完成的 SMO,就像看到了未提交的状态,而无锁的 Bw-tree 无法阻止这种情况。对策是:线程必须先把遇到的 SMO 完成并提交,然后才能 (1) 安装自己的更新,或 (2) 继续自己的 SMO。
- 对页分裂:更新者或别的 SMO 需要穿过侧指针才能到达正确的页时,必须先向父节点提交新的 index entry delta 来完成这次分裂,才能继续自己的事。这迫使未完成的 SMO “提交”,并串行化在被打断的动作之前。
- 对合并同理:删除节点 R 时要访问左兄弟 L 来安装 merge delta,如果发现 L 本身正在被删除,说明看到了一个更早的、进行中的系统事务。R 的删除需要排在 L 的删除之后,于是删除 R 的线程先把 L 的删除完成,再完成 R 的删除。
所有 SMO 组合都按这种方式串行化。这可能导致处理一"栈"SMO,但这种情况很少,递归实现也很直接。
#5. 缓存管理
Cache 层负责在内存和闪存之间读、刷、换出页,维护映射表,向 Bw-tree 层提供逻辑页抽象:
- Bw-tree 层用 PID 请求页时,如果映射表中是内存指针,直接返回;
- 如果是闪存偏移(页不在内存中),就从 LSS 读进内存,用 CAS 把内存地址装进映射表,再返回新指针。
所有页更新,包括分裂、刷盘这样的页管理操作,都是在映射表 PID 位置上的 CAS。
页会因为多种原因被刷到稳定存储,例如 Bw-tree 作为事务系统的一部分时为了让事务日志做检查点,或者在换出页之前(在映射表中装入闪存偏移,回收页内存)。多个线程并发刷页时,需要正确顺序的刷盘必须非常小心。
为了记录页的哪个版本在稳定存储上、在什么位置,Cache 层用 CAS 在页上安装一个 flush delta。它记录了页的哪些变更已经刷过,之后的刷盘只需发送增量;刷盘成功后,flush delta 中包含新的闪存偏移和描述所刷页状态的字段。
#5.1 WAL 协议与 LSN
Bw-tree 作为事务系统的一部分时,需要承担一些事务方面的职责。作者用 Deuteronomy 的术语描述:事务组件(TC)与数据组件(DC,即 Bw-tree)。
- LSN:页上的 insert 和 modify delta 都标有对应操作的 LSN,已刷盘更新中最大的 LSN 记录在 flush delta 里。LSN 由上层 TC 生成,用于其事务日志。
- 与事务日志协作:TC 每次把事务日志追加到稳定存储后,会更新**稳定日志末端(ESL)**LSN:所有更小的 LSN 都已确定在稳定日志中。TC 定期把 ESL 发给 DC。为满足 WAL 的因果性,DC 不能让任何 LSN 大于最新 ESL 的操作持久化,即 DC 在持久化进度上"落后于"TC。因此刷页时,LSN 大于 ESL 的记录不包含在内。
- 推进 RSSP:TC 想推进重做扫描起点(RSSP)以截断之前的事务日志时,会向 DC 提出一个 RSSP,并等待 DC 确认所有 LSN < RSSP 的更新都已持久化——这样重做恢复时 TC 就不必再把这些操作发给 DC。DC 为此要把每个页上 LSN < RSSP 的记录刷盘。这些刷盘从不阻塞,因为 Cache 层总能排除 LSN > ESL 的记录;而传统的原地更新、整页只有一个 LSN 的做法无法做到不阻塞。
- 为支持这种不阻塞,页合并被限制为只合入 LSN ≤ ESL 的更新 delta,这样刷盘时总能把更新的 delta 排除掉。
- SMO:在 SMO 涉及的页外面包一层系统事务写进 LSS。这解决了无锁带来的并发 SMO 问题(比如两个线程试图分裂同一个页):只有确认本线程"赢得"了在相应页上安装 SMO delta 的竞争后,才提交该系统事务。也就是允许并发 SMO,但保证至多一个提交。系统事务的开始和结束记录是 LSS 中少有的不是页的对象。
#5.2 刷页到 LSS
LSS 提供一个大 buffer,Cache 层往里提交页和描述 SMO 的系统事务。
- 页序列化:把页在内存中的指针表示序列化成线性表示写入刷盘 buffer。页状态在决定刷盘时捕获。这一点很重要:之后的更新可能违反 WAL,分裂也可能移走需要写进 LSS 的记录。例如一个页在之前的刷盘请求还在提交时被分裂并合并,如果序列化发生在分裂移走高位 key 之后,LSS 里的版本就会缺少这些记录,而分裂本身尚未刷盘时系统崩溃,这些记录就丢了。序列化时多个 delta 会被合并,使它们在 LSS 中连续存放。
- 增量刷盘:只序列化 LSN 介于该页上次刷盘的最大 LSN(记录在最新的 flush delta 中)和当前 ESL 之间的 delta。增量刷盘让一个页在 LSS 里占的空间远小于整页刷盘,这对日志结构存储很有价值:一是一个刷盘 buffer 能容纳多得多的页更新,提高每页的写效率;二是存储消耗变慢,清理器不用那么辛苦,降低每页的清理开销,也减少"写放大"(清理器遇到未变化的页时不得不重写它)。
- 刷盘过程:刷盘 buffer 攒到可配置的阈值(当时为 1MB)再写 LSS,减少 I/O 开销。使用乒乓双缓冲配合异步 I/O,一个 buffer 写盘的同时准备下一个。I/O 完成后,以 flush delta 的形式(像其他 delta 一样用 CAS 安装)在映射表中记录刷盘结果。如果刷盘覆盖了页的全部更新,页就是"干净的"。
- 换出:Cache 层监控 Bw-tree 的内存用量,超过可配置的阈值就尝试把页换出到 LSS。页干净后即可从缓存中驱逐,其内存由 epoch 垃圾回收器回收。
#6. 性能评估
本文聚焦内存部分,所以实验也只测内存性能,存储上的评估留待后续工作。
#6.1 实现与实验设置
- Bw-tree:约 1 万行 C++,用 Win32 的
InterlockedCompareExchange64实现 CAS,整个实现都是无锁的。 - BerkeleyDB:选它是因为它作为独立存储引擎性能不错,又不需要经过查询处理层。使用 C 版本的 B 树模式,代表"B 树 + 管理页的缓冲池"的典型架构;非事务模式,支持单写多读,用页级 latch(BerkeleyDB 最细的粒度)最大化并发;缓冲池足以容纳全部数据。
- 无锁跳表:跳表因为容易做成无锁、插入快、查找对数时间,已成为内存数据库中 B 树的热门替代品(MemSQL 就用它做有序索引)。实现中元素用 CAS 插入底层链表,以 1/2 的概率提升到上一层,最多 32 层。
- 机器:Intel Xeon W3550(3.07GHz),24GB 内存,4 核 8 超线程。默认 8 个工作线程,页大小 8KB(跳表无页)。
三个负载:
| 负载 | 规模 | key / value | 读写比 |
|---|---|---|---|
| Xbox LIVE | 2700 万次 get/set,来自 Xbox LIVE Primetime 在线游戏 | 平均 94B 的字母数字 key,平均 1200B 的 value | 约 7.5 : 1 |
| 存储去重 trace | 2700 万个 chunk,其中 1200 万个唯一 | 20B SHA-1 key,44B 元数据 | 2.2 : 1 |
| 合成 | 从 100 万条均匀随机 key 的索引开始,执行 4200 万次操作 | 8B 整数 key,8B 整数 value | 5 : 1 |
#6.2 Bw-tree 的调参与特性
delta chain 长度。
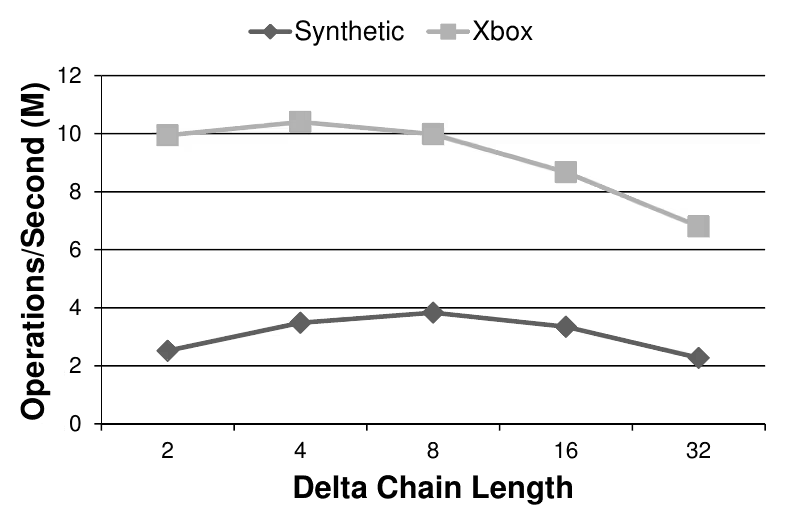
阈值太小,线程频繁合并,开销吃掉了性能。Xbox 负载在超过 4 个 delta 后查找性能开始下降:顺序遍历链表式的 delta chain 虽然有利于分支预测和预取,但 Xbox 的记录很大(约 100B 以上),L1 里装不下几个 delta。合成负载的 key 只有 8B,更容易预取和缓存,delta chain 可以长到约 8 个而不影响性能。
无锁环境下的更新失败。 无锁意味着一些操作会在竞争中失败:
| 分裂失败 | 合并失败 | 更新失败 | |
|---|---|---|---|
| Dedup | 0.25% | 1.19% | 0.0013% |
| Xbox | 1.27% | 0.22% | 0.0171% |
| 合成 | 8.88% | 7.35% | 0.0003% |
记录更新(插入、修改、删除)的失败率极低,所有负载都低于 0.02%。分裂和合并的失败率更高,因为它们要和更快的记录更新竞争。合成负载是最坏情况:记录极小,准备和安装一个更新 delta 极快,同一页上一个更慢的分裂很可能失败。作者认为这些失败率仍然可以接受。
#6.3 与传统 B 树架构对比
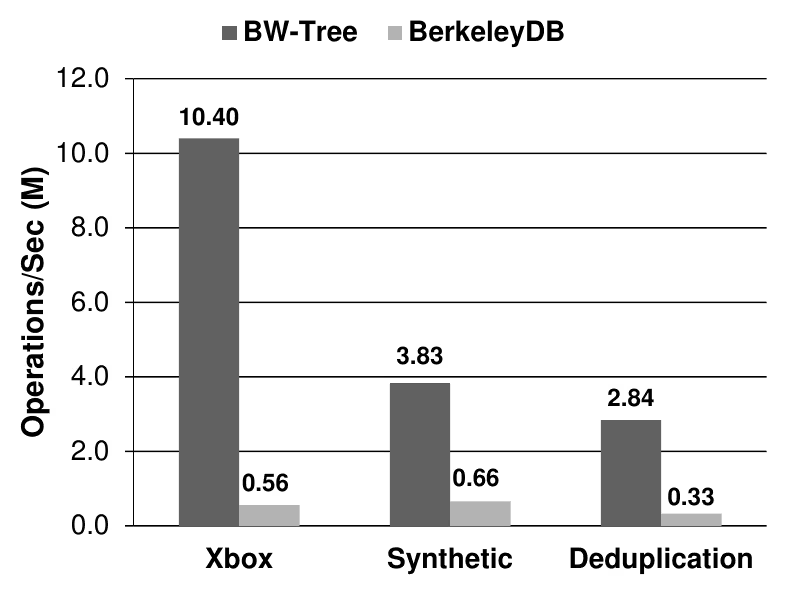
- Xbox:Bw-tree 每秒 1040 万次操作,BerkeleyDB 55.5 万次,18.7 倍;
- 去重(更新更密集):两者都下降,Bw-tree 仍快 8.6 倍;
- 合成:差距缩小到 5.8 倍,原因是上面提到的较高的无锁失败率。
作者认为 Bw-tree 优势的来源有二:
- 无锁:Bw-tree 上读和更新都不阻塞,而 BerkeleyDB 用页级 latch 在更新时阻塞读者。Bw-tree 的 CPU 利用率约 99%,BerkeleyDB 约 60%。
- CPU 缓存效率:Bw-tree 用 delta 更新不可变的 base page,其他线程的缓存很少被失效;BerkeleyDB 原地更新页,往一个典型 B 树页里插入一个元素平均要移动一半的有序记录,让多个缓存行失效。
#6.4 与无锁跳表对比
| Bw-tree | 跳表 | |
|---|---|---|
| 合成负载 | 383 万 ops/s | 102 万 ops/s |
| 只读负载 | 571 万 ops/s | 130 万 ops/s |
合成负载上 Bw-tree 快 3.7 倍。为了弄清来源,作者在 3000 万条记录上做了 3000 万次只读查找,Bw-tree 快 4.4 倍,说明它在查找上有明显优势。
#6.5 缓存性能
用 Intel VTune 单线程跑只读负载,统计内存加载在缓存层级中的分布:Bw-tree 近 90% 的读来自 L1 或 L2,跳表约 75%。
- 跳表每次比较前都要先跟一个物理指针去下一个"塔"或同层的下一条记录,缓存行为很不规律,分支预测失败时尤甚;
- Bw-tree 的查找大部分时间花在对连续内存中 base page 的二分查找上(可能有几个 delta),指针追逐少得多。
换个角度看:所有可能的查找路径上、到达数据页之前访问的节点,在 Bw-tree 中就是内部节点,只占内存的 1% 甚至更少;在跳表中约占 50%。所以同样大小的缓存,Bw-tree 查找时命中缓存的比例更高。
#7. 相关工作
- B 树:Bw-tree 用的是 B+ 树变体,把"面向页"的含义扩展到了不连续的弹性页。弹性页的想法来自 SkimpyStash 的哈希记录列表,同样在垃圾回收时把不连续的片段合并。
- 无锁:在此之前,B 树能否做成无锁并不清楚。跳表是多线程访问同一页时的一种无锁"树"替代;另一种避免 latch 的方法是按 key 空间分区,每个线程负责一个分区(如 PLP、PALM),Bw-tree 用 CAS 处理所有状态变更,包括 SMO 和刷盘这样的"管理"变更,从而避免了分区的开销。
- 闪存与日志结构:早期闪存工作用 in-page logging,把日志记录放在 B 树页附近而不是原地更新(原地更新需要擦除)。Bw-tree 的 delta 有点像 in-page log record,但它们与事务恢复无关,作者把它们看作记录的新版本而不是日志。日志结构最早用于文件系统(LFS),如今也广泛用于磁盘和闪存的转换层。Bw-tree 在 SSD 上仍实现了自己的日志结构存储,这样就能把页紧密地排在 buffer 里,闪存上没有空洞,还能模糊页存储与记录存储的界限,进一步减少刷盘的数据量。
- 组合方案:Hyder 也用闪存上的日志结构存储,但所有修改都要传播到树根,在根上批量处理并压缩路径;在一种模式下它直接支持事务,日志结构存储同时作为数据库和日志。BFTL 是另一个建在日志结构闪存上的索引,可能是在存储管理上与 Bw-tree 最接近的早期工作:它有一张映射表(node translation table),向闪存写 delta,delta 多了再在闪存上整理成连续的。但 BFTL 不处理多线程、并发控制和缓存管理,而这些是 ARS 高吞吐的关键。
#8. 讨论
性能结果。 Bw-tree 能够把更新缓存起来、等到方便时再写稳定存储,这是数据库性能的一个关键,也是 Deuteronomy 中 TC 与 DC 之间的控制操作明确允许的。但这也意味着,与那些立即持久化更新的 ARS 比较时需要小心。
LSS。 无锁环境对存储管理的很多部分都是挑战,几个要点:刷盘 buffer 本身是无锁管理的,向 buffer 提交时没有线程阻塞;用系统事务记录 SMO,保证每个 SMO 在恢复时是原子的;在没有 latch 的情况下保持内存状态与写入 LSS 的状态一致并不简单,LSS 接口在这方面经过了仔细设计。
页内查找优化。 实验结果是在没有使用缓存敏感的页内查找技术的情况下取得的,作者预计加入这类技术还会提升查找性能;更新则继续用 delta 技术。
结论。 Bw-tree 既可以作为独立的 ARS,也可以作为 Deuteronomy 式系统的数据组件,或嵌入传统数据库。它沿用了"访问方法—缓存管理—存储管理"的经典分层,但每一层都有创新:弹性页、delta 更新、共享只读状态、无锁操作和日志结构存储,消除了线程阻塞、提升了处理器缓存效率、减少了 I/O。这些技术也应该适用于哈希和多属性访问方法等其他场景。
#读后感
- Bw-Tree 的核心是一个很朴素的想法:间接层 + 不可变 + CAS。映射表让"换掉一个页"变成换掉一个 8 字节槽位;delta 让"改一个页"变成新建一个小对象。这和函数式数据结构、RCU 是同一种思路,把一切修改都变成"先在私有内存里造好,再一次性发布"。
- 代价同样清楚:读要沿着 delta chain 做指针追逐,链越长越慢;每次修改都要分配内存,epoch 回收也有开销;SMO 拆成多步之后,"帮别人完成 SMO"的逻辑相当复杂,合并尤其如此。论文里的合并时序其实相当微妙,后来 CMU 的 Building a Bw-Tree Takes More Than Just Buzz Words(SIGMOD’18)在开源实现 OpenBw-Tree 中补了大量工程细节,并发现在内存场景下 Bw-Tree 未必比带乐观锁的 B+ 树(如 Masstree、ART 配 OLC)更快。
- delta chain 的另一个角色是写缓冲:刷盘时只写 delta,日志结构存储因此能装下更多页。十年后 Bf-Tree 保留了"内存里攒写、批量落盘"的目的,却换掉了实现:不用链表,而是一个按 key 有序、可伸缩的 mini-page,读的时候一次二分就够了。
- 内存回收的 epoch 方案和 内存分配器 中的延迟释放是同一类问题:无锁数据结构里"谁还在看这块内存"无法靠锁回答,只能靠时间(epoch、RCU 宽限期)或引用计数(hazard pointer)。
#参考资料
- Justin J. Levandoski, David B. Lomet, Sudipta Sengupta. The Bw-Tree: A B-tree for New Hardware Platforms. ICDE 2013.
- Justin Levandoski, David Lomet, Sudipta Sengupta. LLAMA: A Cache/Storage Subsystem for Modern Hardware. VLDB 2013.(即文中"另一篇论文"所述的缓存与存储层)
- Ziqi Wang et al. Building a Bw-Tree Takes More Than Just Buzz Words. SIGMOD 2018.
- Philip L. Lehman, S. Bing Yao. Efficient Locking for Concurrent Operations on B-Trees. TODS 1981.(B-link 树)
- Justin Levandoski et al. Deuteronomy: Transaction Support for Cloud Data. CIDR 2011.