[OSDI'20] The CacheLib Caching Engine: Design and Experiences at Scale 论文阅读
CacheLib 是 Facebook(现 Meta)的通用缓存引擎,一个 C++ 库。它把"缓存"中可以复用的部分抽出来——索引、淘汰策略、slab 内存分配、DRAM + 闪存的混合缓存、热重启、内存监控——让各业务方只需在其上搭建自己的缓存服务,或者直接嵌进进程里当本地缓存用。
CacheLib 2017 年上线,到论文发表时(2020 年)已支撑 Facebook 内部 70 多个服务,包括 CDN、社交图谱缓存、应用层 look-aside 缓存和块存储缓存。2021 年开源。
本文发表于 OSDI 2020,作者来自 CMU 与 Facebook:Benjamin Berg、Daniel S. Berger、Sara McAllister、Isaac Grosof、Sathya Gunasekar、Jimmy Lu、Michael Uhlar、Jim Carrig、Nathan Beckmann、Mor Harchol-Balter、Gregory R. Ganger。论文原文:osdi20-berg.pdf,代码:facebook/CacheLib
把它放进内存管理系列,是因为 CacheLib 的 DRAM 部分本质上就是一个以淘汰代替 free 的 slab 分配器:内存按 slab 切给各个尺寸类别,满了就淘汰,类别之间还要搬 slab。读这篇论文时可以和 Slab Allocator、内存管理串讲 对照着看。
#摘要
Web 服务几乎在系统的每一层都依赖缓存。通常每个缓存由不同团队独立实现和维护,并针对自己的功能高度特化,比如应用数据缓存和 CDN 缓存毫无关系。但这种做法忽视了不同缓存系统共同面对的难题,大大增加了部署、维护和扩展每个缓存的总工作量。
本文介绍 Facebook 采用的另一种思路:从原本互不相干的缓存系统里提炼出一组共同的需求和功能。CacheLib 是一个通用缓存引擎,基于 Facebook 一系列缓存场景的经验设计,让缓存的开发和维护变得容易。CacheLib 2017 年首次部署,如今支撑 70 多个服务。论文介绍了从各自为政的专用缓存迁移到 CacheLib 的经验、生产负载特征如何驱动设计决策、缓存系统随时间的演进和 CacheLib 带来的收益,以及这些经验对未来缓存设计和研究的启示。
#1. 引言
在 Facebook,CDN 缓存承接了 70% 的 Web 请求,把延迟降低一个数量级;一台缓存服务器能达到后端数据库 20 倍的吞吐、80% 以上的命中率,抵得上几十台数据库服务器。
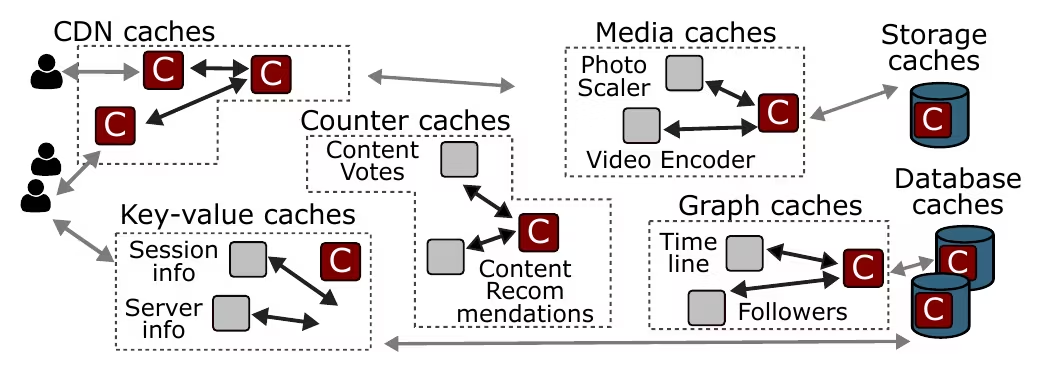
Facebook 的架构中有 CDN 缓存、KV 应用缓存、社交图谱缓存、媒体缓存、存储缓存、数据库缓存……历史上它们都是分别实现的。当时的看法是:每个专用系统都需要专用缓存,才能实现复杂的一致性协议、使用定制数据结构、针对目标硬件优化。
但这些系统面对的工程难题高度重合:每秒处理上百万请求、工作集大到必须同时用 DRAM 和闪存、要能扛住频繁的版本发布重启。缓存系统越来越多,各自维护一套实现变得难以为继:同样的难题被反复解决,代码大量冗余,一个系统里的性能优化也无法惠及其他系统。
于是 Facebook 面临通用性与专用性的取舍:通用方案可能丢掉一些领域特定的优化,但能降低开发成本、让优化在系统间共享。CacheLib 就是这一取舍的产物。最初它用来替换已有的缓存,2018 年年中以后则推动了大量新缓存的出现,基于 CacheLib 的服务数持续增长,显著降低了后端负载。
#1.1 从 CacheLib 中得到的经验
作者认为,以下几点和"缓存领域的常识"并不一致:
专用缓存可以、也应该建立在通用缓存引擎之上。 CacheLib 已经替换了多个大型服务中原有的专用缓存,也催生了许多新的缓存应用。它提供的功能比任何一个专用系统都多;共享的核心功能省掉了数万行重复代码,提升了稳定性,让新缓存的部署和调优变得简单。CacheLib 还成了优化和最佳实践的汇聚点:基于它的系统单机峰值可达每秒百万请求,命中率在 60%~90% 之间。
生产负载需要超大规模的缓存。 过去的生产负载研究没有公开 key 的流行度分布,因此流行的 benchmark 和学术论文大多假设流行度服从 的 Zipf 分布,由此得出"DRAM 缓存在大多数情况下就够用"的结论。作者给出证据:这些模型对生产负载的可缓存性过于乐观。Facebook 的负载比通常假设的更难缓存,需要每节点数百 GB 的容量才能达到可接受的命中率,这让闪存变得很有吸引力——而大多数缓存系统历来面向 DRAM,用在闪存上表现不佳。
缓存不是一个已解决的问题。 自 2017 年上线以来,CacheLib 不断因新需求加入新功能,这些功能又被新老用户迅速采用。
#1.2 弥合研究与生产缓存系统之间的鸿沟
学术界的缓存研究往往也面向某种专用系统,其假设很少与生产环境完全吻合,这阻碍了研究成果被工业界采纳。作者希望 CacheLib(以及随之开源的部分 Facebook 负载)能成为外部新想法的试验平台。
#2. 动机:缓存的使用场景
论文列举了六类生产场景:
- 分层、地理分布的缓存:CDN 服务照片、音频、视频分块等静态内容。部署在 Facebook 网络之外的 CDN 节点目标是减少广域网字节数(字节缺失率),数据中心内的 CDN 节点目标是减少对后端和存储的请求(对象缺失率)。每台 CDN 服务器的本地缓存横跨 DRAM 和闪存。
- 应用 look-aside 缓存:缓存数据库查询结果、用户数据、使用统计等。每个应用单独做一套缓存既低效又难维护,因此应用通过 RPC 访问一组共享的缓存服务,每个缓存服务本身是一个大型分布式系统。
- 进程内缓存:有些应用连远程缓存的 RPC 开销都承受不起。例如用于限流的会话信息:流量计数器会遇到极高的突发请求,流量平息后就可以淘汰。这种延迟和带宽要求只能用进程内缓存满足,CacheLib 提供对计数器的零拷贝访问。
- 机器学习模型服务:一方面缓存用户与内容交互的计数器(如点赞)作为模型输入;另一方面,相同输入反复推理代价很高,模型的预测结果也会被缓存。
- 存储后端缓存:Facebook 用大量机械盘集群存放持久化数据块。即使前面有好几层缓存,一些块仍然热到超过磁盘的 IOPS 上限,于是存储服务器用闪存缓存热块。为了支持按字节范围读和追加写,这些闪存缓存与存储栈紧密集成。
- 数据库页缓冲:数据库用页缓存提升吞吐、降低延迟,为支持一致性和事务,页缓存与数据库逻辑紧耦合。
CacheLib 用在了其中的五类,唯独没有用作数据库页缓冲(原因见第 6 节)。所以 CacheLib 并不会取代所有专用缓存,但通用缓存引擎在 Facebook 内部得到了大规模采用。
#3. 各缓存系统共同面对的挑战
本节数据采集于 2019 年 12 月到 2020 年 5 月,来自四个重要负载,每个负载都是对应服务中一台机器的流量:
| 负载 | 说明 |
|---|---|
| Lookaside | 为各种应用提供按需缓存的服务 |
| SocialGraph | 专门缓存社交图谱信息 |
| Storage | 存储后端缓存 |
| CDN | CDN 中的缓存 |
#3.1 巨大的工作集
工作集指负载中足够热、值得缓存的那部分对象。工作集越大,达到同样命中率所需的缓存就越大。衡量工作集既要看一段时间内热数据的总量(流行度),也要看热度随时间的变化(churn)。
流行度。 大量既往研究认为 CDN 和 Web 负载服从高度偏斜的 Zipf 分布:第 热的对象相对频率为,多数测量给出,这也成了许多系统论文的标准评估假设。
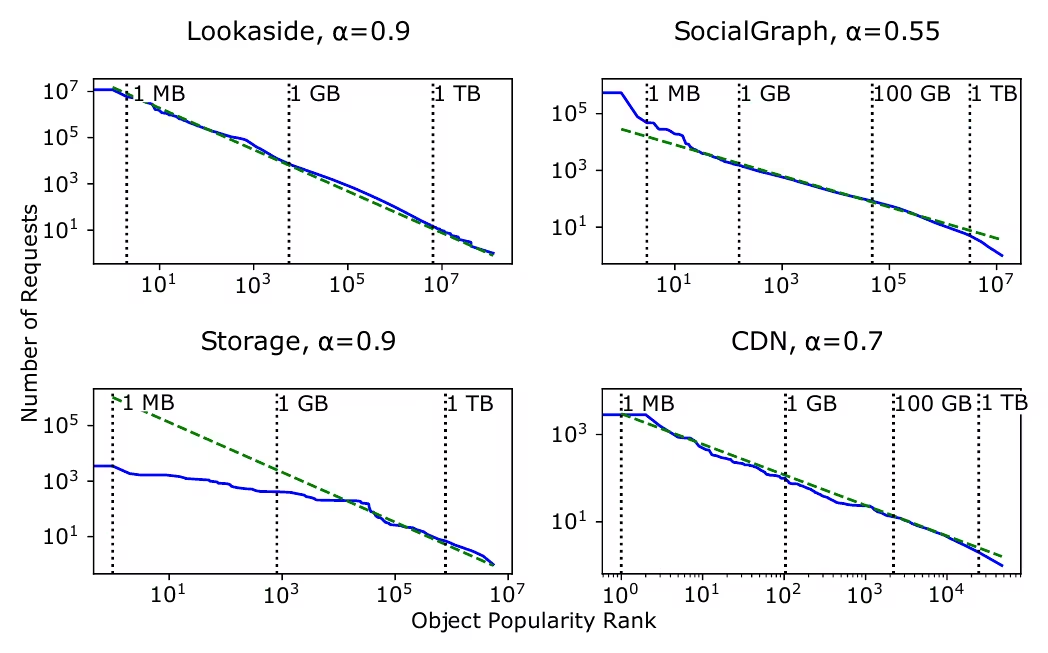
图中每条线是请求次数随流行度排名的变化,绿色虚线是最佳拟合的 Zipf 分布,竖线标出排在其左侧的热对象的累计大小。在 log-log 坐标下 Zipf 是一条斜率为 的直线:
- 只有 Lookaside 符合 接近 1 的 Zipf;
- Storage 在头部明显更平,只有尾部像 Zipf,根本不是 Zipf;
- SocialGraph 和 CDN 虽然是 Zipf,但 只有 0.55 和 0.7。 越小,落到长尾的请求越多,工作集越大。
注意竖线:要覆盖 SocialGraph 和 CDN 的大部分请求,需要的缓存容量是 100GB 到 1TB 量级。
Churn。 流行的 YCSB 负载生成器假设没有 churn,即每个 key 在整个测试期间热度不变,这同样被大量论文沿用。而 Facebook 的生产负载 churn 很高:
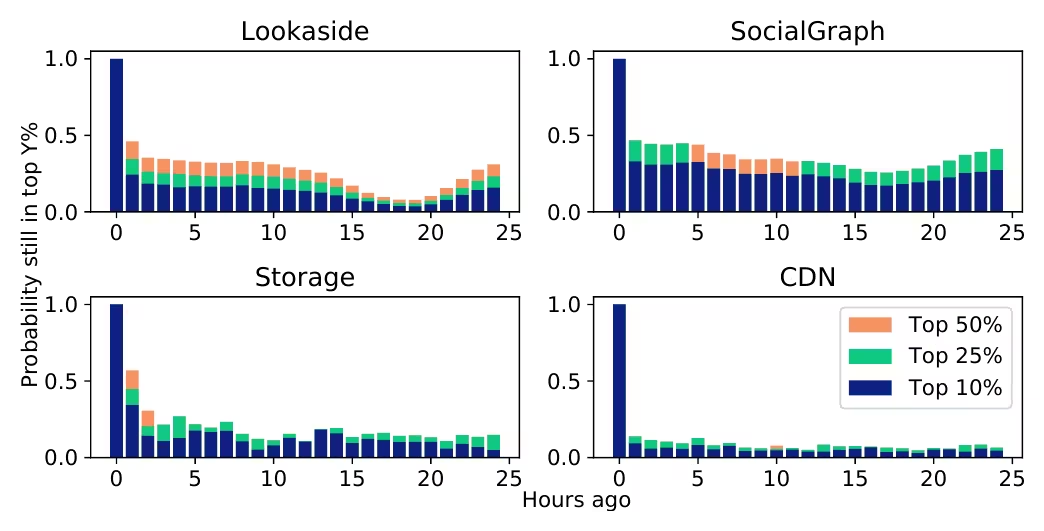
把每小时请求最多的前 10% 对象定义为"热门",图中 处的柱子表示 3 小时前的热门对象此刻仍然热门的概率。所有负载中,一小时后超过三分之二的热门对象就掉出了前 10%;换不同的基准小时、不同的百分位(前 25%)、不同的时间粒度(10 分钟后已有 50% 不再热门),结论都一样。高 churn 让时间局部性更加重要,也让缓存策略更难根据历史访问估计流行度。
#3.2 对象尺寸差异大
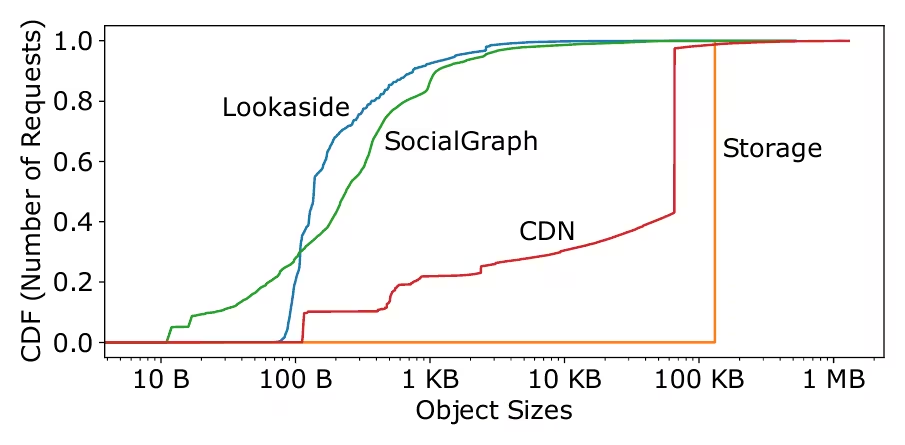
图中横轴是对象大小(对数),纵轴是请求中对象小于该大小的比例。
- Storage 和 CDN 会把大对象切成 64KB、128KB 的分块,所以这两个尺寸非常集中;
- Lookaside 和 SocialGraph 的对象大小跨越七个数量级以上,并且小对象占绝大多数——来自图的点和边、RPC 计算结果和负缓存(见 4.3 节)。
这给通用缓存的设计空间设了限:
- 很多现有系统每个 cache line(64B)最多存一个对象。对于有大量 10~20B 对象的 SocialGraph,这非常浪费空间。
- 闪存缓存需要一个内存中的索引,现有系统每对象的索引开销在 8B 到 100B 之间。对于中位对象大小 100B 的 Lookaside,索引一块 1TB 的闪存需要 80GB 到 1TB 的 DRAM。
必须在尺寸高度可变的同时控制住内存和存储开销。
#3.3 突发流量
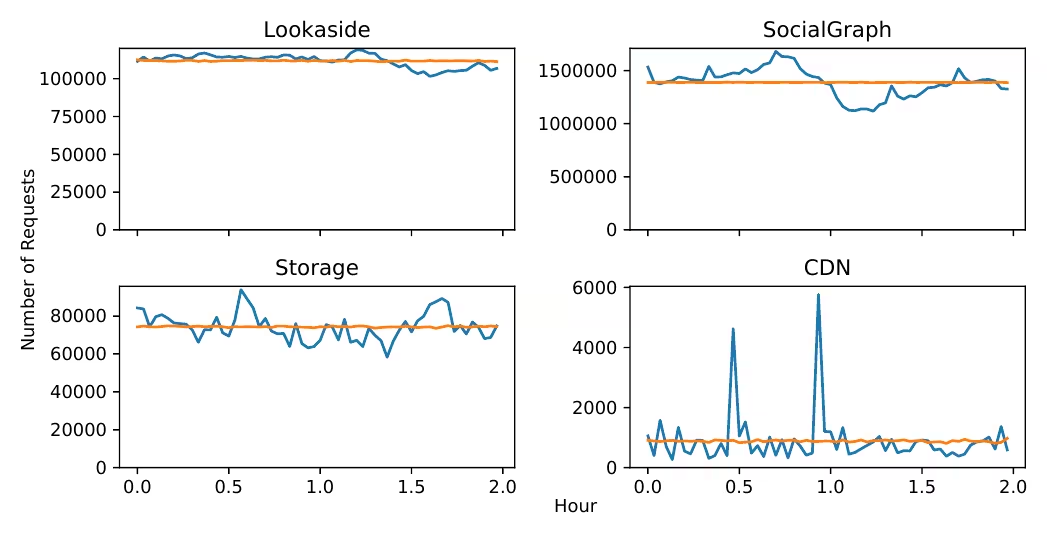
蓝线是每两分钟的实际请求数(取一天中的高峰两小时),橙线是同均值的泊松到达。实际到达率的波动远大于许多系统评估中假设的泊松过程,CDN 尤其明显:平稳的基线上叠加着尖锐的突发。到达率剧烈变化使得很难为缓存预留足够资源、在峰值时维持低延迟。
#3.4 资源管理
缓存应该用满可用资源而又不越界,这一点对 DRAM 尤其重要。常见部署是 CacheLib 与应用进程、内核共享 DRAM,负载构成和强度一变,可用于缓存的内存就会大幅波动;变长对象的缓存本身内存占用也难以预测。把所有可用内存都分给缓存会导致内存超售——这是进程内缓存的老问题:应用的一次内存尖峰就可能让内核的 OOM killer 干掉整个进程,缓存随之清空。许多开源缓存系统并不感知 OOM,带来了不小的运维麻烦。CacheLib 会动态申请和释放缓存内存,既避免崩溃,又不留下太多闲置内存。
#3.5 结果为空的高成本查询
缓存通常只关心有效查询的结果,但有些场景会频繁查询不存在的对象。例如查询两个用户之间的共同关联,结果经常为空,而这类查询对后端数据库代价很高。在 SocialGraph 的负载中,55.6% 的请求访问的是不存在的 key;剩下 44.4% 有效请求的命中率为 86.5%。如果不缓存空结果,整体命中率会大打折扣。
#3.6 更新已缓存的数据结构
缓存应能高效支持结构化数据,这对直接操作应用数据结构的进程内缓存尤为重要。比如上面的限流器在一个缓存对象里存了多个字段,应用希望能直接更新其中某个字段,而不必反序列化、修改、再序列化整个对象。
#3.7 频繁重启
生产缓存会为了上线修复和更新频繁重启:工程团队不仅需要快速发布新代码,还需要能快速回滚。75% 的 Lookaside 缓存和 95% 的 CDN 缓存运行时间不足 7 天;Storage 和 SocialGraph 平均运行更久,但也有每月一次的例行维护重启。
大多数缓存系统是易失的,重启即清空。对大缓存而言这很要命:重启后命中率要几个小时甚至几天才能恢复稳定。已有的方案是重启后显式预热,但这需要在路由层增加预热阶段,或者放慢发布节奏。
#3.8 小结
不是每个场景都会遇到上面所有挑战,但每个场景都会遇到其中好几个。通用缓存引擎的价值在于:每个应用都能在需要时直接用上 CacheLib 的全部功能。
#4. 设计与实现
针对前两节的挑战,作者认为通用缓存引擎必须具备:
- 线程安全的缓存原语:读、写、删的 API 线程安全,简化突发流量下的编程,也简化一致性与失效协议的实现。对同一 key 的并发调用满足线性一致性,并尽量减少资源争用。
- 透明的混合缓存:支持 DRAM + 闪存组成的混合缓存,单节点 TB 级容量。无论底层介质是什么,都提供同样的字节寻址接口,应用无需关心对象何时、写到了哪种介质上,也便于迁移到新的硬件配置。
- 低资源开销:吞吐高、内存和 CPU 占用低,才能适合与应用共享资源的进程内缓存,并支持大量小对象。
- 结构化 Item:原生实现可缓存的数组和哈希表,修改时没有序列化开销。
- 动态资源监控、分配与 OOM 保护:监控整机内存使用,动态增减缓存内存,防止临时的内存尖峰导致崩溃。
- 热重启:代码更新时保留缓存状态,免去每次重启都重新预热。
#4.1 CacheLib API
API 既要足够简单,让应用开发者很快搭出进程内缓存、几乎不用调参;又要足够强大,支撑复杂的应用层一致性协议和高性能的零拷贝访问。
1 | ItemHandle allocate(PoolId id, Key key, uint32_t size, uint32_t ttlSecs = 0) |
API 围绕 Item 展开,它是缓存对象的抽象表示,无论对象在 DRAM 还是闪存上,都提供字节寻址的访问。对 Item 的访问通过 ItemHandle 进行,它实现了引用计数:
- ItemHandle 构造时引用计数加一,析构时减一;引用计数不为 0 的 Item 不会被淘汰。
- 如果一个仍被引用的 Item 过期或被删除,已有的 ItemHandle 依然有效,但不会再为它发放新的 ItemHandle。
各操作的语义:
allocate:在指定的内存 pool 中创建新 Item,必要时按淘汰策略先淘汰别的(没有被引用的)Item,可以设置过期时间(TTL)。pool 可以单独配置,提供强隔离。新 Item 在insertOrReplace完成之前对外不可见。find:按 key 取得 ItemHandle,之后通过getMemory获得 Item 的内存,进行无同步的零拷贝访问。- 原子更新:为要更新的 key
allocate一个新的 ItemHandle,用getMemory写好内容,再insertOrReplace使其可见。 markNvmUnclean:由于客户端直接访问裸内存,CacheLib 只能信任用户如实标记修改过的 Item(决定它被淘汰时是否需要重新写回闪存)。remove:删除 key 对应的 Item,表示底层对象已失效或被删除。
结构化数据通过 TypedHandle 访问,方法与 ItemHandle 相同,但可以直接把内存当作用户定义的类型使用,并和普通 Item 一样被缓存、淘汰:
1 | struct MyType { int foo; char bar[10]; }; |
除了定长结构,CacheLib 也支持变长结构,比如可动态增长、支持零拷贝访问条目和范围查询的哈希表,以及数组、可迭代 buffer 等。API 用 C++ 实现,另有 Rust 等语言的绑定。
#4.2 架构概览
为了容纳巨大的工作集和变化剧烈的对象尺寸,同时保持低的每对象开销,一个 CacheLib 缓存由若干子系统组成,每个子系统针对一种存储介质和一档对象尺寸:
- DRAM 缓存;
- 闪存缓存,又分为两部分:
- LOC(Large Object Cache):存放 ≥2KB 的 Item;
- SOC(Small Object Cache):存放 <2KB 的 Item。
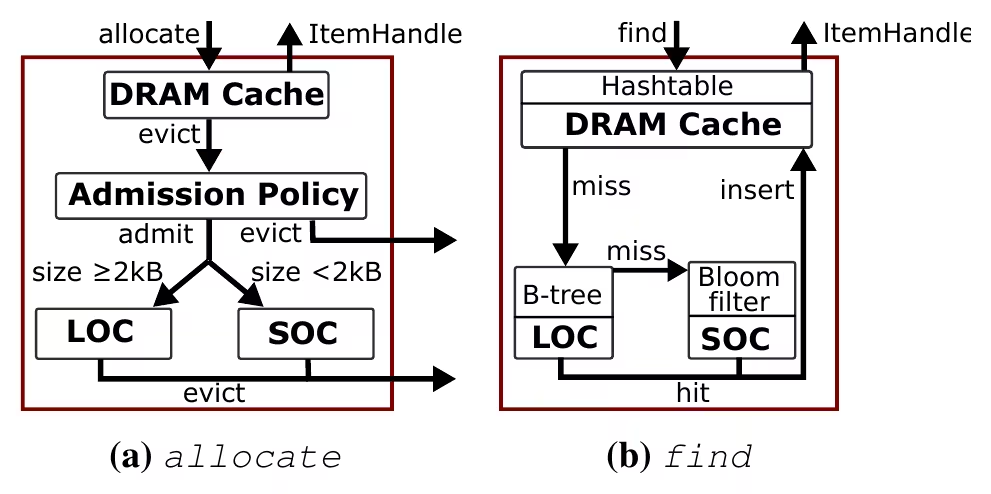
allocate:在 DRAM 中分配空间,必要时从 DRAM 淘汰 Item。被淘汰的 Item 经过准入策略,要么按大小写入 LOC 或 SOC(可能再引起闪存上的淘汰),要么直接丢弃。find:依次查 DRAM → LOC → SOC。这一顺序使缓存的平均访问时间最小(见附录 A)。find立即返回 ItemHandle:对象在 DRAM 中则立即可用;在闪存上则异步读取,读进 DRAM 后 ItemHandle 才就绪;返回空 ItemHandle 表示未命中。
#DRAM 缓存
DRAM 缓存使用链式哈希表做查找。缓存可以划分成多个 pool,每个 pool 有自己的淘汰策略;allocate 时指定 PoolId,就能在一个缓存实例里隔离不同类型的流量。
内存分配采用 slab class:每个 slab class 存放尺寸相近的对象。CacheLib 使用 4MB 的 slab,自己实现了 slab 分配器。每个 slab 只需 7B 的 DRAM 元数据(3B 内部元数据 + 4B 标识该 slab 的对象尺寸)。由于 CacheLib 的负载经常包含大量某个特定尺寸(比如 80B)的对象,每个 slab class 的尺寸按负载单独配置,以减少碎片。小于 64B 和大于 4MB 的对象另有优化,见 4.3 节。
这和 通用 malloc 里的 size class 是同一个思想,区别在于两点:一是 size class 的边界不是固定的几何级数,而是按负载调出来的,因为缓存里的对象尺寸往往高度集中;二是满了以后不是向操作系统要更多内存,而是在本 slab class 内淘汰。后者带来一个新问题:各 slab class 分到的 slab 数决定了各尺寸对象的有效缓存容量,需要动态调整。
每个 slab class 维护自己的淘汰策略状态。 CacheLib 的设计便于不断加入新的淘汰策略,目前支持 LRU、多插入点的 LRU、2Q 和 TinyLFU。这些策略在开销、偏重近期性还是频率上各不相同,因此也按负载配置。为了近似一个全局的淘汰策略,CacheLib 用已有的再平衡算法在 slab class 之间搬移 slab。
为了支撑这些功能,CacheLib 为每个 Item 付出 31B 的 DRAM 元数据:
| Item 元数据 | DRAM 开销 | 数据类型 |
|---|---|---|
| 淘汰策略状态 | 12B | 1 个 4B 时间戳,2 个 4B 指针 |
| Item 创建时间 | 4B | 4B 时间戳 |
| 过期时间(TTL) | 4B | 4B 时间戳 |
| key 大小 + 对象大小 | 4B | 4B size_t |
| 引用计数 | 2B | 13 bit 外部引用计数,3 bit 内部引用计数 |
| 哈希表链 | 4B | 4B 指针 |
| 标志位 | 1B | 8 个二进制标志 |
注意表里的"指针"都只有 4B:LRU 双向链表的前后指针和哈希链指针都不是 64 位裸指针,而是压缩过的(见文末"开源实现补充")。
并发。 为保证元数据操作的原子性,CacheLib 综合使用了细粒度锁、用户态互斥量和 C++ 原子操作。这对淘汰策略尤其关键,朴素实现会造成严重的锁争用。比如 LRU 下热门 Item 会频繁争着被移到 MRU 位置,在 Facebook 的高请求率下这非常常见。CacheLib 的办法很简单:最近被移到 MRU 位置的 Item,在时间 内不再重复移动。只要 远小于对象从 LRU 头走到尾的时间(淘汰年龄),这个简化在实践中就不影响命中率。CacheLib 还使用 flat combining 等更高级的同步手段来减少争用。
#闪存缓存
从 DRAM 淘汰的 Item 可以选择写入闪存缓存。由于 churn 很高,闪存上的内容在持续变化,CacheLib 除了要控制每对象开销,还必须应对闪存单元有限的写入寿命。
为减少写入,CacheLib 有选择地写闪存:如果对象已经在闪存上、且在 DRAM 中期间没被修改,就不写回;否则按可配置的准入策略决定是否写入。默认策略是以固定概率 准入,调节 就能精细控制闪存的写入速率。
另一个要考虑的是写放大——写到设备上的字节数超过插入缓存的字节数。作者区分了两种:
- 应用层写放大:CacheLib 自己写到闪存的字节比对象本身多,例如要写元数据、只能按块粒度写;
- 设备层写放大:由闪存设备固件(FTL)造成。
CacheLib 的闪存缓存要在这两种写放大和 DRAM 开销之间权衡。
LOC:大对象缓存。 LOC 存放 >2KB 的对象,所以一块盘上的对象数只有百万量级,在内存中维护完整索引是可行的。
- 索引是 DRAM 中的分段 B+ 树,记录 Item 在闪存上的位置。Item 按 4KB 闪存页对齐,所以位置只需一个 4B 的页地址,最多可索引 16TB 闪存。
- key 被哈希成 8B:前 4B 选择 B+ 树分段,后 4B 作为分段内的 key。哈希冲突会让 CacheLib 误以为找到了对象,因此闪存上的元数据里存了完整的 key,读出来后再校验。
- 闪存被划分为多个 region,每个 region 存放一档尺寸范围的对象。于是对象大小可以从它所在的位置推断出来,DRAM 里不必存大小,读取时一次就能读对字节数。
- 为了压缩 DRAM 中的地址,每个 4KB 页最多只存一个对象及其元数据。因为 LOC 的对象都大于 2KB,这样做的空间浪费不大;大于 4KB 的对象可以跨多页。由于按页读写,页内碎片也会转化为应用层写放大。
- 为了摊销擦除的开销,LOC 按 region 整体淘汰(region 大小可配,如 16MB)。默认用 FIFO,使 region 严格按顺序擦写;顺序写能改善 FTL 的表现,大幅降低设备层写放大。FIFO 淘汰掉的热门对象可以被重新准入。此外也支持以 region 为粒度的伪 LRU:访问 region 内任何对象都把整个 region 移到 MRU 位置,淘汰时擦除 LRU 端的 region。
SOC:小对象缓存。 SOC 存放 <2KB 的对象。一块 1TB 的盘能装下数十亿小对象,精确索引会占用不合理的 DRAM,所以 SOC 使用与闪存页数而非对象数成正比的近似索引:
- key 被哈希到 set,每个 set 对应一个 4KB 闪存页,页里存多个对象;
- set 内按 FIFO 淘汰;
- 为了避免每次查找都读闪存,DRAM 中为每个 set 维护一个 8B、4 个哈希函数的 Bloom filter,记录该页上的 key,能挡掉 90% 以上的无效读。
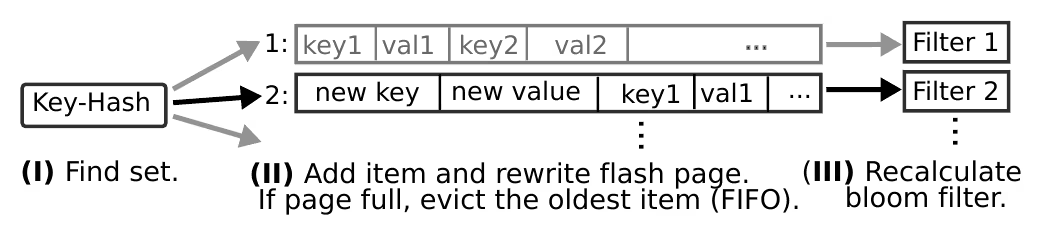
alloc:(I) 哈希找到 set;(II) 把新对象加入并重写整个闪存页,页满则按 FIFO 淘汰最旧的对象;(III) 用页上现有的 key 重新计算 Bloom filter。
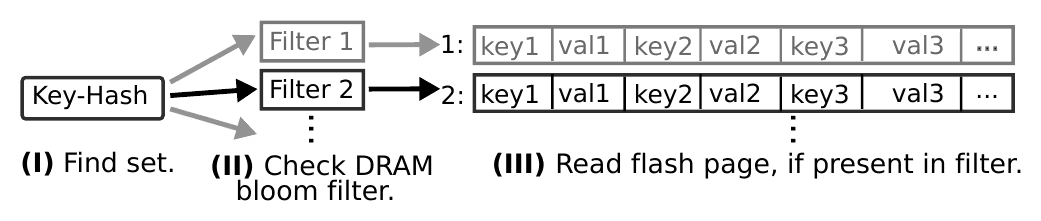
find:(I) 哈希找到 set;(II) 检查 DRAM 中的 Bloom filter,不命中则对象一定不在闪存上;(III) 否则读出 4KB 页并查找 key。
SOC 的写放大格外难控制:
- 准入一个对象要写整个 4KB 页,这是很大的应用层写放大;
remove同理; - key 被哈希到各个 set,连续准入的对象会变成随机写,设备层写放大更高;
- SOC 只能用命中时不需要更新状态的淘汰策略(如 FIFO),因为命中时更新 set 意味着再写一次 4KB 页。
这些都凸显了准入策略的重要性(见 5.2 节)。
#4.3 高级功能的实现
结构化 Item。 由于 CacheLib 提供对缓存内存的裸访问,扁平的数据结构直接就能缓存。此外它原生支持数组和 map:Array 存定长对象,每个条目没有额外开销;Map 支持变长对象,有有序和无序两种,每个条目额外 4B 存大小。
DRAM 中的大对象与小对象。
- 大于 4MB 的对象:把多个 DRAM Item 串成一条链,组成一个逻辑上的大 Item,链上每个对象多一个 4B 的
next指针。最常见的用途是结构化 Item:单个逻辑对象超过 4MB 不多见,但总量超过 4MB 的 Array 或 Map 很常见。 - 小于一个 cache line(64B 或 128B)的对象:使用 compact cache。compact cache 把 key 大小和对象大小都相同的对象存在同一个 cache line 里,是一种组相联缓存:每个 cache line 是一个 set,由 key 的哈希索引,在 set 内通过移动对象位置实现 LRU。compact cache 没有每对象开销。
compact cache 的一个典型用途是负缓存(negative caching):负缓存对象表示某个后端查询曾经返回空结果,只需存一个 key,又小又定长。如 3.5 节所述,负缓存显著提高了 SocialGraph 的命中率。Lookaside、Storage、CDN 不使用负缓存,但最大的 10 个 CacheLib 系统中有 4 个用了它。
这两个功能体现了 CacheLib 的整体设计思路:为不同尺寸的对象提供专门的方案,以压低每对象开销。
动态资源使用与监控。 CacheLib 监控整机内存使用,持续调整 DRAM 缓存大小,使其保持在设定的界限内。几个参数:
- 当系统空闲内存低于
lowerLimitGB,CacheLib 每轮释放upperLimitGB与lowerLimitGB之差的percentPerIteration,直到空闲内存高于upperLimitGB; - 最多释放缓存总量的
maxLimitPercent,防止缓存缩得太小; - 空闲内存回升后,用类似的过程把内存要回来。
释放内存可能引起淘汰,但这远比进程被 OOM 杀掉要好——那对命中率的伤害大得多(见图 15)。
热重启。 DRAM 缓存空间通过 POSIX 共享内存分配。缓存关闭时把状态留在共享内存里,新进程启动后接管。DRAM 缓存的索引默认一直放在共享内存中,其他 DRAM 状态在关闭时序列化到共享内存;LOC 的 B 树索引和 SOC 的 Bloom filter 则在关闭时序列化后写到闪存上的专门区域。
#5. 评估
评估想说明两件事:CacheLib 的 API 和功能足够灵活,能在 Facebook 内外实现常见场景,且不需要对核心引擎做任何特化就能达到与专用方案相当的性能;以及 CacheLib 的大规模采用对 Facebook 生产环境产生了显著影响。
#5.1 与其他系统的对比
实验使用 CacheLib 自带的基准工具 CacheBench。它按可配置的流行度、key 大小、对象大小分布生成请求,并以可配置的速率持续引入新 key 来模拟 churn,参数取自第 3 节的测量。为了对比,作者把 CacheBench 扩展到了进程内版的 Memcached 和 HTTP 代理缓存。
应用 look-aside 缓存。 在 CacheLib 出现前,Facebook 好几个团队用的是内部版的 Memcached,现在都换成了基于 CacheLib 的 look-aside 缓存。作者对比了 CacheLib 与几乎未改动的 Memcached v1.6.6(当时最新版本,包含许多近期优化),两边都用各自的 LRU 实现,各 32 线程,缓存大小从 8GB 到 144GB,工作集约 1 亿个对象。缓存小时命中率低,主要压测淘汰路径(set);缓存大时命中率高,主要压测 LRU 头部更新路径(get)。
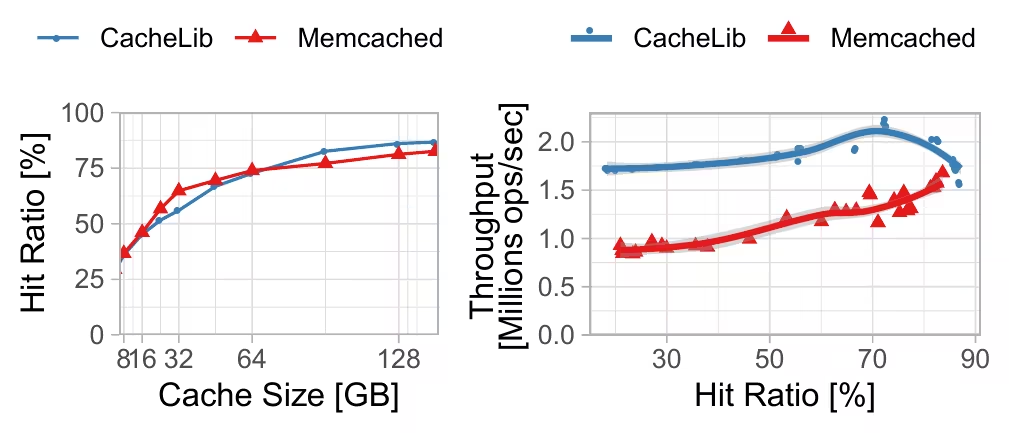
两者命中率相近(小缓存时 Memcached 略高,大缓存时略低),但 CacheLib 的吞吐在所有缓存大小下都更高,最多高出 60%。这主要归功于减少锁争用的优化:用 flat combining 降低 LRU 头部的争用,以及 秒的 MRU 移动抑制。若取 秒,CacheLib 的命中率会稳定超过 Memcached,代价是吞吐下降。生产中大多用默认的 60 秒。
HTTP 服务器缓存。 混合缓存在 Facebook 中很普遍,比如 CDN 代理缓存。作者把基于 CacheLib 的 HTTP 缓存(NGINX 前端 + FastCGI 服务)与 NGINX、Apache Traffic Server(ATS)对比,三者都用默认配置、512GB 闪存缓存,源站性能足够高、不会成为瓶颈。实验把所有对象设为同一大小,对一系列对象大小分别测试,并调整对象数量使工作集大小不变。
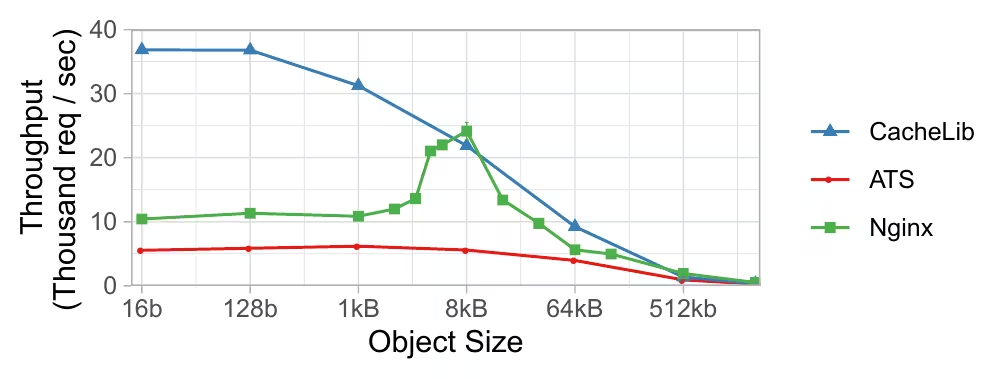
对小对象的专门处理让 CacheLib 明显领先;对象越大,优势越小,最终三者都受限于网络带宽,吞吐急剧下降。NGINX 在 4KB~16KB 表现特别好,在 8KB 时略胜 CacheLib,作者没能找出原因。总体上 CacheLib 在很宽的对象大小范围内都优于两者。
基于 LSM 树的存储。 一个自然的问题是:能不能直接拿面向闪存的存储系统当闪存缓存?Facebook 的 RocksDB 用 LSM 树提供 DRAM + 闪存的混合存储,作者在生产中用它缓存 SocialGraph 的数据做了试验:
- RocksDB 用更多空间换取更低的写和删除延迟:删除只写墓碑,等到 compaction 才真正执行。但 compaction 很贵,只能偶尔做,因此无法用
Delete做定向淘汰来控制缓存占用的闪存空间。一旦写满闪存,RocksDB 的写和删除就开始失败。这对 SocialGraph 尤其致命,因为它依赖删除维持缓存一致性,删除失败到一定次数就要冷重启。 - 改用 FIFO compaction(超过容量就丢掉最旧的数据)可以持续运行、有效限制闪存占用。但"最旧"意味着最久未更新,而非最久未使用,RocksDB 也没有追踪哪些块包含近期使用对象的机制。结果 RocksDB 命中率只有 53%,CacheLib 为 76%;而且 FIFO compaction 下读放大严重,为达到生产吞吐需要比 CacheLib 多 50% 的 CPU。
结论是 LSM 树的一些原则可以借鉴到闪存缓存设计中,但 RocksDB 本身不适合在 Facebook 做缓存。
#5.2 生产环境中的 CacheLib
DRAM 开销。 LOC 和 SOC 的 DRAM 开销在生产中分别小于 0.1% 和 0.2%;DRAM 缓存的开销一般低于 7%,主要来自两部分:slab class 碎片和元数据(附录 B):
| Lookaside | Storage | SocialGraph | |
|---|---|---|---|
| 碎片 | 3.9% | 3% | 1.6% |
| 元数据 | 3% | 4% | 1% |
| 总开销 | 6.9% | 7% | 2.6% |
调好 slab class 是控制碎片的关键,目前靠手工调;不调的话很多集群的碎片开销会翻倍以上。作者表示不知道有什么自动确定 slab class 边界的算法——已有工作研究的是如何在固定的 slab class 之间分配空间,而不是怎样定义边界;这个问题形式上类似"直线上的设施选址问题",但也没有已知的最优算法。
闪存寿命。
- LOC 因 4KB 页和尺寸分档产生的碎片带来应用层写放大,一般不大,但 Storage 和 CDN 分别有 4.9% 和 7%。CacheLib 后来加入了写缓冲:先把写入攒满一个 region 再刷盘,于是可以按低至 512B 的粒度对齐,把 CDN 的碎片从 7% 降到 2%。
- LOC 用 FIFO 而非 LRU,使写入是顺序的:设备层写放大从 1.5× 降到 1.05×,应用层写放大略有上升,净效果是每秒 NAND 写入减少 15%。
- SOC 无论对象多小都写 4KB,应用层写放大平均约 6.5×;随机写 4KB 页还带来 1.1×(Lookaside)到 1.4×(Storage)的设备层写放大。为达到这样的设备层写放大,闪存通常要超配 50%。SOC 的空间效率和闪存相对 DRAM 的低价抵消了这部分成本,但如何在保持性能的同时减少超配,仍是 Facebook 的一个开放问题。
准入策略。 默认的固定概率准入延长了闪存寿命,但随机拒绝对象也降低了命中率。CacheLib 还提供 reject-first 策略:一个对象前 次被 DRAM 淘汰时都拒绝。最近加入了一种类似 Flashield 的更高级策略,通过预测对象未来的热度做准入决策(附录 C)。它在 SocialGraph 上把闪存写入速率降低了 44%,命中率不降。
命中率。 DRAM 缓存最初用 LRU 的变体,后来部署基于 2Q 的策略带来了显著提升:SocialGraph 命中率提高 5 个百分点,CDN 提高 9 个百分点。
更大的提升来自大容量混合缓存的部署。需要海量容量的服务一般是两层结构:只用 DRAM 的 L1 把未命中转发给 DRAM + 闪存的 L2。对比 SocialGraph 的两种 L2 部署:纯 DRAM 的 L2 命中率 25%;混合缓存的 L2 容量是其 20 倍,命中率达到 60%,成本还低 25%。
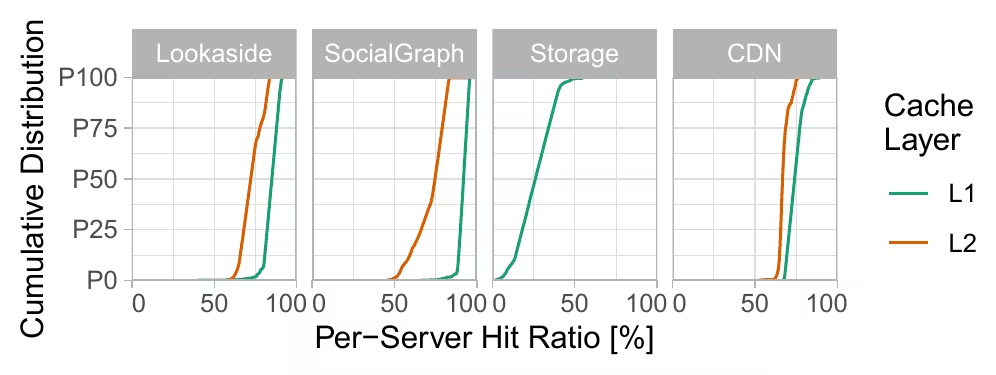
L1 的中位命中率从 75%(CDN)到 92%(SocialGraph),L2 从 67%(CDN)到 75%(SocialGraph),两层合计的命中率高达 95%~99%。
热重启的效果。
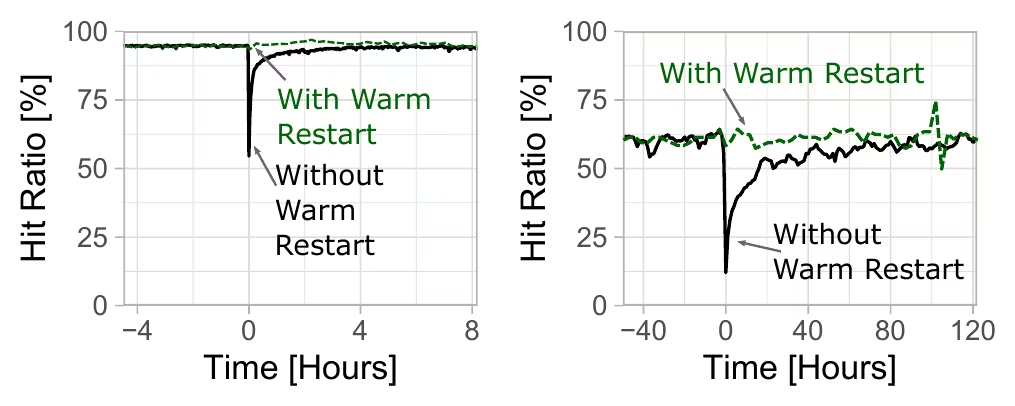
关闭热重启时,重启会让命中率骤降、再缓慢恢复。这对 L2 混合缓存尤其严重,大容量缓存要好几天才能"预热"回来。命中率的下跌会转化为后端的临时过载,而后端通常假设到达率相对稳定。
#6. 经验与讨论
新功能会被很多系统采用。 人们可能以为很多功能只适合少数服务,实际恰恰相反:为某个服务开发的功能经常被许多其他服务采用。比如混合缓存和高效的对象过期(TTL)都是 CacheLib 上线后才加的,如今混合缓存被五个大型用例使用;TTL 最初是为了在 look-aside 缓存中实现公平共享,后来 CDN 也用来定期刷新静态内容。当然不是每个系统都用所有功能——通用缓存引擎并不是"一刀切",而是在抽取共同功能的同时保留高度的定制能力。
性能改进惠及众多系统。 由于部署广泛,CacheLib 的一点小改进也会被放大。写论文期间 LOC 的索引换成了一种新的稀疏哈希表,CPU 降低 0.5%、内存不变。单个系统省 0.5% CPU 也许不值得投入开发,但对 Facebook 所有混合缓存都省 0.5%,就是巨大的资源节省。这正是通用引擎相对于专用系统的优势。
稳定性提高。 把各自为政的实现收敛到一个成熟、充分测试的平台上,减少了新系统需要引入生产环境的新代码,降低了事故风险;CacheLib 还内置了多年运维经验沉淀下来的稳定性机制。
没有哪个系统一家独大。 能不能只服务好少数几个用户就够了?按各系统使用的 DRAM 缓存总量统计,前十个用户占了 89%,但最大的两个也只占 25% 和 20%。所以 CacheLib 必须照顾到大量不同的用例,否则优化它的总体收益有限。
闪存缓存意味着范式转变。 有人会觉得命中率通常已经很高,加闪存容量没什么用。但高命中率不等于再加容量无益:工程师按"下一字节 DRAM 的边际成本 = 命中率提升的边际收益"来配置缓存,而闪存把额外容量的边际成本降低了一个数量级,不仅值得大幅扩容,还让原本只用 DRAM 不划算的新混合缓存变得划算。
此外,对多数系统来说,缓存命中的价值已经不只是延迟。经典观点认为缓存只有在降低平均访问时间时才值得,但这忽略了未命中的连锁效应:网络拥塞、后端负载、后端功耗。从这个角度看,闪存命中和 DRAM 命中一样有价值,尽管闪存要慢几个数量级。
CacheLib 并不总能带来性能提升。 第一版基于 CacheLib 的 CDN 系统就没能追上原来的专用系统——后者针对闪存实现了低写入速率的高级淘汰策略。测试中 CacheLib 版命中率低 10%,闪存写入速率高 20%。上线前,CacheLib 增加了两项优化:
- LOC 淘汰从纯 FIFO 扩展为带重新准入的策略,被淘汰的高频对象可以重新写回;
- 在 DRAM 和闪存之间加入写缓冲,减少 4KB 对齐带来的内部碎片(应用层写放大),并让写入更少、更大(降低设备层写放大)。
改进后的 LOC 命中率接近专用系统,闪存写入还少 10%。两项优化关闭时几乎没有开销,打开后也惠及了其他系统:Lookaside 的 P99 闪存读延迟下降 25%,闪存写入下降 2%。这说明了通用与专用之间的典型取舍:CacheLib 不一定一开始就满足每个用例,但专用系统需要的功能往往与 CacheLib 的设计并不矛盾;愿意花时间把它做进 CacheLib,就能获得全部功能,同时把优化输出给其他系统。
CacheLib 并不适用于所有场景。
- 一些广告服务需要缓存嵌套数据结构。为了控制内存使用、快速把 Item 从 DRAM 序列化到闪存,CacheLib 只支持能映射到扁平地址空间的数据结构,所以这些系统无法采用。
- RocksDB 想用 CacheLib 实现内部的页缓冲,但 CacheLib 的 C++ API 依赖构造/析构函数来对 ItemHandle 做引用计数,难以集成进 RocksDB 的 C 风格代码。反过来,自动引用计数的便利也正是 CacheLib 在 C++ 和 Rust 用例中被广泛采用的原因。
#7. 相关工作
生产缓存系统。 Akamai 的地理分布式 CDN、微软的 Web 缓存、亚马逊的聚合缓存、Facebook 的各个独立缓存系统都有文献记载,Twitter 和 Reddit 也常谈到它们基于开源系统的 DRAM 缓存。CacheLib 要解决的是这些系统所面临挑战的超集。
学术缓存系统。 学术界研究了高并发缓存、提高命中率等许多方面,Facebook 希望 CacheLib 成为一个便于评估和部署这些研究的平台。闪存缓存方面已有一些工作,CacheLib 借鉴了其中在闪存上做 FIFO 淘汰以减少写放大的思路,也包含了概率准入以及 Flashield 准入策略的变体。
CacheLib 支持动态缓存分区,但现有的分区策略研究在 Facebook 影响有限:分区可以消除命中率随容量变化的"性能悬崖",但悬崖在 Facebook 并不是主要问题;RobinHood 的分区方案在多个后端共享基础设施时受限,而 Facebook 正是这种情况;读取闪存上对象大小的开销太大,基于大小的分片在实践中也用不了。
#8. 结论
缓存是现代数据中心应用的重要组件。CacheLib 表明,构建一个能覆盖各种缓存场景的通用缓存引擎是可行的。作者希望 CacheLib 成为工业界和学术界最佳实践的汇聚点,未来值得探索的方向包括:更好的资源管理策略(淘汰、准入、内存管理),新硬件平台(FPGA 加速、非易失内存、ZNS SSD),以及新的应用特性(例如负缓存)。
#附录
#A. 查找顺序与延迟
CacheLib 的查找顺序是 DRAM → LOC → SOC。对象大小事先未知,所以 DRAM 未命中后不知道它在 LOC 还是 SOC,只能先查一个、未命中再查另一个。
以确定"对象不在该组件中"所需的时间为查找代价,假设 DRAM 访问约 100ns、闪存读约 16µs:
- DRAM:几次内存访问,约 500ns;
- LOC:DRAM 中既不存 key 也不存精确大小,靠 8B 哈希索引。没有哈希冲突时只需几次内存访问(含哈希计算约 1µs);冲突时要读一次闪存比较 key。按最小对象 2KB、1TB 闪存算,LOC 最多 5.36 亿个对象,8B 哈希冲突概率不到百万分之一,平均代价略高于 1µs;
- SOC:没有内存索引,先查每页的 Bloom filter(约 1µs),但 filter 很小,误判率约 10%,误判时要读一次闪存,平均代价。
平均访问时间为
其中 为查找代价, 为命中率。若把 SOC 和 LOC 的顺序对调,平均延迟会增加几微秒,所以 SOC 放在最后。
#B. DRAM 开销的细节
DRAM 缓存的开销定义为总内存占用与缓存的 key、value 大小之和的比值,见 5.2 节的表格,碎片和元数据大约各占一半。
LOC 用 8B 哈希,其中 4B 用来选择 B 树分段,不必存储;所以每个 Item 存 4B key 哈希、4B 闪存偏移,外加平均约 2.5B 的 B 树指针。对最小的 LOC 对象而言这是 0.61%,生产中只有 0.01%(Storage)到 0.1%(Lookaside)。
#C. 闪存的高级准入策略
如果把 DRAM 的所有淘汰都写进闪存,写入速率会比让闪存达到目标寿命的速率高 50%,所以准入策略对 CacheLib 的表现很重要。
Flashield 在对象经过混合缓存的 DRAM 部分时观察它,对象被淘汰时根据它在 DRAM 中被访问的次数决定是否写入闪存。问题是 Facebook 的对象在 DRAM 中停留的时间太短:很多对象如果放到闪存上会产生命中,但在 DRAM 里根本没被命中过。在一个 L2 Lookaside 缓存中,待准入的对象只有 14% 在 DRAM 中被读或写过。
为此 CacheLib 在对象的 DRAM 生命周期之外也收集特征:
- 用 6 个 Bloom filter,每个记录 1 小时的访问,共覆盖过去 6 小时。每小时重置最旧的一个用来记录接下来一小时。filter 按最大观测查询率配置为 0.02% 的误判率。用 Bloom filter 是为了省 DRAM,每个 key 存 8B 历史就太多了;
- 把预测目标从抽象的"flashiness"改为直接预测对象未来会被读多少次。
该策略在 SocialGraph 上训练并部署,与默认的固定概率准入相比,写入闪存的字节数少 44%,命中率不降。训练模型虽然麻烦,但显著延长了闪存设备的寿命。
#开源实现补充
论文发表时 CacheLib 尚未开源,2021 年开源后,代码里的名字和论文有一些对应关系,读源码时可以参考:
| 论文中的概念 | 开源代码中的对应 |
|---|---|
| DRAM 缓存整体 | CacheAllocator<CacheTrait>,如 LruAllocator、Lru2QAllocator、TinyLFUAllocator |
| 链式哈希表索引 | AccessContainer(默认 ChainedHashTable) |
| 每个 slab class 的淘汰策略 | MMContainer(MMLru、MM2Q、MMTinyLFU) |
| pool / slab class | MemoryPool / AllocationClass,底层由 SlabAllocator 管理 4MB slab |
| slab 再平衡 | PoolRebalancer + 可插拔策略(如按 LRU 尾部年龄、按每 slab 命中数等) |
| 动态内存调整 | MemoryMonitor |
| 闪存缓存 | Navy 引擎:LOC 对应 BlockCache,SOC 对应 BigHash |
几个和内存分配器相关、值得留意的实现细节:
- 压缩指针:表 1 里的 LRU 前后指针、哈希链指针都只占 4B,是因为它们存的不是虚拟地址,而是
CompressedPtr:把指针编码成"slab 编号 + slab 内的分配序号"。slab 固定 4MB 且 Item 大小有下限,slab 内的对象数是有限的,两者拼起来塞进 32 位即可。这和 mimalloc 靠 segment 对齐做指针掩码找元数据一样,都是"先把地址空间规整化,再用位运算压缩元数据"的套路。也正因为用的是相对编号而非绝对地址,共享内存在新进程里映射到别的地址也不影响,热重启才得以成立。 - 侵入式容器:LRU 链表节点和哈希链节点直接嵌在 Item 头里(即那 31B),没有额外分配,这和 Linux 内核的
list_head是同一种做法。 - slab 搬迁就是"跨 size class 的内存回收":通用 malloc 遇到某个 size class 空闲而另一个吃紧时,只能等 slab/页整体变空再还给页堆;CacheLib 则可以主动淘汰一个 slab 里的全部 Item,把整块 4MB 腾出来给别的 class。因为是缓存,数据可以丢,这在 malloc 里是做不到的。
后续研究方面,同一个 CMU 团队在 SOSP’21 发表的 Kangaroo 专门改进了闪存上的小对象缓存,正是针对上文 SOC 那 6.5× 的应用层写放大,用一个小的日志结构缓存在前面攒批再写入组相联的主体部分。
#读后感
- 这篇论文前半部分的负载特征分析可能比 CacheLib 本身更有价值: 远小于 0.9、热度每小时大换血、对象尺寸跨七个数量级、到达率远比泊松突发——几乎把常见 benchmark 的默认假设逐条推翻了。
- 整个设计反复出现一个主题:按对象尺寸分而治之。<64B 走 compact cache,64B~4MB 走 slab,>4MB 走链式 Item;闪存上 <2KB 走 SOC,≥2KB 走 LOC。每一档都在压同一个指标:每对象的 DRAM 开销。这和内存分配器"小对象按 size class、大对象直接 mmap"的分档是一个道理。
- 闪存缓存的约束让很多 DRAM 上理所当然的做法失效了:命中时不能更新状态(所以 SOC 只能 FIFO),不能随机写(所以 LOC 按 region 顺序擦写),不能想写就写(所以要准入策略)。写放大被拆成应用层和设备层两部分来分析,这个视角很清晰。
- slab class 边界只能手调,论文坦承没有好的算法,这是一个很实在的开放问题。
#参考资料
- Benjamin Berg et al. The CacheLib Caching Engine: Design and Experiences at Scale. OSDI 2020. https://www.usenix.org/conference/osdi20/presentation/berg
- CacheLib 官网与文档:https://cachelib.org
- 源码:https://github.com/facebook/CacheLib
- Rajesh Nishtala et al. Scaling Memcache at Facebook. NSDI 2013.
- Assaf Eisenman et al. Flashield: a Hybrid Key-value Cache that Controls Flash Write Amplification. NSDI 2019.
- Sara McAllister et al. Kangaroo: Caching Billions of Tiny Objects on Flash. SOSP 2021.